Un clúster de Kubernetes gestionado en cualquiera de los proveedores grandes arranca en torno a los 70 dólares al mes solo por el plano de control, antes de levantar un solo contenedor con tu aplicación dentro. A eso hay que sumarle los nodos, el balanceador y el almacenamiento.
Ese número es el punto de partida honesto de esta comparación, porque la orquestación casi nunca se evalúa por lo que cuesta sostenerla, sino por lo que promete resolver.
Y lo que promete es real: reinicia lo que se cae, reparte carga entre máquinas, despliega sin cortar el servicio. La pregunta es si hoy tienes los problemas que eso resuelve.
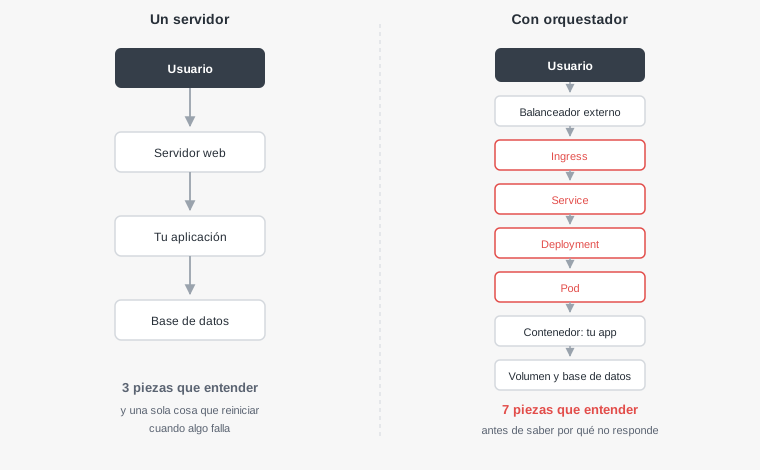
Qué resuelve un orquestador, dicho sin marketing
Un orquestador hace tres cosas que a mano cuestan trabajo, y conviene nombrarlas con precisión porque cada una tiene alternativas mucho más baratas.
Reinicia lo que muere. Si el proceso se cae, lo vuelve a levantar sin que nadie intervenga. Un gestor de procesos del sistema hace lo mismo en una sola máquina, con una línea de configuración.
Reparte réplicas entre máquinas. Si una máquina se apaga, mueve esas réplicas a otra. Esto sí necesita varias máquinas para tener sentido; con una sola no hay nada que repartir.
Despliega sin cortar. Levanta la versión nueva, comprueba que responde, y recién entonces retira la vieja. Un servidor web con dos procesos alternados consigue algo equivalente, con bastante menos maquinaria.
La diferencia no está en si esas tres cosas son valiosas, sino en cuántas máquinas y cuántos servicios tienes. Con una máquina y un servicio, las tres tienen soluciones que caben en un archivo de configuración.
Lo que se paga, y no es solo la factura
El costo mensual es el más visible y el menos importante. Los otros dos se pagan en tiempo.
El primero es el vocabulario. Para desplegar un contenedor hay que entender pod, deployment, service, ingress, namespace y configmap, y saber cuál de ellos es el que está mal cuando la aplicación no responde. Eso no es complejidad accidental: cada objeto existe por un motivo. Pero es conocimiento que hay que adquirir antes de poder diagnosticar nada.
El segundo es que ese conocimiento no se comparte con nadie más de tu proyecto si trabajas solo. Cuando el clúster falla un domingo, la persona que tiene que entender los siete objetos del diagrama eres tú.
No es cuántos usuarios tienes ni cuánto tráfico esperas. Es cuántas máquinas necesitas mantener.
Con una, un orquestador es una capa de abstracción sobre algo que no hace falta abstraer. A partir de tres o cuatro, con despliegues frecuentes, empieza a devolver más de lo que cuesta.
El escalón que casi nadie menciona
La comparación suele presentarse como si hubiera dos opciones: servidor manual o Kubernetes. En medio hay un escalón que resuelve la mayoría de los casos y que rara vez aparece en la propuesta.
Docker Compose sobre una sola máquina da contenedores, reinicio automático, variables de entorno separadas del código y despliegues reproducibles. Todo lo que la mayoría de los proyectos pequeños necesita de verdad.
services:
  app:
    image: mi-app:1.4.2
    restart: unless-stopped        # se vuelve a levantar si muere
    env_file: .env
    depends_on: [db]
  db:
    image: postgres:16
    restart: unless-stopped
    volumes:
      - datos:/var/lib/postgresql/data

volumes:
  datos:
Doce líneas, una máquina, cero costo de plano de control. No reparte carga entre servidores ni sobrevive a la caída de la máquina, y para muchos proyectos eso está perfectamente bien: si el servidor se apaga, se levanta otro y se corre el mismo archivo.
El salto a un orquestador se justifica cuando esa última frase deja de ser aceptable, es decir, cuando el tiempo que tardas en levantar otra máquina a mano cuesta más que mantener el clúster.
El estado, que es donde todo se complica
Los contenedores parten de una idea sencilla: se crean y se destruyen sin que importe cuál era cuál. Esa propiedad es la que permite reiniciar, mover y replicar sin pensar.
Y es también la que choca de frente con cualquier cosa que necesite recordar algo. Un contenedor que muere se lleva consigo todo lo que había escrito dentro.
Las tres cosas que más se pierden por no haber pensado en esto, y que funcionan perfectamente en desarrollo:
- Archivos subidos por usuarios. Guardados en el disco del contenedor, desaparecen en el siguiente despliegue. Y con varias réplicas es peor: el archivo aterriza en una y las otras no lo ven, así que la mitad de las descargas fallan.
- Sesiones en memoria. Con dos réplicas, el usuario inicia sesión contra una y la siguiente petición llega a la otra, que no lo conoce. El síntoma es que la sesión se cae sola cada dos por tres.
- Trabajos programados. Si el proceso que envía correos corre dentro de la aplicación y hay tres réplicas, se envía tres veces.
Ninguno es un problema del orquestador: son consecuencias de replicar algo que asumía ser único. Pero aparecen justo cuando adoptas orquestación, y por eso conviene saberlo antes.
Las soluciones son conocidas y tienen un costo: los archivos van a un almacenamiento externo, las sesiones a un almacén compartido, y los trabajos programados salen de la aplicación a un componente que corre una sola vez. Cada una es una pieza más.
La base de datos merece su propia decisión
Hay una pregunta que aparece sola cuando se adopta un orquestador: si todo va en contenedores, ¿la base de datos también?
Técnicamente se puede, y los orquestadores tienen mecanismos pensados para eso, con almacenamiento persistente e identidad estable por réplica. La pregunta no es si se puede, es si te conviene.
Pasas a ser responsable de copias de seguridad, actualizaciones de versión, réplicas y recuperación ante un fallo del disco, todo ello dentro de un entorno donde los contenedores están pensados para ser reemplazables.
Un servicio gestionado te cobra por eso mismo y lo hace un equipo dedicado. Para un proyecto pequeño, esa factura suele ser más barata que la noche en que hay que restaurar a mano.
La combinación que mejor funciona en proyectos chicos es mixta: la aplicación en contenedores, porque es lo que cambia todas las semanas, y la base de datos gestionada fuera, porque es lo que no quieres tocar.
Esto además simplifica el paso siguiente, porque la parte con estado deja de moverse cuando cambias de plataforma.
Empaqueta antes de orquestar
Hay un orden que conviene respetar, y es el que separa el valor del costo. Empaquetar la aplicación en una imagen aporta desde el primer día, aunque nunca llegues a orquestar nada.
Una imagen resuelve el problema más viejo del despliegue: que el entorno de tu máquina y el del servidor no son iguales. Con una imagen, lo que probaste es exactamente lo que corre.
# Construir una vez, con una etiqueta que identifique la versión
docker build -t mi-app:1.4.2 .

# La misma imagen en pruebas y en producción: nada se recompila
docker push registro.ejemplo.com/mi-app:1.4.2
Ese detalle de la etiqueta importa más de lo que parece. Desplegar con la etiqueta latest hace imposible saber qué versión está corriendo y, sobre todo, volver a la anterior cuando algo falla. Con una versión explícita, revertir es desplegar el número de ayer.
Con la aplicación ya empaquetada, la decisión de orquestación se vuelve reversible: pasar de una máquina con Compose a Swarm o a Kubernetes cambia cómo se despliega lo mismo, no lo que despliegas. Y si el proyecto nunca crece hasta necesitarlo, no perdiste nada, porque la parte que hiciste era la que aportaba valor igual.
Tres señales de que ya toca orquestar
- Tienes más de tres máquinas y las administras a mano. Ahí el trabajo repetido ya supera el costo de aprender la herramienta.
- Varios equipos despliegan servicios distintos. El orquestador se convierte en el contrato común entre ellos.
- Necesitas escalar y reducir según la carga, varias veces al día. Hacerlo a mano deja de ser viable.
Si ninguna aplica, adoptar orquestación es adelantar un costo cierto contra un beneficio que llegará, si acaso, más adelante. Y la migración desde Compose hacia un orquestador es bastante directa: los contenedores ya están hechos, que es la parte que de verdad cuesta.