Hay equipos que despliegan varias veces al día sin pensarlo y equipos que tratan cada despliegue como una operación de riesgo, un viernes nunca, con alguien de guardia y la esperanza de que no haya que volver atrás. La diferencia rara vez está en la calidad del código. Está en cuánto cuesta equivocarse.
Si un despliegue malo afecta a todos los usuarios de golpe y deshacerlo lleva media hora, cada despliegue da miedo. Si afecta a unos pocos y se deshace en segundos, deja de darlo. Las tres estrategias de este artículo son formas de conseguir lo segundo.
Integración continua y entrega continua
Conviene separar primero dos términos que viajan juntos y significan cosas distintas.
La integración continua es la práctica de que cada cambio que se sube pase automáticamente por una batería de comprobaciones: que compila, que las pruebas pasan, que el formato es correcto. Su objetivo es detectar un problema minutos después de introducirlo, no semanas.
La entrega continua es que cualquier cambio que supera esas comprobaciones esté listo para desplegarse en cualquier momento, y el despliegue continuo es que se despliegue solo, sin intervención humana.
Las estrategias de este artículo pertenecen a la segunda parte: no deciden si el código es correcto, sino cómo se limita el daño cuando algo incorrecto llega de todos modos a producción, que tarde o temprano ocurre.
Una base que conviene tener antes
Ninguna estrategia de despliegue compensa la ausencia de una integración continua mínima, y montarla es más sencillo de lo que suele parecer.
# .github/workflows/ci.yml : comprobaciones en cada cambio
name: ci
on: [push, pull_request]
jobs:
  comprobar:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with: { node-version-file: .nvmrc }
      - run: npm ci
      - run: npm run lint
      - run: npm test
Tres pasos, formato, análisis y pruebas, cubren la mayor parte del valor. Lo importante es que un cambio que no los supera no se pueda fusionar, porque una comprobación que se puede ignorar acaba ignorándose.
Tres formas de sacar una versión nueva
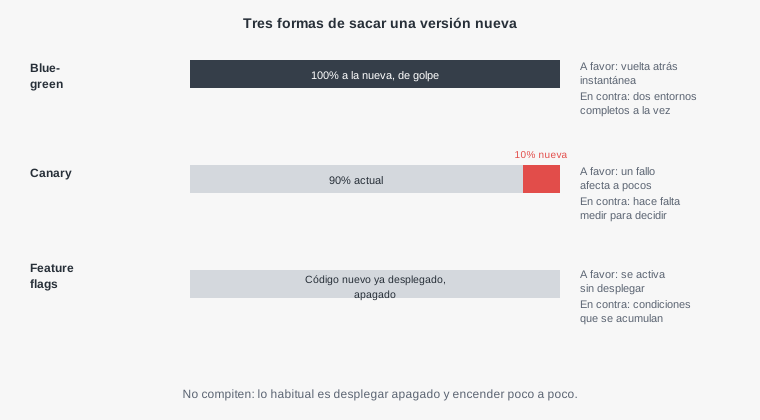
Las tres atacan el mismo problema desde ángulos distintos. Blue-green hace que volver atrás sea instantáneo. Canary hace que un fallo afecte a pocos. Los feature flags separan desplegar de activar, que resulta ser la idea más potente de las tres.
Blue-green: dos entornos y un interruptor
Se mantienen dos entornos de producción idénticos. Uno, el azul, atiende a los usuarios. La versión nueva se despliega en el otro, el verde, se comprueba sin tráfico real, y cuando está lista se cambia el enrutado para que todo el tráfico vaya al verde.
La ventaja principal es que volver atrás no requiere desplegar nada: basta con devolver el enrutado al azul, que sigue ahí intacto. Un despliegue malo se deshace en segundos.
El coste es mantener dos entornos completos, al menos durante la transición, y hay un punto que casi siempre se pasa por alto: la base de datos no se duplica. Ambos entornos comparten los datos, así que un cambio de esquema tiene que funcionar con las dos versiones del código a la vez. Es exactamente la técnica de expandir y contraer que vimos al hablar de migraciones, y sin ella blue-green no protege de nada que toque la base.
# nginx: el cambio de azul a verde es cambiar a dónde apunta el upstream
# /etc/nginx/conf.d/app.conf incluye:  include /etc/nginx/activo.conf;
echo "upstream app { server 127.0.0.1:8082; }" | sudo tee /etc/nginx/activo.conf   # verde
sudo nginx -t && sudo systemctl reload nginx

# Volver atrás: apuntar de nuevo al azul
echo "upstream app { server 127.0.0.1:8081; }" | sudo tee /etc/nginx/activo.conf
sudo nginx -t && sudo systemctl reload nginx
Canary: probar con una parte de los usuarios
En lugar de mover todo el tráfico de golpe, se envía a la versión nueva una fracción pequeña, se observa, y se va aumentando si todo va bien.
La idea viene de los canarios que se bajaban a las minas para detectar gases: si algo va mal, afecta primero a unos pocos y da tiempo a reaccionar antes de que afecte a todos.
La condición para que funcione es tener con qué decidir. Enviar el diez por ciento del tráfico a una versión nueva no sirve de nada si nadie compara su tasa de errores y su latencia con la de la versión actual. Sin métricas separadas por versión, un canary es solo un despliegue más lento.
# nginx: repartir el tráfico por pesos entre la versión actual y la nueva
upstream app {
    server 127.0.0.1:8081 weight=9;   # versión actual, 90%
    server 127.0.0.1:8082 weight=1;   # versión nueva, 10%
}

# Comparar la tasa de errores de cada versión en los registros
jq -r 'select(.status>=500) | .version' app.log | sort | uniq -c
El caso ideal automatiza la decisión: si la versión nueva supera cierto umbral de errores respecto a la actual, se retira sola. Pero incluso hecho a mano, con una comparación cada pocos minutos, reduce mucho el alcance de un fallo.
Feature flags: desplegar no es activar
La tercera estrategia cambia el planteamiento. El código de la funcionalidad nueva se despliega a producción, pero detrás de una condición que la mantiene apagada. Se activa después, sin desplegar, cambiando un valor.
if ($flags->activo('nuevo_checkout', usuario: $usuario)) {
    return $this->checkoutNuevo($carrito);
}
return $this->checkoutActual($carrito);
Eso separa dos decisiones que normalmente van unidas. Desplegar pasa a ser una operación técnica sin riesgo visible para el usuario, que se puede hacer a cualquier hora. Activar pasa a ser una decisión de producto, que se puede tomar para un grupo concreto, un porcentaje o un cliente de prueba.
Y volver atrás es apagar la condición, que es todavía más rápido que un cambio de enrutado y no depende de infraestructura.
Encima, combina con las otras dos: una funcionalidad se puede activar solo para el equipo interno, después para un cinco por ciento de usuarios y finalmente para todos, que es un canary sin tocar el enrutado.
El coste escondido de las flags
Las flags tienen un problema que no se nota al añadirlas y se nota mucho al cabo de un año: se acumulan.
Cada flag es una bifurcación en el código. Dos flags independientes producen cuatro combinaciones posibles; diez producen más de mil, y nadie ha probado la mayoría. Cuando una flag lleva meses activada para todos, el código antiguo sigue ahí, sin usarse y sin que nadie se atreva a borrarlo.
La disciplina que lo evita es tratar cada flag como algo con fecha de caducidad. Al crearla se anota para qué es y cuándo se retirará, y cuando la funcionalidad está estable para todos, se elimina la condición y el código antiguo en el mismo cambio.
# Inventario de flags en el código, para revisar cuáles ya deberían retirarse
grep -rhoE "activo\('[a-z_]+'" src/ | sort | uniq -c | sort -rn
Las tres, comparadas
| Blue-green | Canary | Feature flags | |
|---|---|---|---|
| Usuarios expuestos a un fallo | Todos, durante segundos | Una fracción | Los que tú elijas |
| Cómo se vuelve atrás | Cambiar enrutado | Retirar la versión | Apagar la condición |
| Infraestructura necesaria | Dos entornos | Reparto de tráfico | Ninguna especial |
| Necesita métricas por versión | No | Imprescindible | Útil |
| Cambios de esquema | Deben ser compatibles | Deben ser compatibles | Deben ser compatibles |
| Coste a largo plazo | Entorno duplicado | Operación | Código que se acumula |
| Dónde encaja | Cambios de infraestructura | Cambios de rendimiento o riesgo | Funcionalidades de producto |
La fila de los cambios de esquema es la que iguala a las tres, y la que más incidentes explica: ninguna estrategia de despliegue protege de una migración que rompe la versión anterior, porque durante un rato conviven siempre las dos.
Por dónde empezar en un proyecto pequeño
Blue-green y canary exigen infraestructura que un proyecto pequeño probablemente no tiene, y no hace falta empezar por ahí.
El primer paso, el que más rinde, es que desplegar sea un solo comando reproducible y que volver a la versión anterior también lo sea. Si hoy desplegar consiste en subir archivos a mano, eso es lo primero que hay que resolver, antes que cualquier estrategia.
# Desplegar y poder volver atrás: cada versión en su carpeta, un enlace a la activa
VERSION=$(git rev-parse --short HEAD)
rsync -a --delete ./dist/ servidor:/srv/app/releases/$VERSION/
ssh servidor "ln -sfn /srv/app/releases/$VERSION /srv/app/actual && sudo systemctl reload app"

# Volver a la versión anterior
ssh servidor 'ln -sfn $(ls -dt /srv/app/releases/* | sed -n 2p) /srv/app/actual && sudo systemctl reload app'
El segundo paso son las feature flags para las funcionalidades con más riesgo, que no requieren infraestructura: una tabla o un archivo de configuración bastan para empezar.
Blue-green y canary llegan después, cuando el tráfico hace que un fallo de treinta segundos para todos sea demasiado caro.
Qué se le escapa a una IA con esto
Pedir un proceso de despliegue produce con frecuencia un flujo que compila, prueba y sube, sin ningún mecanismo para volver atrás. Funciona el día que todo va bien, que es el día que no importa.
Cuando se piden feature flags, el código generado añade la condición y casi nunca contempla retirarla, así que las flags se acumulan desde el primer día. Y en blue-green y canary, el patrón que se repite es ignorar la base de datos compartida, proponiendo el cambio de enrutado sin decir nada de la compatibilidad del esquema.
Las frases que cambian la respuesta son pedir explícitamente el comando para volver a la versión anterior, preguntar qué pasa con la base de datos durante la convivencia de versiones, y pedir que cada flag tenga una forma documentada de retirarse.
Y conviene probar la vuelta atrás antes de necesitarla. Un procedimiento de reversión que nunca se ejecutó es, a efectos prácticos, un procedimiento que no existe.