La primera vez que un proyecto atiende a más de un cliente, la decisión sobre cómo separar sus datos se toma en cinco minutos y se vive durante años. Casi siempre se resuelve añadiendo una columna con el identificador del cliente a cada tabla, que es la opción correcta para empezar y la que más cuidado exige.
Lo que hace delicada esa elección no es el modelo de datos: es que a partir de ahí, cada consulta que se escriba tiene que acordarse de filtrar. Y con el tiempo, alguien va a olvidarlo.
Tres formas de separar a tus clientes
Las opciones establecidas son tres, y se ordenan por cuánto aíslan y cuánto cuestan de operar.
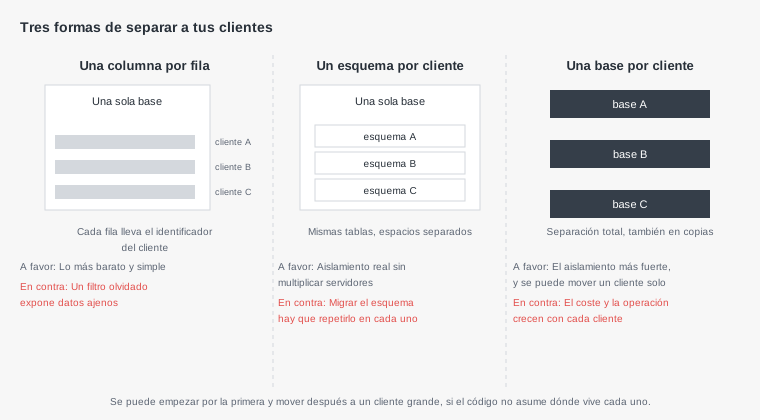
La diferencia de fondo está en dónde vive la garantía de separación. En la primera, vive en el código: si el filtro está, hay separación; si falta, no. En las otras dos vive en la infraestructura, que no se olvida.
Esa es la razón por la que la primera opción, siendo la más común y la más barata, es también la que produce las filtraciones más embarazosas: no hace falta un ataque, basta con una consulta mal escrita.
Por qué casi todos empiezan por la columna
Conviene decir que la opción simple es la correcta para la mayoría, y no un atajo que haya que evitar.
Con una columna por fila hay una sola base que respaldar, una sola migración que aplicar, una sola conexión que gestionar y un coste que no crece con cada cliente nuevo. Dar de alta a alguien es insertar una fila.
Además, las consultas que cruzan clientes, como saber cuántos pedidos hubo en total este mes, son triviales. En los otros dos modelos, esa misma pregunta exige recorrer todas las bases y sumar.
El problema no es el modelo: es que su seguridad depende de que nadie se equivoque nunca. Y eso se puede resolver, que es de lo que trata la siguiente sección.
Que el filtro no dependa de la memoria
Hay tres formas de conseguir que el aislamiento no se apoye en recordar escribir una condición, ordenadas de menos a más garantía.
La primera es concentrar el acceso: que ninguna parte del código consulte las tablas directamente, sino a través de un repositorio que ya aplica el filtro. Ayuda mucho y sigue dependiendo de que nadie salte esa capa.
La segunda es un ámbito global en la capa de datos, que la mayoría de los marcos de trabajo ofrecen: una condición que se añade automáticamente a toda consulta sobre esas tablas.
La tercera, la única que no se puede olvidar, es que lo imponga la propia base de datos.
-- La base filtra por sí misma, aunque la consulta no lo pida
ALTER TABLE pedidos ENABLE ROW LEVEL SECURITY;

CREATE POLICY pedidos_por_cliente ON pedidos
    USING (cliente_id = current_setting('app.cliente_id')::bigint);

-- La aplicación fija el cliente al abrir la conexión o la transacción
SET app.cliente_id = '412';

-- A partir de aquí, esto devuelve solo los del cliente 412
SELECT * FROM pedidos;
Con eso, una consulta que olvide el filtro devuelve las filas correctas igualmente. Es la diferencia entre una protección que depende de la disciplina y una que depende del motor.
Conviene saber que esta protección se salta si la aplicación se conecta con el usuario propietario de las tablas, porque ese usuario ignora las políticas. La conexión de la aplicación debe usar un usuario sin ese privilegio, y eso se comprueba una vez.
La prueba que hay que hacer sí o sí
Antes de dar por buena cualquier implementación, hay una comprobación que lleva dos minutos y que revela el fallo más común.
# Con la sesión del cliente A, pedir un recurso del cliente B
TOKEN_A="..."   # sesión iniciada como cliente A
ID_DE_B=8841    # un identificador que pertenece al cliente B

curl -s -o /dev/null -w '%{http_code}\n' \
  -H "Authorization: Bearer $TOKEN_A" \
  https://api.ejemplo.com/pedidos/$ID_DE_B
# Debe responder 404, nunca 200 ni 403
El código correcto es 404 y no 403, porque un 403 confirma que ese identificador existe, lo que ya es información que no le corresponde. Para el cliente A, los datos de B simplemente no existen.
Conviene hacer esa prueba sobre cada tipo de recurso, y dejarla escrita como prueba automática. Es la clase de comprobación que vale por diez revisiones de código, porque no depende de leer nada.
Cuándo dar el salto al esquema o a la base propia
Hay cuatro motivos que justifican el cambio, y ninguno es que el proyecto haya crecido en general.
- Un requisito contractual o legal de que los datos de cierto cliente estén separados o residan en un país concreto.
- Un cliente desproporcionado cuyo volumen degrada el rendimiento de los demás, y que conviene mover a su propio sitio.
- Necesidades de recuperación distintas: poder restaurar los datos de un cliente sin tocar los del resto, que con una base compartida es incómodo.
- Personalización profunda del esquema para un cliente concreto, aunque esto suele ser señal de un problema de producto antes que de arquitectura.
El primero es el que más veces decide de verdad, y suele llegar con el primer cliente grande. Por eso conviene que el código esté preparado para que un cliente pueda vivir en otro sitio, aunque hoy vivan todos juntos.
Diseñar para poder mover a un cliente
La precaución que hace reversible esta decisión es sencilla y hay que tomarla antes de necesitarla.
El código no debe asumir dónde viven los datos de un cliente. Si la conexión a la base se obtiene de una función que recibe el identificador del cliente, mover a uno es cambiar una fila de configuración. Si la conexión está fijada en la configuración global, mover a uno es un proyecto.
Conviene también que los identificadores no sean secuenciales compartidos. Si el pedido número mil de un cliente y el del siguiente comparten numeración global, separar las bases obliga a renumerar o a convivir con huecos.
Y conviene que el identificador del cliente se resuelva en un solo lugar, a partir de la sesión, y no se acepte nunca como parámetro de la petición. Aceptarlo del cliente es el equivalente a dejar que cada usuario diga a qué empresa pertenece.
Las migraciones cuando hay varios esquemas
Si se elige el modelo de un esquema por cliente, aparece un trabajo nuevo que conviene resolver desde el primer día: aplicar cada cambio de esquema a todos.
# Aplicar una migración a todos los esquemas de clientes
for esquema in $(psql -tAc "SELECT nombre FROM clientes"); do
  echo "aplicando en $esquema"
  psql -v ON_ERROR_STOP=1 -c "SET search_path TO $esquema" \
       -f migraciones/004_pedidos_agregar_estado.sql \
    || { echo "FALLO en $esquema"; break; }
done
La opción que detiene el proceso ante el primer error es importante: sin ella, una migración puede aplicarse a la mitad de los clientes y dejar el sistema en un estado donde el código nuevo funciona para unos y falla para otros.
Conviene además guardar en qué versión de esquema está cada cliente, para poder responder esa pregunta sin inspeccionar las tablas. Es lo que permite reintentar solo los que fallaron.
Lo que hay que separar además de las filas
La conversación se centra en la base de datos, y hay tres cosas más que también tienen dueño.
Los archivos subidos. Guardarlos en una ruta que incluya el identificador del cliente evita el caso, nada teórico, de servir el documento de uno a otro por un identificador adivinable.
Las cachés. Una clave de caché que no incluya el cliente sirve datos cruzados, y ese fallo es especialmente difícil de reproducir porque depende del orden de las peticiones.
Los trabajos en segundo plano. Una tarea encolada lleva consigo de qué cliente es, y al ejecutarse tiene que restablecer ese contexto. Es un punto donde el filtro automático de la capa web no aplica, porque no hay sesión.
Ese último caso es el hueco más frecuente en implementaciones por lo demás correctas: todo está protegido salvo los procesos que corren fuera de una petición.
Qué se le escapa a una IA con esto
Pedir una aplicación para varios clientes produce, con bastante fiabilidad, el modelo de columna por fila con el filtro escrito a mano en cada consulta. Funciona y deja la separación dependiendo de que nadie lo olvide.
Lo que falta casi siempre es la protección estructural: ni ámbito global en la capa de datos ni políticas en la base. Y falta también el caso de los trabajos en segundo plano y el de las claves de caché, porque son los que no aparecen al probar la pantalla.
Hay además un patrón concreto que conviene vigilar: que el identificador del cliente se acepte como parámetro de la petición en lugar de deducirse de la sesión. Es cómodo al programar y equivale a no tener separación ninguna.
Las frases que cambian la respuesta son pedir que el filtro lo imponga la base de datos, que el identificador del cliente se resuelva solo desde la sesión y que las tareas en segundo plano restablezcan el contexto. Y después, la prueba de los dos clientes, que es lo único que confirma que todo lo anterior funciona.