Todo proyecto empieza depurando con la instrucción más simple que existe: imprimir algo en la consola. Funciona de maravilla mientras hay un proceso, un desarrollador y el problema ocurre delante de la pantalla.
Deja de funcionar el primer día que un usuario reporta un error que ocurrió ayer, en producción, en una de tres instancias, mezclado con cuarenta mil líneas más. Ahí se descubre que imprimir texto no es lo mismo que registrar, y que la diferencia importa exactamente cuando más prisa hay.
En esta guía ya aparecieron los registros dos veces: el artículo sobre auditoría trata qué hay que registrar para reconstruir quién hizo qué, y el de monitoreo trata cuándo avisar. Este va de la parte que ambos dan por hecha: cómo se escriben para que sirvan.
Por qué el texto libre no escala
El problema no es el volumen en sí, sino que un mensaje escrito para leerlo una persona no se puede consultar.
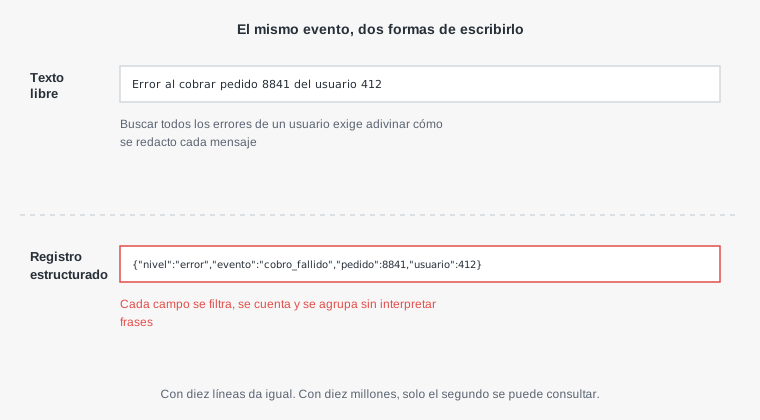
Con texto libre, encontrar todos los errores del usuario 412 obliga a buscar el número y rezar para que aparezca siempre igual. Basta con que otro desarrollador escriba cliente 412 en lugar de usuario 412 para que la mitad de los casos no aparezcan.
Con un registro estructurado, esa búsqueda es un filtro por un campo. Y además se pueden hacer preguntas que el texto no permite: cuántos cobros fallaron esta hora, qué usuarios concentran los errores, qué evento creció respecto a ayer.
Qué es un registro estructurado
La idea es escribir cada evento como un objeto con campos, normalmente en formato JSON y una línea por evento, en lugar de como una frase.
{"ts":"2026-09-15T14:32:08.412Z","nivel":"error","evento":"cobro_fallido",
 "servicio":"pagos","traza":"a3f2c9e1","usuario":412,"pedido":8841,
 "importe":49.90,"motivo":"tarjeta_rechazada","duracion_ms":1840}
Hay tres reglas que convierten eso en algo útil y no en un JSON desordenado. La primera: el nombre del evento es fijo y describe lo que pasó, no una frase variable. La segunda: los datos variables van en campos propios, nunca incrustados en el mensaje. La tercera: los nombres de los campos son los mismos en todo el sistema; si un servicio escribe usuario y otro user_id, cruzarlos exige recordarlo en el peor momento.
Consultarlos sin ninguna herramienta especial
Una ventaja poco valorada del formato de una línea por evento es que se puede explorar desde la terminal, sin montar nada.
# Todos los errores del usuario 412
jq -c 'select(.nivel=="error" and .usuario==412)' app.log

# Cuántos eventos de cada tipo hubo, ordenados
jq -r '.evento' app.log | sort | uniq -c | sort -rn | head

# Cobros fallidos agrupados por motivo
jq -r 'select(.evento=="cobro_fallido") | .motivo' app.log | sort | uniq -c

# Las diez peticiones más lentas
jq -c 'select(.duracion_ms) | {evento, duracion_ms, traza}' app.log \
  | jq -s 'sort_by(-.duracion_ms) | .[:10]'
Con esos cuatro comandos se responde la mayoría de las preguntas de un incidente en un proyecto pequeño, antes de plantearse cualquier plataforma de registros.
Los niveles, y para qué sirve cada uno
Los niveles de registro existen para poder filtrar, y solo sirven si se usan con un criterio consistente. El más útil es preguntarse quién tiene que hacer algo cuando aparece la línea.
- error: algo falló y requiere atención. Si una línea de error no exige que alguien actúe, está en el nivel equivocado.
- warn: algo raro que el sistema resolvió, pero que conviene revisar si se repite: un reintento que funcionó, un valor por defecto aplicado.
- info: hechos normales del negocio que interesa poder reconstruir: un pedido creado, un usuario registrado.
- debug: detalle para diagnosticar, desactivado en producción salvo cuando se investiga algo concreto.
El error más frecuente es registrar como error cosas que son normales, como un usuario que introduce una contraseña incorrecta. Cuando el nivel de error se llena de ruido, los errores de verdad dejan de verse, que es el mismo problema de las alertas que se ignoran.
El identificador que une todo
De todos los campos, hay uno que multiplica el valor de los demás: un identificador único por petición, que aparece en todas las líneas que esa petición genera.
Sin él, una petición que pasó por el controlador, el servicio de pagos y la base de datos deja tres líneas sueltas mezcladas con miles de otras, y reconstruir qué pasó exige cruzar marcas de tiempo a mano. Con él, basta con filtrar por un valor.
// Node: generar el identificador al entrar y propagarlo a todos los registros
import { randomUUID } from 'node:crypto';
import pino from 'pino';
const log = pino();

app.use((req, res, next) => {
  req.traza = req.headers['x-request-id'] ?? randomUUID();
  req.log = log.child({ traza: req.traza });      // todas sus líneas lo llevan
  res.setHeader('x-request-id', req.traza);        // se devuelve al cliente
  next();
});
Devolverlo en la respuesta tiene un beneficio práctico enorme: cuando un usuario reporta un error, puede dar ese identificador, y encontrar todo lo que ocurrió en su petición pasa a ser una búsqueda de un segundo.
Y si esa petición llama a otros servicios, el identificador tiene que viajar en la cabecera de la llamada. Es el primer paso hacia el trazado distribuido, que se trata en el siguiente artículo.
Lo que nunca debe acabar en un registro
Estructurar los registros hace más fácil un error concreto: volcar un objeto entero en un campo, con todo lo que contenga.
Registrar el cuerpo de una petición de inicio de sesión guarda la contraseña. Registrar el objeto de usuario completo guarda su correo, su teléfono y quizá su dirección. Registrar las cabeceras guarda el token de sesión, que da acceso inmediato a quien lea el archivo.
La protección que funciona no es la disciplina sino una lista de campos que se enmascaran automáticamente antes de escribir. Casi todas las librerías de registro lo permiten:
const log = pino({
  redact: {
    paths: ['password', '*.password', 'req.headers.authorization',
            'req.headers.cookie', 'tarjeta', '*.token'],
    censor: '[oculto]',
  },
});
El artículo sobre auditoría desarrolla qué datos no deben registrarse nunca y por qué; aquí basta con la regla operativa: el enmascarado va en la configuración, no en la memoria de cada persona.
Escribir en la salida estándar, no en archivos
Hay una decisión de diseño que simplifica mucho la operación y que conviene tomar desde el principio: la aplicación no debería gestionar archivos de registro.
Si la aplicación escribe sus propios archivos, alguien tiene que rotarlos para que no llenen el disco, decidir dónde se guardan en cada entorno y recogerlos de cada instancia. Todo eso es trabajo repetido y fuente de incidentes, como el clásico disco lleno a las tres de la mañana.
La práctica recomendada es que la aplicación escriba cada evento en la salida estándar, y que sea el entorno donde se ejecuta, la plataforma, el gestor de contenedores o el sistema, quien los recoja y los envíe a donde corresponda.
# Con contenedores, los registros se leen del propio motor
docker logs --since 10m mi-app | jq -c 'select(.nivel=="error")'

# Con systemd, del diario del sistema
journalctl -u mi-app --since "10 min ago" -o cat | jq -c 'select(.nivel=="error")'
Así la aplicación es idéntica en todos los entornos, y cambiar dónde se guardan los registros no exige tocar el código.
Cuánto registrar
Registrar todo parece prudente hasta que llega la factura o hasta que hay que encontrar algo entre el ruido, y ambas cosas llegan pronto con tráfico real.
El criterio que funciona en proyectos pequeños es registrar con detalle lo que falla y lo que tiene valor de negocio, y de forma escueta o nula lo que funciona con normalidad. Una línea por cada petición exitosa de un sitio con tráfico genera volumen sin información.
Cuando el volumen es alto, existe una técnica intermedia: el muestreo. Se registran todos los errores y una fracción de las peticiones normales, por ejemplo una de cada cien, lo que conserva la visión estadística sin el coste completo.
Y conviene revisar de vez en cuando qué eventos ocupan más, porque suele haber uno que genera la mitad del volumen sin que nadie lo consulte nunca:
# Qué eventos generan más líneas en el último registro
jq -r '.evento' app.log | sort | uniq -c | sort -rn | head -5
Del registro a la métrica
Hay un punto donde los registros se usan para algo que no les corresponde, y reconocerlo evita costes y lentitud.
Si para saber cuántos pedidos se crean por minuto hay que contar líneas de registro cada vez, se está usando el registro como métrica. Funciona con poco volumen y se vuelve caro y lento con mucho, porque hay que procesar millones de líneas para obtener un número.
Las métricas son otra herramienta, pensada para contar y medir de forma continua y barata. La regla práctica es que los registros explican un evento concreto y las métricas describen el comportamiento agregado. Esa diferencia, y cómo se complementan con el trazado, es el tema del siguiente artículo.
Qué se le escapa a una IA con esto
El código generado suele llenarse de impresiones en consola durante la depuración, y esas líneas se quedan en producción. Son texto libre, sin nivel, sin identificador de petición y a veces con datos que no deberían salir.
Cuando se pide registro estructurado, el patrón que se repite es incrustar los datos variables dentro del mensaje en lugar de en campos, lo que devuelve el problema del texto libre con formato JSON por encima. Y casi nunca aparece el enmascarado de campos sensibles.
Las frases que cambian la respuesta son pedir un nombre de evento fijo con los datos en campos propios, un identificador de petición en todas las líneas, y una lista de campos enmascarados en la configuración.
# Encontrar impresiones de depuración que se quedaron en el código
grep -rnE 'console\.(log|debug)\(|var_dump\(|print_r\(|\bprint\(' src/ --include='*.{js,ts,php,py}'
Ese comando, ejecutado antes de desplegar o incorporado a la integración continua, evita que la depuración de ayer se convierta en el ruido o la filtración de mañana.