La atención de quien revisa código es un recurso escaso y se gasta rápido. Si los primeros diez minutos de una revisión se van en señalar una indentación incorrecta, una variable sin usar y una importación sobrante, cuando llega la lógica de negocio queda poca atención para la parte que de verdad necesita a una persona.
Ese reparto importa más cuando el código lo genera una herramienta, porque el volumen crece mucho más rápido que la capacidad de revisarlo. La respuesta no es revisar más deprisa, sino que la máquina filtre todo lo que puede filtrar antes de que llegue a nadie.
En el primer eje de esta guía hay un artículo sobre cómo auditar código generado como si no confiaras en él. Aquel trata la revisión humana; este, todo lo que debería ocurrir antes para que esa revisión se concentre en lo importante.
Qué puede filtrar una máquina y qué no
La línea divisoria es bastante clara y conviene tenerla presente para no pedirle a cada filtro lo que no hace.
Una herramienta automática detecta bien lo que tiene una regla objetiva: formato, errores de tipo, patrones de código conocidos por ser peligrosos, secretos escritos en el código, dependencias con vulnerabilidades publicadas y comportamiento que rompe una prueba existente.
No detecta lo que exige entender la intención: si la lógica de negocio es correcta, si el cambio resuelve el problema que se quería resolver, si la solución es razonable para este sistema o si hay un caso que nadie consideró. Eso sigue siendo trabajo humano, y es exactamente donde conviene que se concentre la atención.
Lo que la máquina filtra antes de que revises
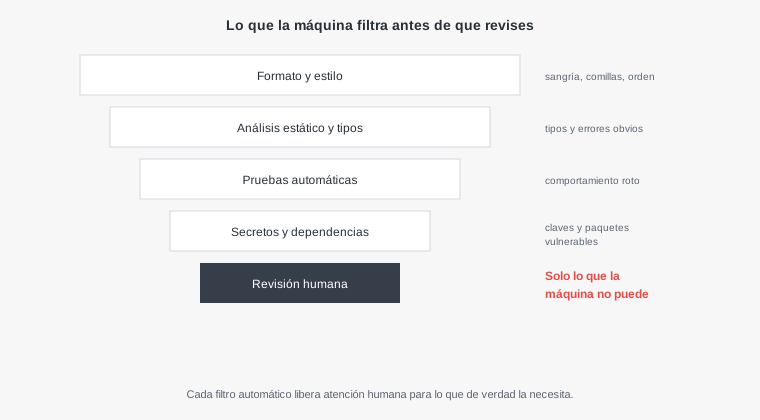
El orden del embudo no es arbitrario. Los filtros más rápidos y baratos van primero, y cada uno descarta un tipo de problema para que el siguiente no tenga que ocuparse de él. Cuando un cambio llega a la persona, ya no tiene problemas de formato, de tipos ni de pruebas rotas.
Primer filtro: formato, sin discusión
El formato del código es el tema que más tiempo de revisión consume y el que menos valor aporta. La solución es no discutirlo nunca: que lo imponga una herramienta.
Un formateador reescribe el código a un estilo fijo. No hay opiniones que debatir en la revisión, porque el formato es el que la herramienta produce, y cualquier comentario sobre sangría o comillas deja de tener sentido.
# JavaScript / TypeScript
npx prettier --check .          # comprobar
npx prettier --write .          # corregir

# PHP
vendor/bin/php-cs-fixer fix --dry-run --diff

# Python
ruff format --check .
La ganancia añadida con código generado es que diferentes sesiones de un asistente producen estilos ligeramente distintos. Un formateador los unifica, y la diferencia del cambio muestra solo lo que cambió de verdad, no la sangría.
Segundo filtro: análisis estático y tipos
Los analizadores estáticos detectan errores sin ejecutar el código: variables que no existen, funciones llamadas con argumentos incorrectos, código inalcanzable, comparaciones que siempre dan el mismo resultado.
# JavaScript / TypeScript
npx eslint .
npx tsc --noEmit

# PHP
vendor/bin/phpstan analyse src --level=6

# Python
ruff check .
mypy app/
Con código generado este filtro rinde especialmente, porque detecta un tipo de error muy característico: llamadas a funciones o métodos que no existen, con nombres plausibles, que el asistente supuso sin comprobar. El código parece correcto al leerlo y no compila.
Tercer filtro: patrones peligrosos conocidos
Hay una categoría de herramientas que buscan patrones de código asociados a vulnerabilidades: consultas construidas pegando texto, datos del usuario insertados en la página sin escapar, uso de funciones de cifrado débiles, deserialización de datos no confiables.
# Semgrep: reglas de seguridad para varios lenguajes, de código abierto
pipx install semgrep
semgrep scan --config p/owasp-top-ten --error src/

# Solo los hallazgos de alta severidad, para no ahogarse en ruido
semgrep scan --config p/security-audit --severity ERROR src/
Estas herramientas producen falsos positivos, y conviene asumirlo desde el principio. La forma de convivir con ellos es empezar con un conjunto reducido de reglas de alta severidad, revisar lo que salga, y marcar explícitamente como aceptados los falsos positivos con un comentario que explique por qué. Activar todas las reglas de golpe produce cientos de avisos que todo el mundo ignora.
Cuarto filtro: secretos y dependencias
Dos comprobaciones que tratamos en el eje de seguridad y que pertenecen a este embudo, porque detectan problemas que un revisor humano pasa por alto con facilidad.
# Secretos escritos en el código o en el historial del cambio
gitleaks detect --source . --redact

# Dependencias con vulnerabilidades conocidas
npm audit --omit=dev --audit-level=high
composer audit
pip-audit
El de los secretos es el que más veces salva un disgusto con código generado, porque al pedir un ejemplo que funcione es frecuente que aparezca una clave escrita directamente en el archivo, y un revisor que mira la lógica no se fija en esa línea.
Quinto filtro: las pruebas
La batería de pruebas es el filtro que detecta que un cambio rompió un comportamiento existente, y el único de la lista que dice algo sobre la lógica.
Para que funcione como filtro y no como formalidad, las pruebas tienen que ejecutarse en cada cambio y bloquear la fusión si fallan. Y conviene que el filtro compruebe también que la cobertura no bajó, para que un cambio no pueda añadir código nuevo sin ninguna prueba.
Como vimos en el artículo sobre pedir pruebas a un asistente, este filtro tiene una trampa propia: si el mismo cambio modifica las pruebas para que pasen, el filtro queda en verde sin proteger nada. Por eso los cambios en pruebas existentes merecen la atención del revisor humano, que es justo lo que este embudo libera para mirar.
Que los filtros se ejecuten antes y después
Hay dos momentos para ejecutar estas comprobaciones, y conviene usar ambos porque cubren fallos distintos.
El primero es en la máquina de quien programa, antes de confirmar el cambio. Da respuesta inmediata y evita subir algo que va a fallar. Existe un gestor de código abierto que instala y ejecuta estas comprobaciones automáticamente en cada confirmación:
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/pre-commit/pre-commit-hooks
    rev: v4.6.0
    hooks:
      - id: check-merge-conflict
      - id: check-added-large-files
  - repo: https://github.com/gitleaks/gitleaks
    rev: v8.18.4
    hooks:
      - id: gitleaks
  - repo: https://github.com/astral-sh/ruff-pre-commit
    rev: v0.6.9
    hooks:
      - id: ruff
      - id: ruff-format
pipx install pre-commit
pre-commit install # se ejecutará en cada commit
pre-commit run --all-files # ejecutarlo ahora sobre todo el proyectoEl segundo momento es en la integración continua, que cubre a quien no tiene instalados los ganchos locales, que siempre es alguien, y que es el único punto donde se puede impedir la fusión de verdad.
Hacer que no se puedan saltar
Un filtro que se puede ignorar acaba ignorándose, normalmente el día con más prisa, que es cuando más falta hace.
La configuración que lo evita es marcar las comprobaciones como obligatorias en la rama principal, de modo que la plataforma de código no permita fusionar un cambio mientras alguna falle. Casi todas las plataformas lo permiten desde la configuración de protección de ramas.
# GitHub CLI: exigir que las comprobaciones pasen antes de fusionar en main
gh api -X PUT repos/:owner/:repo/branches/main/protection \
  -F required_status_checks[strict]=true \
  -F required_status_checks[contexts][]=ci \
  -F enforce_admins=true \
  -F required_pull_request_reviews[required_approving_review_count]=1 \
  -F restrictions=
El parámetro que aplica la regla también a los administradores es el que más se olvida y el que más importa. Sin él, la persona con más permisos, que suele ser la que tiene más prisa, puede saltarse todo.
La plantilla del cambio
El último filtro no es una herramienta sino un texto, y ayuda a que la revisión humana empiece con el contexto que la máquina no puede dar.
<!-- .github/pull_request_template.md -->
## Qué cambia y por qué

## Cómo lo probé
- [ ] Pruebas nuevas o actualizadas
- [ ] Probado a mano el caso de error, no solo el camino feliz

## Riesgos
- ¿Toca datos, pagos, permisos o migraciones? Explica cómo se revierte.

## Código generado
- [ ] Revisé y entiendo todo el código generado de este cambio
La última casilla no garantiza nada por sí sola, pero obliga a una decisión consciente. Y la sección de riesgos dirige la atención del revisor exactamente a los cambios que merecen más cuidado.
Medir si los filtros sirven
Un conjunto de filtros se puede degradar sin que nadie lo note: se vuelve lento, acumula excepciones o empieza a fallar por motivos que no tienen que ver con el código. Conviene revisarlo de vez en cuando con tres preguntas.
La primera es cuánto tarda. Si la integración continua pasa de diez minutos, la gente deja de esperar el resultado y fusiona por costumbre, o sube varios cambios juntos para no esperar varias veces. Los filtros lentos se paralelizan o se trasladan a una ejecución nocturna.
La segunda es cuántas veces falló sin motivo real. Una comprobación que da fallos intermitentes se vuelve a ejecutar hasta que pasa, y a partir de ahí nadie lee sus avisos.
La tercera es qué problemas llegaron a producción que un filtro podría haber detectado. Cada incidente de ese tipo es la mejor pista para añadir la regla que faltaba.
# GitHub CLI: duración y resultado de las últimas ejecuciones del flujo
gh run list --workflow=ci.yml --limit 20 --json conclusion,createdAt,updatedAt \
  --jq '.[] | [.conclusion, .createdAt, .updatedAt] | @tsv'
Qué se le escapa a una IA con esto
Pedir que se configure la integración continua produce con frecuencia un flujo que ejecuta las comprobaciones pero no bloquea nada: los pasos informan de errores y el cambio se puede fusionar igual. Parece que hay filtros y no los hay.
También es habitual que, ante un aviso del analizador, la solución propuesta sea desactivar la regla o añadir una excepción en lugar de corregir el código, y que eso se repita hasta que la configuración ignora media herramienta.
Las frases que cambian la respuesta son pedir que las comprobaciones sean obligatorias para fusionar, que no se desactive ninguna regla sin justificarlo por escrito, y que el flujo falle si se detectan secretos o vulnerabilidades graves.
# Contar cuántas excepciones se han ido añadiendo a los analizadores
grep -rnE "eslint-disable|@phpstan-ignore|noqa|nosemgrep|# type: ignore" src/ | wc -l
Ese número, revisado de vez en cuando, dice si los filtros siguen filtrando o si se han ido desactivando de uno en uno.