La respuesta llega con buena presentación: veinticuatro pruebas nuevas, todas en verde, y una línea al final que dice que la cobertura del módulo quedó por encima del noventa por ciento. Es fácil darla por buena y seguir con lo siguiente.
El problema es que ninguna de esas tres afirmaciones está garantizada. Las pruebas pueden no comprobar nada, puede que no se hayan ejecutado nunca, y la cifra de cobertura puede ser una estimación escrita en lugar de una medición. No porque haya mala intención, sino porque redactar un resumen convincente y verificar lo que dice son dos cosas distintas.
Mentir no es la palabra, pero el efecto es el mismo
Un modelo de lenguaje produce texto plausible. Cuando se le piden pruebas, produce pruebas plausibles, y cuando se le pide un resumen, produce un resumen plausible. Ninguna de las dos cosas implica haber ejecutado nada.
Los asistentes que sí ejecutan comandos pueden correr la batería y leer el resultado, y eso cambia mucho la fiabilidad. Pero incluso entonces aparecen fallos característicos: pruebas que se ajustan hasta que pasan, comprobaciones que se debilitan para eliminar un error, o una cifra de cobertura citada de una ejecución anterior.
La consecuencia práctica es una regla sin excepciones: ninguna afirmación sobre pruebas se acepta sin verla ejecutada. No porque el asistente sea poco fiable en general, sino porque en este terreno concreto el coste de una falsa seguridad es alto y verificar cuesta un minuto.
La cobertura mide ejecución, no protección
Antes de hablar de cómo pedir mejor, conviene aclarar qué mide la cifra que se suele usar para dar las pruebas por buenas.
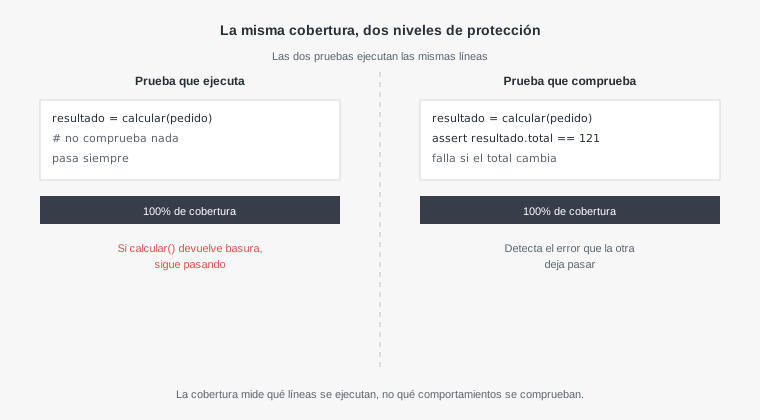
Una prueba que llama a una función y no comprueba su resultado marca todas sus líneas como cubiertas. La cobertura sube y la protección es nula.
Por eso una cobertura alta es una condición necesaria para tener buenas pruebas, pero no suficiente. Un número bajo sí dice algo útil, que hay código que ninguna prueba toca. Un número alto, por sí solo, no dice que ese código esté protegido.
Los seis patrones que conviene reconocer
Hay formas concretas en que las pruebas generadas parecen útiles sin serlo, y aparecen con tanta regularidad que merece la pena aprender a detectarlas de un vistazo.
- Pruebas sin comprobaciones. Llaman al código y terminan, o solo comprueban que no se lanzó ninguna excepción.
- Comprobaciones triviales. Verifican que el resultado existe o que es un objeto, en lugar de su valor.
- Simular lo que se está probando. La propia función bajo prueba se sustituye por una simulación, y la prueba comprueba la simulación.
- Esperados copiados del código. El valor esperado se obtuvo ejecutando la función, así que si la función tiene un error, la prueba lo consagra.
- Instantáneas aceptadas a ciegas. Se guarda la salida completa y se compara, sin que nadie haya revisado si esa salida era correcta.
- Comprobaciones debilitadas. Una prueba que fallaba se modificó para comprobar menos, en lugar de arreglar el código.
El último es el más peligroso, porque aparece justo cuando una prueba estaba haciendo su trabajo al detectar un fallo.
Detectarlos en segundos
Varios de esos patrones dejan huellas que se pueden buscar sin leer cada prueba.
# Pruebas que no contienen ninguna comprobación (Jest / Vitest)
for f in $(grep -rl "it(\|test(" tests/); do
  grep -q "expect(" "$f" || echo "sin expect: $f"
done

# Comprobaciones triviales que no verifican valores
grep -rnE "toBeDefined\(\)|toBeTruthy\(\)|not\.toThrow\(\)|assertNotNull\(|assertTrue\(true\)" tests/

# Pruebas desactivadas u omitidas que se colaron
grep -rnE "\.skip\(|xit\(|xdescribe\(|@skip|markTestSkipped|pytest\.mark\.skip" tests/

# Qué cambió en las pruebas existentes: ¿se debilitó alguna comprobación?
git diff main -- tests/ | grep -E '^-.*(expect|assert)'
Ese último comando es el más valioso de la lista. Muestra las comprobaciones que se eliminaron en el cambio, y cada línea que aparezca merece una explicación: o la prueba estaba mal, o se está tapando un error.
Medir la cobertura de verdad
La cifra hay que obtenerla ejecutando la herramienta, nunca leyéndola de un resumen. Es un solo comando en cualquier ecosistema.
# JavaScript
npx jest --coverage
npx vitest run --coverage

# Python
pytest --cov=app --cov-report=term-missing

# PHP (requiere Xdebug o PCOV)
XDEBUG_MODE=coverage vendor/bin/phpunit --coverage-text
La opción que muestra las líneas no cubiertas es más útil que el porcentaje. El número dice cuánto falta; la lista dice qué falta, y a menudo lo que falta son justamente las ramas de error, que son las que más importa probar.
Y conviene fijar un mínimo en la integración continua para que la cobertura no baje sin que nadie se entere, con la precaución de no convertirlo en un objetivo a perseguir, porque entonces se consigue con pruebas vacías.
La prueba definitiva: romper el código
Hay una comprobación manual que resuelve cualquier duda sobre si una prueba protege algo, y lleva menos tiempo que leerla con atención.
Se introduce a propósito un error en el código que la prueba dice cubrir: se invierte una condición, se cambia un número, se devuelve un valor fijo. Y se ejecuta la prueba. Si sigue pasando, no protege ese comportamiento.
# Romper deliberadamente una línea, ejecutar la prueba y deshacer el cambio
sed -i.bak 's/total \* 1.21/total * 1.00/' src/facturacion.js
npx jest tests/facturacion.test.js   # debería FALLAR
mv src/facturacion.js.bak src/facturacion.js
Hacer esto con las dos o tres funciones más importantes de un módulo da más confianza que cualquier cifra, y es la versión manual y rápida de las pruebas de mutación que se automatizan con herramientas dedicadas.
Cómo pedir las pruebas para empezar mejor
La forma de la petición cambia bastante el resultado, y hay algunas instrucciones que evitan de entrada la mayoría de los patrones anteriores.
La primera es describir el comportamiento esperado con ejemplos concretos, en lugar de pedir pruebas para una función. Decir que un pedido de cien con un cupón del diez por ciento y envío de cinco debe dar un total de noventa y cinco produce una prueba con un valor esperado que viene de la especificación, no del código.
La segunda es pedir explícitamente los casos límite y de error: qué pasa con un carrito vacío, con un cupón caducado, con una cantidad negativa. Sin pedirlo, las pruebas generadas se concentran en el camino feliz.
La tercera es prohibir de antemano los atajos: que no se simule la función que se está probando, que cada prueba compruebe valores concretos y que no se modifique ninguna prueba existente sin decirlo.
Cómo pedir la verificación
Con asistentes que pueden ejecutar comandos, la diferencia entre un resultado fiable y uno plausible está en pedir la evidencia en lugar del resumen.
En vez de preguntar si las pruebas pasan, pedir que se ejecute la batería y se muestre la salida real del comando. En vez de preguntar por la cobertura, pedir la salida de la herramienta de cobertura con las líneas no cubiertas.
Y cuando una prueba falla, conviene detener el impulso natural de pedir que se arregle. La pregunta útil es primero por qué falla, y si el fallo revela un error en el código o en la prueba. Solo con esa respuesta se decide qué cambiar.
Una instrucción que resume todo lo anterior y funciona bien es pedir que, antes de dar las pruebas por terminadas, se rompa deliberadamente cada función probada y se confirme que su prueba falla.
Revisar el cambio, no solo el resultado
Cuando las pruebas se generan dentro de un cambio más grande, lo que más información da no es la batería final sino la diferencia respecto a lo que había.
Conviene mirar específicamente tres cosas en esa diferencia: pruebas eliminadas, comprobaciones que se cambiaron por otras más débiles, y archivos de instantáneas regenerados. Cualquiera de las tres puede estar ocultando que un comportamiento cambió.
La regla que protege es tratar un cambio en una prueba existente con más sospecha que una prueba nueva. Una prueba nueva añade protección; una prueba modificada puede estar quitándola, y es exactamente el tipo de cambio que se aprueba sin mirar.
Las pruebas intermitentes generadas
Hay un último patrón que no aparece al revisar el código y sí al ejecutarlo varias veces: pruebas que pasan unas veces y fallan otras sin que nada haya cambiado.
En el código generado suelen tener causas muy concretas. Esperas de tiempo fijo en lugar de esperar a que algo ocurra, fechas calculadas a partir del momento actual que fallan a medianoche o a fin de mes, datos compartidos entre pruebas que dependen del orden de ejecución, y números aleatorios sin semilla fija.
Una prueba así puede pasar la primera ejecución, que es la única que se ve al aceptar el cambio, y empezar a fallar de forma esporádica días después en la integración continua, cuando ya nadie recuerda de dónde vino.
La forma de detectarla antes es sencilla y conviene hacerla con las pruebas nuevas antes de darlas por buenas: ejecutarlas varias veces seguidas, y en orden aleatorio.
# Ejecutar las pruebas nuevas diez veces y contar fallos
for i in $(seq 1 10); do npx jest tests/nuevas/ --silent >/dev/null 2>&1 || echo "fallo en la ejecución $i"; done

# Y en orden aleatorio, para detectar dependencias entre pruebas
npx jest tests/nuevas/ --randomize
Si alguna falla aunque sea una vez, se corrige antes de aceptar. Una prueba intermitente que entra en la batería erosiona la confianza en todas las demás.
Qué se le escapa a una IA con esto
El resumen es la parte más fácil de aceptar y la menos fiable. Frases como todas las pruebas pasan o la cobertura supera el noventa por ciento pueden ser verdad, pueden venir de una ejecución anterior o pueden ser una estimación, y no hay forma de distinguirlo sin ver la salida.
Ante una prueba que falla, la tendencia es a hacerla pasar por el camino más corto, que a menudo es cambiar el valor esperado o debilitar la comprobación, en lugar de preguntarse si el código tiene un error.
Las frases que cambian la respuesta son pedir la salida literal de los comandos en lugar de su resumen, prohibir modificar pruebas existentes sin justificarlo, y exigir que cada prueba se haya visto fallar con un error introducido a propósito.
Y conviene cerrar siempre con la comprobación que no depende de nadie: ejecutar tú mismo la batería y la cobertura antes de aceptar el cambio. Es un minuto, y es la única cifra en la que se puede confiar sin reservas.