Los consejos sobre monitoreo casi siempre vienen escritos para equipos que no existen en un proyecto pequeño. Hablan de paneles, de métricas por servicio, de trazas distribuidas y de personas de guardia por turnos.
Cuando el equipo es una sola persona que además escribe el código, atiende a los usuarios y decide qué se construye, ese material no se puede aplicar a medias: o se adapta, o se ignora entero. Lo segundo es lo que suele pasar, y por eso tantos proyectos se enteran de que están caídos porque alguien lo menciona.
El único objetivo que importa al principio
Monitorear no es acumular datos sobre el sistema. Es reducir el tiempo entre que algo se rompe y que tú te enteras.
Visto así, la mayoría de las herramientas sofisticadas resuelven un problema que todavía no tienes. Un panel con veinte gráficas no te avisa de nada: hay que estar mirándolo. Y nadie mira un panel a las once de la noche de un sábado, que es justo cuando conviene enterarse.
La diferencia entre descubrir una caída en dos minutos o en catorce horas no la marca la cantidad de métricas recogidas, sino que exista una sola alerta que llegue a un sitio donde la vas a ver. Ese es el punto de partida y, durante bastante tiempo, casi todo lo que hace falta.
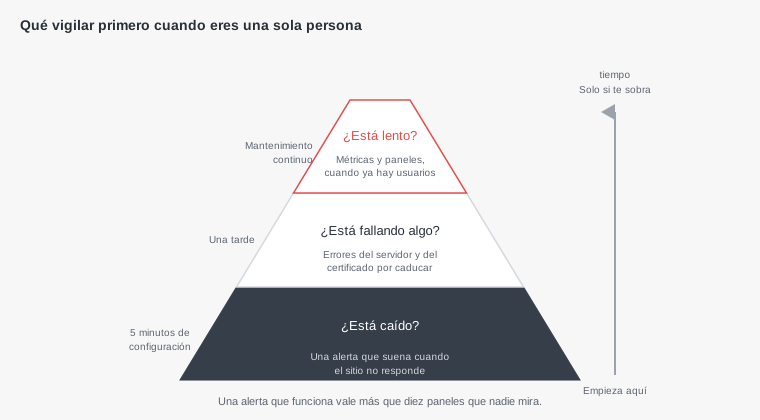
Nivel uno: saber si está caído
Es lo primero y lo que más valor aporta por minuto invertido. Un servicio externo que visita tu sitio cada pocos minutos y avisa cuando deja de responder.
La palabra importante es externo. Un sistema de vigilancia que vive dentro del mismo servidor se cae con él, y entonces no avisa precisamente cuando debía. Es el error de diseño más común en el monitoreo casero.
Conviene además que la comprobación no sea solo que el servidor responde, sino que responde bien. Una página que devuelve un error de aplicación sigue contestando, y una comprobación superficial la da por sana. Verificar que aparece cierto texto esperado, o crear una dirección específica que confirme que la base de datos también responde, distingue un sitio vivo de uno que solo parece estarlo.
Y hay que decidir dónde llega el aviso. El correo sirve en horario de trabajo y es inútil de madrugada. Un mensaje al teléfono es lo que convierte una alerta en algo que se atiende.
Nivel dos: enterarse de lo que falla sin tumbar el sitio
La mayoría de los problemas no tiran el sistema entero. Lo dejan funcionando con una parte rota, que es más difícil de detectar y a veces más dañino.
Un pago que falla para algunos usuarios, un correo que dejó de enviarse, una integración que devuelve errores desde que el proveedor cambió algo. El sitio responde, la vigilancia externa lo ve sano, y nadie se entera hasta que alguien escribe para quejarse.
Lo que cubre este hueco es capturar los errores de la aplicación y que lleguen a un sitio donde se vean agrupados. No hace falta un sistema complejo: existen servicios que en pocas líneas de configuración recogen cada excepción con su contexto y avisan cuando aparece una nueva.
La parte que marca la diferencia es el agrupamiento. Un error que ocurre mil veces debe llegar como una notificación, no como mil. Sin eso, las alertas se vuelven ruido y el ruido se ignora, que es la forma más común de que un sistema de monitoreo deje de servir sin que nadie lo apague.
A este nivel pertenece también la caducidad del certificado, que ya cubrimos al hablar de dominios: un aviso varios días antes convierte un incidente público en una tarea tranquila.
Nivel tres: las métricas, cuando ya hay a quién medirle
La tercera capa es la que aparece primero en los artículos técnicos y la última que conviene montar: tiempos de respuesta, uso de recursos, gráficas de evolución.
No es que no sirva, es que responde a preguntas que solo tienen sentido con tráfico real. Saber que la página tarda trescientos milisegundos importa cuando hay usuarios notándolo; antes de eso es un dato sin consecuencia.
Cuando llegue el momento, la forma de que sea útil es fijar de antemano qué número dispararía una acción. Una métrica que se mira pero que nunca cambia nada es un panel decorativo, y consume atención que hace falta en otro sitio.
Pregúntate qué harías si sonara ahora mismo, a las tres de la madrugada. Si la respuesta es levantarte a arreglarlo, la alerta está bien planteada.
Si la respuesta es mirarlo por la mañana, entonces no es una alerta: es un informe, y debe llegar como tal, sin interrumpir.
Por qué las alertas dejan de funcionar
El fallo más frecuente del monitoreo en equipos pequeños no es la falta de herramientas. Es que las alertas existentes se vuelven ruido y dejan de mirarse.
Ocurre siempre igual. Se configuran avisos para muchas condiciones, varias de ellas normales. Empiezan a llegar notificaciones que no requieren hacer nada. Al cabo de unas semanas, el reflejo ante una notificación es descartarla sin leerla. Y el día que llega una importante, recibe el mismo trato.
La forma de evitarlo es tener pocas alertas y que cada una signifique algo. Si una salta con frecuencia y nunca hay que hacer nada, no hay que aguantarla: hay que corregir el umbral o eliminarla. Una bandeja donde cada mensaje importa es lo que mantiene el sistema vivo.
Conviene además apartar lo que es informativo de lo que es urgente. Un resumen diario por correo con lo que ocurrió es útil y no interrumpe. Un mensaje al teléfono debe quedar reservado para lo que no puede esperar a mañana.
Los registros, y por qué guardar todo no ayuda
Cuando algo falla, los registros son lo que permite reconstruir qué pasó. Esa utilidad depende menos de cuánto se guarda que de cómo se escribió.
Un registro que dice que ocurrió un error no sirve para nada. Uno que dice qué operación se intentaba, con qué identificador y qué devolvió el sistema externo, resuelve el problema en minutos. La diferencia se decide al escribir el código, no al configurar la herramienta.
Guardar todo, en cambio, tiene un costo doble: la factura, que ya vimos, y la dificultad de encontrar algo entre el ruido. Registrar cada petición exitosa de un sitio con tráfico produce volumen sin información.
El criterio que funciona en proyectos pequeños es registrar con detalle lo que falla y de forma escueta lo que funciona. Y cuando hay varias piezas implicadas, arrastrar un identificador común por todas ellas, que es lo único que permite seguir una operación completa cuando el fallo ocurrió a mitad de camino.
Qué se le escapa a una IA cuando monta esto
Pedir ayuda para configurar monitoreo produce, casi siempre, una propuesta técnicamente correcta y desproporcionada: un sistema de recolección de métricas, un panel, varias reglas de alerta y un componente que las despacha.
Todo eso funciona y todo eso hay que mantenerlo. Para un equipo de una persona, montarlo suele significar que a los tres meses hay un panel que nadie abre y un servicio más que puede fallar.
El dato que cambia la respuesta es decir cuánta gente va a operarlo y qué se quiere lograr. Pedir la forma más simple de enterarse de que el sitio está caído lleva a una respuesta de cinco minutos, y esa respuesta cubre la mayor parte del riesgo real.
Hay además una omisión que se repite y conviene pedir explícitamente: que el propio sistema de vigilancia avise si deja de funcionar. Un proceso de comprobación detenido no genera alertas, y la ausencia de alertas se interpreta como que todo va bien. Es la misma trampa que un respaldo que falla en silencio.
Enterarse por el usuario no siempre es un fracaso
Conviene matizar algo, porque la idea de que el usuario nunca debería avisarte primero suena bien y lleva a montar más vigilancia de la necesaria.
Hay fallos que ninguna comprobación automática va a detectar, porque el sistema funciona exactamente como se le pidió. Un precio que se calcula mal, un correo que llega con el texto equivocado, un botón que no hace lo que promete. Todo responde, nada da error, y sin embargo está roto.
Para esa categoría, el canal de avisos de los usuarios es el sistema de detección, y merece tratarse como tal. Que exista una forma visible de reportar un problema, y que alguien la lea, cubre un hueco que las herramientas no cubren.
La distinción útil es esta: de las caídas y los errores técnicos deberías enterarte tú primero, siempre. De los fallos de comportamiento, es razonable enterarse por quien los sufre, y lo que importa entonces es la rapidez con que se puede confirmar y corregir.
Qué revisar una vez al mes
El monitoreo montado y olvidado se degrada solo. Una revisión breve, con periodicidad fija, es lo que evita descubrir el problema cuando ya no sirve.
- Provoca una alerta a propósito. Apaga algo un minuto, o usa la prueba que traiga la herramienta, y comprueba que el aviso llega a tu teléfono. Es la única forma de saber que la cadena completa sigue funcionando.
- Mira qué alertas saltaron y cuáles ignoraste. Las que se descartan sistemáticamente sobran: hay que ajustarlas o quitarlas antes de que contagien a las demás.
- Comprueba que las copias siguen ejecutándose. No que estén configuradas: que hayan corrido esta semana.
- Revisa qué errores nuevos aparecieron aunque nadie se haya quejado. Suelen ser la primera señal de algo que va a crecer.
Son quince minutos al mes y es lo que separa un sistema de monitoreo real de uno que existe solo en la configuración.
Lo mínimo que debería tener cualquier proyecto con usuarios
Resumido en lo que se puede montar en una tarde y no hay que mantener después:
- Una comprobación externa cada pocos minutos, que verifique algo más que el hecho de responder, y que avise al teléfono.
- Captura de errores de la aplicación agrupados, con aviso cuando aparece uno nuevo.
- Un aviso de caducidad del certificado con varios días de margen.
- Un aviso de gasto del proveedor, que también es monitoreo aunque no lo parezca.
- Una comprobación de que las copias se hicieron, porque el silencio no es confirmación.
Son cinco cosas, ninguna exige mantenimiento continuo, y entre las cinco cubren los fallos que de verdad tumban proyectos pequeños. Lo demás puede esperar a que haya usuarios suficientes para que la diferencia se note.