Un formulario con un campo de correo bien configurado rechaza lo que no parece una dirección válida. El usuario ve el aviso, corrige y continúa. Todo funciona.
Esa validación no protege absolutamente nada. Es una ayuda para quien rellena el formulario, y desaparece en cuanto alguien deja de usar el formulario, que es exactamente lo que hace cualquiera que quiera causar daño.
Por dónde llegan realmente las peticiones
La suposición que está detrás de casi todos los fallos de este tipo es que los datos llegan por donde uno los espera.
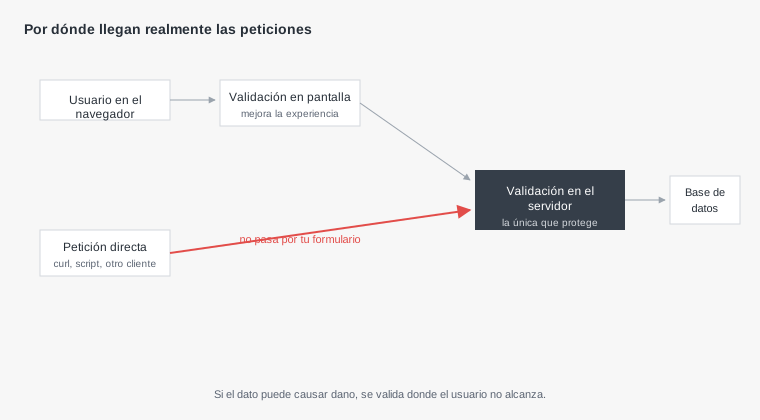
Tu API está en internet y acepta peticiones de cualquiera que sepa su dirección. El navegador es un cliente entre muchos, y es el único que ejecuta tu código de validación.
Todo lo demás, una herramienta de línea de comandos, un script de dos líneas, una extensión del navegador o el propio navegador con las herramientas de desarrollo abiertas, envía lo que le da la gana. No hay ninguna forma de impedirlo, porque el servidor no puede saber qué programa hizo la petición.
De ahí la regla que ordena todo este tema: la validación del cliente es comodidad, la del servidor es seguridad. Hacen falta las dos y no son sustituibles entre sí.
Validar no es limpiar
Hay dos operaciones que se confunden constantemente y que conviene separar, porque aplicar la equivocada produce fallos sutiles.
Validar es comprobar si el dato cumple lo esperado y rechazarlo si no. La respuesta es sí o no, y ante un no la operación se detiene.
Escapar es transformar el dato para que sea seguro en el contexto donde va a usarse. No rechaza nada: prepara el valor para su destino.
La diferencia importa porque escapar depende del destino. El mismo texto se escapa de una forma si va a una consulta, de otra si va a una página web y de otra si va a un nombre de archivo. Por eso no existe la función que deje un dato limpio de una vez y para siempre, aunque la idea resulte tentadora.
El orden correcto es validar al recibir, guardar el valor tal cual, y escapar en el momento de usarlo, según el sitio donde se use.
Aceptar lo conocido en vez de rechazar lo peligroso
Hay dos formas de plantear una validación, y una de ellas falla siempre a largo plazo.
La primera es hacer una lista de lo que no se permite: ciertas palabras, ciertos caracteres, ciertos patrones. Parece razonable y tiene un defecto estructural, y es que la lista nunca está completa. Siempre hay una codificación distinta, una variante o un caso que no se previó.
La segunda es definir qué se acepta y rechazar todo lo demás. Un código postal son cinco dígitos; una cantidad es un número entero entre uno y cien; un identificador tiene un formato conocido. Lo que no encaje se rechaza sin analizarlo.
Esta segunda forma es más restrictiva y es la que funciona, porque no depende de anticipar los ataques: depende de conocer los datos propios, que es algo que sí se puede hacer bien.
El tipo, la longitud, el rango y el formato. Y, cuando aplique, que el valor esté dentro de un conjunto cerrado de opciones válidas.
Ese último punto cubre un fallo muy común: un campo de estado que debería aceptar tres valores concretos y acepta cualquier texto porque nadie lo restringió.
Los dos fallos que siguen causando más daño
Casi todos los incidentes de esta categoría se reducen a que un dato del usuario acabó interpretado como instrucción en lugar de como texto.
En la base de datos, eso ocurre cuando la consulta se construye pegando trozos de texto. La defensa no es filtrar comillas: es usar consultas parametrizadas, donde el valor viaja por un canal separado y el motor nunca lo interpreta como parte de la instrucción. Con parámetros, el problema desaparece por completo, y por eso esta es la recomendación que no admite matices.
En la página web, ocurre cuando un texto del usuario se inserta en el documento y el navegador lo ejecuta. La defensa es escapar al mostrar, que casi todos los motores de plantillas hacen solo, salvo cuando alguien desactiva el escapado para que un contenido con formato se vea bien.
Ese caso, el del contenido con formato que debe conservar etiquetas, es el único que necesita tratamiento especial, y requiere una librería que filtre el HTML permitiendo solo lo seguro. Escribir ese filtro a mano no funciona: es exactamente el tipo de lista de prohibiciones que siempre acaba teniendo un hueco.
Los casos que se olvidan
La validación se piensa para los formularios, y los datos entran por bastantes sitios más.
- Los parámetros de la dirección. Un identificador numérico que llega por la URL es una entrada del usuario tanto como un campo de texto, y suele usarse sin comprobar.
- Los archivos subidos. Aquí hay que validar el tipo real y no la extensión ni lo que declara el navegador, limitar el tamaño y, sobre todo, guardarlos donde no se puedan ejecutar y renombrarlos en lugar de conservar el nombre original.
- Las cabeceras y las cookies. Llegan del cliente y se pueden modificar, aunque no se escriban en ningún formulario.
- Las respuestas de servicios externos. Un servicio de terceros puede devolver algo inesperado, y tratar su respuesta como confiable por venir de una empresa conocida es un supuesto que falla.
- Los webhooks. Son peticiones de internet que llegan a una dirección conocida. Además de validar el contenido, hay que verificar la firma para confirmar que vienen de quien dicen.
El de los archivos merece énfasis porque combina varios riesgos a la vez y su fallo típico, permitir que se ejecute algo subido, entrega el servidor entero.
El campo que no se envía y aun así se guarda
Hay un fallo que no tiene que ver con validar mal lo que llega, sino con aceptar campos que nadie esperaba, y es de los que más daño hacen porque el código parece correcto.
Ocurre cuando el endpoint toma el contenido completo de la petición y lo usa para crear o actualizar un registro de una vez. Es cómodo, ahorra líneas y significa que quien envía la petición decide qué columnas se escriben.
El resultado típico es un formulario de registro que pide nombre y correo, y una petición directa que además incluye el campo que marca a un usuario como administrador. La validación de los campos visibles pasa sin problemas, porque esos campos son correctos; el que sobra nunca se comprobó.
La defensa es no confiar en la forma de la petición, sino declarar explícitamente qué campos se aceptan en cada operación y descartar el resto antes de tocar nada. Es la misma idea de aceptar lo conocido, aplicada a la estructura en lugar de al contenido.
Conviene además que los campos sensibles no se puedan escribir nunca por esta vía. El estado de administrador, el saldo, el identificador del propietario o cualquier marca de verificación deberían cambiarse solo desde código que sepa lo que está haciendo, no desde el mismo lugar que guarda el nombre y el teléfono.
Validar antes no siempre alcanza
Hay una categoría de comprobación que no se resuelve mirando el dato, porque depende de algo que puede cambiar entre que se valida y que se usa.
El ejemplo claro es una cantidad en una compra. Se comprueba que hay existencias suficientes, la comprobación pasa, y en el instante siguiente otra petición consume las últimas unidades. Ambas operaciones validaron correctamente y el resultado final es imposible.
Ese tipo de condición no pertenece a la capa de validación sino a la de datos, y se resuelve donde se garantiza la coherencia: con una transacción, una restricción en la base o un bloqueo sobre el registro afectado.
La distinción práctica es útil al revisar código. Si una comprobación depende solo del valor recibido, va en la validación de entrada. Si depende del estado del sistema, tiene que ejecutarse dentro de la misma operación que modifica ese estado, o no sirve de nada.
Dónde ponerla para que no se olvide
Una validación que hay que recordar escribir en cada endpoint nuevo se va a olvidar en alguno, probablemente en el que se escriba con prisa un viernes.
Lo que funciona es que la comprobación sea estructural: definir la forma esperada de cada entrada en un solo sitio y que el sistema la aplique antes de que el código de negocio reciba nada. Casi todos los marcos de trabajo modernos ofrecen algo así, y el beneficio es que un endpoint sin validación deja de ser posible por descuido.
Conviene además que las restricciones estén también en la base de datos: tipos correctos, campos obligatorios, claves foráneas, valores únicos. Es la última línea, la que sigue funcionando aunque una ruta nueva se salte todo lo anterior.
Y los mensajes de error deben decir qué campo falló sin revelar detalles internos. Un error que devuelve la consulta ejecutada o la ruta del archivo está regalando información sobre el sistema a quien está probando por dónde entrar.
Por qué esto falla tanto con código generado
El título de este artículo apunta a un patrón real y bastante consistente: el código generado tiende a asumir que los datos que recibe son los que el formulario envía.
La razón es comprensible. Al pedir una pantalla de creación de usuarios, el modelo genera el formulario, la validación en el cliente y el endpoint que guarda. Esa validación en el cliente está presente, se ve funcionando al probarlo, y produce la sensación de que el asunto está cubierto.
Lo que falta casi siempre es la comprobación en el servidor, porque nadie la pidió explícitamente y porque el ejemplo funciona sin ella. También suele faltar el caso del dato ausente, del tipo equivocado y del valor fuera de rango, que son los tres primeros que alguien va a probar.
La frase que cambia la respuesta es pedir que el servidor valide asumiendo que la petición no viene del formulario. Con eso aparecen las comprobaciones, el manejo del dato ausente y el rechazo de lo que no encaja.
Y hay una prueba que conviene hacer siempre antes de dar por buena una pantalla: enviar una petición directa al endpoint, sin pasar por la interfaz, con un campo vacío, con un tipo distinto al esperado y con un valor absurdo. Si alguna de las tres se guarda, la validación real no existe.