Hay una conversación que se repite en casi todos los equipos, normalmente cuando la aplicación empieza a ir lenta: habría que reescribirlo en otro lenguaje. Suele proponerse con convicción, a veces con una prueba de rendimiento que lo respalda, y casi siempre ataca el problema equivocado.
No porque los lenguajes sean iguales, que no lo son. Sino porque en la mayoría de las aplicaciones reales, el tiempo se va en sitios donde el lenguaje no interviene.
Dónde se va el tiempo de una petición
Antes de discutir sobre lenguajes conviene mirar el reparto, porque cambia la conversación entera.
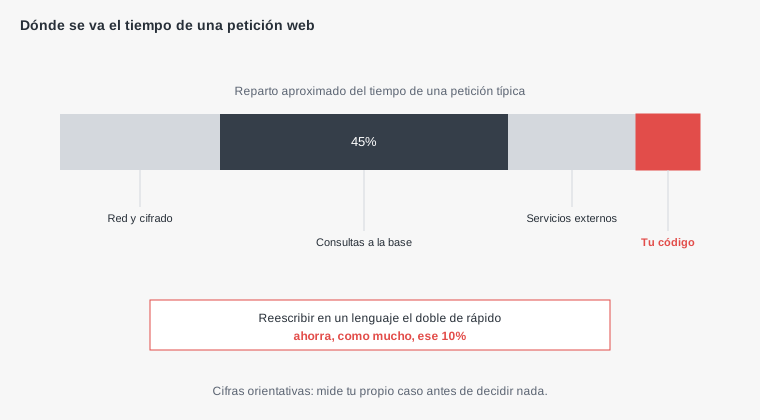
La proporción exacta varía, pero el patrón es muy estable: una aplicación web pasa la mayor parte de cada petición esperando. Esperando a la base de datos, a un servicio externo, a que lleguen los bytes por la red. Durante ese tiempo, el lenguaje en que está escrita no hace nada.
Si el código propio ocupa un diez por ciento del tiempo, un lenguaje el doble de rápido lo reduce a un cinco. La petición mejora un cinco por ciento, tras meses de reescritura.
Medir antes de opinar
La discusión se resuelve con datos, y obtenerlos lleva menos tiempo que la propia discusión.
# 1. Tiempo total visto desde fuera, y cuánto es espera del servidor
curl -s -o /dev/null -w 'espera servidor: %{time_starttransfer}s  total: %{time_total}s\n' \
  https://midominio.com/api/pedidos

# 2. Qué consultas a la base consumen más tiempo acumulado (PostgreSQL)
psql -c "SELECT round(total_exec_time) AS ms, calls, left(query, 70)
         FROM pg_stat_statements ORDER BY total_exec_time DESC LIMIT 10;"

# 3. Si el proceso usa procesador o está esperando, bajo carga real
top -p $(pgrep -f servidor)
La tercera medición es la más reveladora. Si bajo carga el procesador del servidor de aplicación está bajo y la latencia es alta, la aplicación espera, y el lenguaje es irrelevante para ese problema. Si el procesador está al máximo, entonces sí hay cálculo que optimizar.
La segunda suele encontrar el culpable real en cinco minutos: una consulta sin índice, o una consulta rápida que se ejecuta cientos de veces por petición.
Cuándo el lenguaje sí importa
Hay casos donde la elección tiene consecuencias reales, y conviene reconocerlos para no caer en el extremo contrario.
- Cálculo intensivo. Procesar vídeo, transformar imágenes, comprimir, entrenar o ejecutar modelos. Aquí el procesador trabaja de verdad y un lenguaje compilado puede ser muchas veces más rápido.
- Volumen muy alto con márgenes pequeños. Cuando se atienden cientos de miles de peticiones por segundo, un diez por ciento de ahorro por petición son servidores enteros menos en la factura.
- Uso de memoria que encarece. Un servicio que ocupa diez veces más memoria de la necesaria multiplica el coste de alojamiento cuando se replica muchas veces.
- Arranque instantáneo. Herramientas de línea de comandos o funciones que se ejecutan en frío, donde medio segundo de arranque se nota.
- Requisitos de tiempo estrictos. Sistemas donde una pausa de unos milisegundos es inaceptable.
En casi todos estos casos la respuesta no es reescribir la aplicación, sino la pieza concreta que tiene el problema.
Lo que importa más que el rendimiento
En la mayoría de los proyectos, la elección de lenguaje tiene más peso por otros motivos, que casi nunca aparecen en las comparaciones técnicas.
El primero es quién va a mantenerlo. Un lenguaje que conoce el equipo produce código mejor, más rápido y con menos errores que uno objetivamente superior que nadie domina. En un proyecto de una persona, esto decide casi todo.
El segundo es el ecosistema. La existencia de una librería madura para lo que necesitas hacer ahorra semanas de trabajo. Elegir un lenguaje donde hay que escribir desde cero lo que en otro ya existe es un coste enorme que no se ve al elegir.
El tercero es dónde se va a ejecutar. El alojamiento, los servicios gestionados y las plataformas imponen o favorecen ciertos entornos, y nadar contra eso añade fricción constante.
Y el cuarto es contratar o pedir ayuda: cuánta gente hay que lo conozca, cuánta documentación existe, cuántas respuestas hay a los errores que vas a encontrar.
El coste real de una reescritura
Conviene poner números a lo que suele proponerse como una mejora rápida, porque la estimación inicial falla casi siempre en la misma dirección.
Reescribir no es traducir línea a línea. Es redescubrir cada comportamiento que el sistema actual tiene y nadie documentó: los casos límite que se corrigieron tras un incidente, las validaciones que se añadieron por una queja, los formatos que un cliente espera exactamente así.
Mientras dura la reescritura, el sistema antiguo sigue necesitando correcciones, que hay que aplicar en los dos. Y cuando se termina, aparecen durante meses los comportamientos que el sistema viejo tenía y el nuevo no.
Por eso la alternativa que casi siempre gana es la gradual: extraer la pieza que tiene un problema medido, escribirla en el lenguaje que lo resuelve, y dejar el resto donde está.
Las optimizaciones que ganan antes
Si el objetivo es que la aplicación vaya más rápido, estas medidas suelen dar más resultado que cualquier cambio de lenguaje, y cuestan horas en lugar de meses.
- Añadir el índice que falta en la consulta que más tiempo acumula.
- Eliminar consultas dentro de bucles, que multiplican el número de viajes a la base.
- Cachear lo que no cambia, en la capa más cercana al usuario que pueda responder.
- Lanzar en paralelo las llamadas independientes que hoy se hacen una detrás de otra.
- Mover trabajo lento fuera de la petición, a una tarea en segundo plano.
Cada una de estas tiene su artículo en esta guía, y cualquiera de ellas suele producir una mejora mayor que reescribir el código en un lenguaje más rápido.
Una forma de decidir
Para un proyecto nuevo, la pregunta útil no es qué lenguaje es mejor, sino qué lenguaje minimiza el riesgo de este proyecto concreto.
Si el equipo domina uno y el problema no tiene requisitos de cálculo especiales, ese es el lenguaje. Si hay una pieza con requisitos especiales, se identifica al principio y se aísla, de forma que pueda escribirse en otro lenguaje sin arrastrar al resto.
Y para un proyecto existente con problemas de rendimiento, el orden es siempre el mismo: medir, encontrar el cuello de botella real, aplicar la optimización barata, y solo si después de eso queda un problema de cálculo medido y concentrado, plantearse otro lenguaje para esa pieza.
Perfilar el código propio cuando sí es el cuello de botella
Si las mediciones anteriores dicen que el procesador está al máximo y el tiempo se va en el código propio, el siguiente paso sigue sin ser cambiar de lenguaje: es averiguar qué función concreta consume ese tiempo.
La experiencia repetida es que casi nunca es el sitio que uno sospecha. Un perfilador muestra dónde pasa el programa su tiempo real, y con frecuencia el culpable es una única función: una serialización repetida, una expresión regular mal escrita, un bucle que recorre una lista entera buscando un elemento que se podría obtener directamente.
# Node: generar un perfil de CPU y abrirlo en las herramientas del navegador
node --cpu-prof servidor.js

# Python: ver qué funciones acumulan más tiempo
python3 -m cProfile -s cumtime app.py | head -25

# PHP con Xdebug: generar un perfil que se abre en cualquier visor compatible
php -d xdebug.mode=profile -d xdebug.output_dir=/tmp script.php

# Go: perfil de CPU de 30 segundos sobre un servicio en marcha
go tool pprof http://localhost:6060/debug/pprof/profile?seconds=30
Corregir esa única función suele dar una mejora mayor que reescribir todo en un lenguaje más rápido, porque ataca justo lo que se mide en lugar de acelerar por igual el código que ya era rápido.
Solo si después de eso sigue habiendo un cálculo pesado, concentrado y medido, tiene sentido plantearse escribir esa pieza concreta en otro lenguaje.
Los lenguajes cambian más despacio que los problemas
Hay un último argumento contra elegir lenguaje por rendimiento que conviene tener presente: la ventaja relativa se mueve con el tiempo, y lo hace más rápido de lo que dura un proyecto.
Los intérpretes y compiladores de los lenguajes populares mejoran de forma sostenida. Versiones recientes de PHP, Python o JavaScript son notablemente más rápidas que las de hace pocos años, sin que nadie haya tocado una línea del código que ejecutan.
Eso significa que una decisión tomada hoy por una diferencia de rendimiento puede quedar anulada por una actualización del entorno, mientras que las razones de fondo, qué conoce el equipo y qué ecosistema tiene, siguen siendo igual de válidas.
La consecuencia práctica es modesta y muy rentable: antes de cualquier otra optimización, conviene comprobar que se usa una versión reciente del entorno. Es con frecuencia la mejora de rendimiento más barata que existe.
Qué se le escapa a una IA con esto
Pedir una recomendación de lenguaje produce, con frecuencia, una comparación de características y de rendimiento en abstracto, sin preguntar qué hace la aplicación, quién la mantiene ni dónde está el tiempo hoy.
Y ante un problema de rendimiento, la propuesta de reescribir en un lenguaje más rápido aparece antes que la pregunta de si hay consultas sin índice, porque la primera es una respuesta general y la segunda exige ver el sistema concreto.
Las frases que cambian la respuesta son dar las mediciones reales y preguntar dónde está el cuello de botella antes de hablar de lenguajes, y mencionar explícitamente qué conoce el equipo y qué librerías se necesitan.
Y conviene hacer la pregunta incómoda ante cualquier propuesta de reescritura: qué problema medido resuelve, y qué alternativa más barata se descartó y por qué. Si no hay respuesta concreta a ninguna de las dos, la reescritura probablemente no está justificada.