Un desarrollador que lleva seis meses usando un asistente para todo suele describir la misma sensación: va mucho más rápido en lo que ya sabía hacer, y mucho más lento en lo que no. La aceleración es real, pero no se reparte por igual.
Entender dónde se reparte bien y dónde no es la diferencia entre usar la herramienta y depender de ella. Y no se decide por el lenguaje ni por el tamaño de la tarea, sino por dos preguntas que casi nadie se hace antes de escribir el encargo.
Las dos preguntas que ordenan cualquier tarea
Antes de delegar algo conviene responder dos cosas, y ambas son sobre ti, no sobre el modelo.
La primera: ¿sabrías verificar que el resultado está bien? No si te parece razonable al leerlo, sino si tienes una forma concreta de comprobarlo: una prueba que ejecutar, una salida que comparar, un comportamiento que reproducir. Si la única verificación disponible es tu impresión al leer el código, no estás revisando, estás confiando.
La segunda: ¿cuánto cuesta equivocarse? Un formateo mal hecho se revierte en un minuto. Un esquema de base de datos mal diseñado se arrastra durante años, porque para cuando se nota ya hay datos dentro y código que depende de su forma.
Estas dos preguntas no miden la dificultad de la tarea. Escribir un parser de fechas es técnicamente más difícil que decidir cómo se relacionan usuarios y organizaciones, pero el parser se verifica con veinte casos de prueba y el modelo de datos no se verifica con nada hasta que es tarde.
De ahí sale una regla sencilla: delega en función de la verificabilidad y del coste del error, no en función de si la tarea te parece aburrida.
Las cuatro combinaciones y qué hacer en cada una
Cruzando las dos preguntas salen cuatro situaciones, y cada una pide un trato distinto.
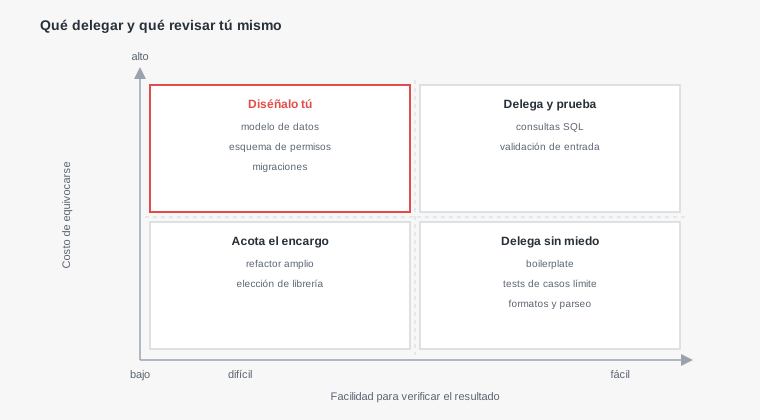
Fácil de verificar y barato de equivocarse. Aquí no hay debate: código repetitivo, conversiones de formato, expresiones regulares, configuración inicial de un proyecto, pruebas para casos límite que ya identificaste. Delegar esto es ganancia neta.
Fácil de verificar y caro de equivocarse. Una consulta SQL que alimenta un informe de facturación entra aquí: si está mal el daño es serio, pero puedes ejecutarla contra datos conocidos y comparar. Se delega, pero la prueba no es opcional.
Difícil de verificar y barato de equivocarse. Un refactor amplio, la elección de una librería. El error no es catastrófico pero tampoco lo detectas leyendo. La salida es acotar: pide el cambio en trozos que sí puedas revisar, uno por uno.
Difícil de verificar y caro de equivocarse. El modelo de datos, el esquema de permisos, los límites entre servicios, la estrategia de migraciones. Esto se diseña antes de abrir el chat. Puedes usar el asistente para contrastar el diseño, pero la decisión es tuya.
Dónde el asistente rinde de verdad
Hay un patrón claro en las tareas donde la ganancia es mayor, y tiene que ver con la naturaleza del problema más que con su tamaño.
Rinde donde el trabajo es conocido pero tedioso: escribir el DTO que refleja una tabla, convertir una respuesta de una forma a otra, generar las cincuenta líneas de configuración que siempre son iguales. Son tareas donde ya sabes cómo debe quedar el resultado, y el valor está en no teclearlo.
Rinde donde hay que recordar sintaxis que usas poco. Una expresión regular para validar un formato, la sintaxis de una consulta con ventanas en SQL, las opciones de un comando que consultas cada seis meses. Aquí la verificación es inmediata: lo ejecutas.
Rinde como traductor entre contextos: pasar un script de Bash a Python, convertir una función de una librería a otra equivalente, adaptar un ejemplo de la documentación a tu estructura. Tienes el original para comparar.
Y rinde mucho generando casos de prueba a partir de una regla que tú enunciaste. Si le dices que el descuento aplica entre el 5 y el 30 por ciento solo para pedidos de más de cien euros, produce los casos límite alrededor de esos números mejor y más rápido que tú a las siete de la tarde.
Dónde rinde poco y cuesta caro
El reverso tiene también un patrón, y no es el que suele mencionarse.
Rinde mal en decisiones que dependen de contexto que no está en el código. Cuántos usuarios esperas, qué presupuesto tienes, qué sabe tu equipo mantener, qué restricción legal te aplica, qué pieza vas a cambiar en seis meses. Nada de eso está en los archivos que lee, así que responde con el promedio de lo que ha visto, que suele ser una arquitectura para una escala que no tienes.
Rinde mal en diagnósticos donde el síntoma está lejos de la causa. Una fuga de memoria, una condición de carrera, una consulta que se degrada solo con datos reales. El asistente ve el fragmento que le pasas y propone un cambio plausible sobre ese fragmento. A veces el síntoma desaparece sin que la causa se toque, que es el peor de los resultados posibles.
Rinde mal en todo lo que exige coherencia a lo largo de muchos archivos. Sin el proyecto entero en contexto, cada respuesta es localmente correcta y globalmente inconsistente: tres formas distintas de manejar errores, dos convenciones de nombres, validación duplicada en dos capas.
Y rinde mal cuando el criterio de éxito no se puede escribir. "Que quede más limpio", "que sea más mantenible", "que rinda mejor" no son encargos verificables. Sin un número o un comportamiento concreto, no hay forma de saber si el resultado es mejor o solo distinto.
Por qué el modelo de datos no se delega
De todo lo anterior, hay una categoría que merece nombre propio porque es la que más daño hace y la que más se delega por despiste.
El esquema de la base de datos es la decisión más difícil de revertir de un proyecto. Cambiar una función es cuestión de editarla. Cambiar la relación entre dos tablas cuando ya hay cien mil filas implica una migración, un periodo donde conviven las dos formas, y código que entiende ambas.
El asistente, sin más contexto, produce el esquema más común para el nombre del dominio. Si le pides un modelo para una tienda, te da productos, pedidos y clientes con las relaciones habituales. El problema no es que esté mal, es que no sabe si vendes productos con variantes, si un pedido puede tener varios destinatarios, si los precios cambian con el tiempo y necesitas conservar el histórico.
Esas preguntas son el diseño, y las respondes tú. Lo que sí puedes delegar, después, es la escritura de las migraciones y de las consultas sobre un esquema que ya decidiste.
Una forma práctica de separar las dos cosas: escribe el esquema en un archivo, con comentarios sobre por qué cada relación es así, y pásaselo como punto de partida en lugar de pedirle que lo invente.
Cómo cambiar un encargo de cuadrante
Una tarea difícil de verificar no está condenada a serlo. Casi siempre se puede mover al cuadrante de al lado con un poco de trabajo previo.
La forma más directa es escribir la prueba antes que el código. Si defines qué debe cumplir el resultado, el encargo pasa de "hazlo bien" a "haz que esto pase", y la verificación deja de ser una opinión.
# Fijar el criterio antes de pedir la implementación:
# 1. escribes la prueba y compruebas que falla
npm test -- calculo-descuento.test.js
# 2. pides la implementación
# 3. la misma prueba decide si el resultado sirve
npm test -- calculo-descuento.test.js
La segunda forma es acotar el alcance. Un refactor de un módulo entero no se revisa; el mismo refactor en seis pasos, cada uno con su commit, sí.
# Un cambio por commit, revisable de uno en uno
git add -p                          # elegir trozo a trozo qué entra
git commit -m "extraer validación de fecha a su propia función"

# Ver el tamaño real de lo que estás a punto de revisar
git diff --stat
git diff --stat | tail -1           # total de archivos y líneas
La tercera es fijar un punto de retorno antes de empezar. Si el cambio sale mal, volver debe costar un comando, no una tarde.
# Rama desechable para un experimento
git switch -c prueba/refactor-pagos

# Si no funcionó, volver al punto anterior y borrar la rama
git switch main
git branch -D prueba/refactor-pagos

# Si ya habías mezclado y quieres deshacer solo ese commit
git revert <hash>
El tamaño del encargo importa más que su dificultad
Hay una correlación que se nota enseguida al revisar resultados: la calidad no cae con la dificultad, cae con la amplitud.
Un encargo que toca una función sale bien casi siempre, aunque la función sea compleja. Un encargo que toca doce archivos sale mal casi siempre, aunque cada cambio individual sea trivial. La razón es que en el segundo caso las decisiones se multiplican y ninguna se consulta contigo.
El umbral que funciona en la mayoría de los casos está en el orden de un par de cientos de líneas por encargo. Por encima de eso, la revisión se degrada a lectura en diagonal.
El criterio de la explicación
Hay una prueba rápida que separa bien lo que puedes delegar de lo que no, y se aplica antes de escribir nada.
Si no eres capaz de explicar en dos frases qué debe hacer el código y cómo sabrás que funciona, el encargo no está listo. No porque el modelo no vaya a producir algo, sino porque vas a aceptar lo que produzca sin criterio para juzgarlo.
Esa incapacidad de explicar suele indicar una de dos cosas: o el problema no está entendido todavía, o hay una decisión de diseño pendiente que estás intentando saltarte. En ambos casos, el paso siguiente es pensar, no preguntar.
El asistente sí ayuda en esa fase, pero en otro modo: pedirle que enumere las opciones y sus consecuencias es útil; pedirle que elija por ti, no.
Documentación y comentarios: un caso con trampa
Generar documentación parece la delegación ideal, y en parte lo es, pero tiene un fallo característico.
Lo que genera bien es la descripción de qué hace el código: parámetros, tipos, valor de retorno, estructura. Eso está en el propio código y la traducción es fiable.
Lo que no puede generar es el porqué: por qué hay un caso especial para un cliente concreto, por qué este reintento espera tres segundos y no uno, por qué no se usa la librería obvia. Esa información nunca estuvo en el código, y es justamente la que hace falta dentro de un año.
La división que funciona: que genere las firmas y descripciones mecánicas, y escribe tú las tres o cuatro frases de contexto que explican las decisiones raras.
Lo que se pierde al delegar bien
Incluso con una delegación sensata hay un coste, y conviene tenerlo presente porque no se ve en el momento.
Las tareas tediosas que ahora delegas eran, en parte, cómo se aprendía un dominio. Escribir a mano la tercera integración con una pasarela de pagos es aburrido, pero al terminarla entiendes cómo funcionan los reintentos, por qué existen los identificadores de idempotencia y qué pasa cuando llega un webhook duplicado.
Si esas tres integraciones las genera el asistente y funcionan, tienes el código y no tienes el entendimiento. Mientras nada falle, da igual. El día que falle en producción, la diferencia es enorme.
No hay que renunciar a la velocidad para evitarlo, pero sí conviene elegir a conciencia dos o tres áreas del proyecto que quieres entender de verdad y trabajarlas a mano, aunque el asistente pudiera hacerlas.
Qué se le escapa a una IA con esto
Preguntarle al propio asistente qué conviene delegarle produce respuestas correctas en lo genérico e inútiles en lo concreto, por un motivo estructural.
No sabe qué sabes tú. No tiene forma de estimar si vas a detectar un error en la consulta que te propone, así que trata igual al que lleva diez años con SQL y al que copió su primera consulta ayer.
Tampoco conoce el coste de equivocarse en tu caso. Un esquema mal diseñado en un proyecto personal se rehace en una tarde; el mismo esquema con clientes dentro es un proyecto de meses. Esa diferencia no está en el código.
Y tiende a aceptar el encargo tal como lo formulaste. Si pides una arquitectura completa, la da, sin señalar que la decisión del modelo de datos que contiene es la que más te va a costar cambiar después.
La forma de usarlo bien en esta fase es invertir la pregunta: en lugar de pedir la solución, pídele que enumere las decisiones irreversibles que contiene la tarea y qué información le falta para decidirlas. Esa lista sí es útil, y es exactamente la lista de lo que no deberías delegar.