Cuando alguien pide tiempo real, rara vez está pidiendo milisegundos. Casi siempre está pidiendo que la pantalla no se quede con información vieja mientras el usuario la mira, que es un problema distinto y bastante más barato de resolver.
La diferencia importa porque las dos respuestas tienen costos muy distintos. Una conexión permanente por usuario cambia cómo se despliega, cómo se escala y cómo se depura el sistema. Recargar una sección cada treinta segundos no cambia nada.
Empezar por la pregunta correcta
El planteamiento habitual, si esto necesita tiempo real, no tiene una respuesta útil porque el término no está definido. Casi cualquier cosa se beneficia de ir más rápido.
La pregunta que sí se puede responder es otra: cuántos segundos puede estar desactualizado este dato sin que el usuario note un problema. Tiene una respuesta concreta, distinta para cada pantalla, y de ella sale directamente la solución técnica.
Conviene además responderla por dato y no por aplicación. En un mismo sistema, el contador de mensajes sin leer y el informe mensual tienen tolerancias que se diferencian en cuatro órdenes de magnitud, y tratarlos igual significa pagar de más en uno de los dos.
Y conviene responderla con el uso real delante. La intuición tiende a exagerar la urgencia de todo, porque es fácil imaginar al usuario mirando fijamente esa pantalla, cuando en la práctica la abre tres veces al día.
Cuánto retraso tolera de verdad cada caso
Situar el caso propio en una escala ayuda más que cualquier discusión sobre tecnologías.
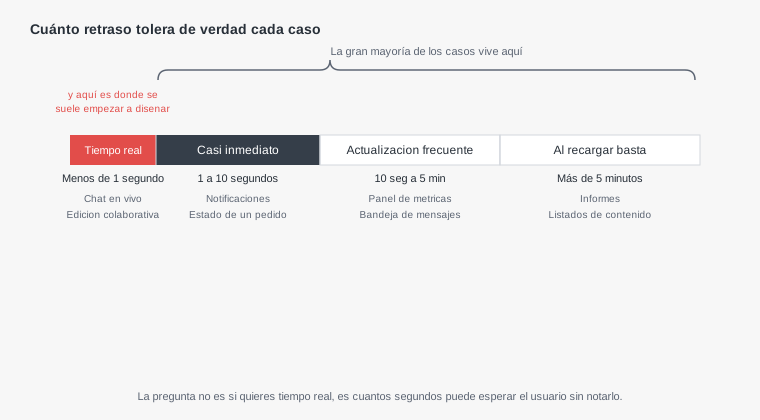
La observación importante del gráfico es la proporción. El tramo que exige tiempo real de verdad es el más estrecho, y es donde se suele empezar a diseñar, porque es el que aparece en los ejemplos y en las demostraciones.
Los otros tres tramos cubren la mayoría de las pantallas de una aplicación normal, y todos se resuelven con mecanismos más simples que una conexión permanente.
Las cinco preguntas que cierran la decisión
Ninguna es técnica. Con responderlas honestamente, la elección suele quedar hecha.
1. ¿Hay alguien esperando delante de la pantalla?
Es la que más decisiones cierra. Si el usuario provoca la acción y espera el resultado, el retraso se nota. Si el cambio lo provoca otra persona o un proceso, y el usuario simplemente lo verá cuando mire, la urgencia es mucho menor.
Un panel de administración que alguien consulta dos veces al día no necesita empujar cambios: le basta con estar al día cuando se abre. Y esa distinción, entre estar al día al abrir y estar al día continuamente, es la que separa el trabajo de una tarde del de una semana.
2. ¿Cuántos usuarios simultáneos habrá?
El número cambia qué mecanismos son viables. Con veinte usuarios, consultar cada pocos segundos es irrelevante para el servidor. Con diez mil, esa misma consulta es tráfico serio.
El cálculo es directo: usuarios activos, dividido por el intervalo en segundos, da las peticiones por segundo que hay que sostener. Y conviene hacerlo con la cifra de hoy, no con la esperada.
3. ¿Con qué frecuencia cambian los datos realmente?
Aquí aparece el desperdicio más común. Si los datos cambian tres veces por hora y se consultan cada cinco segundos, el noventa y nueve por ciento de las peticiones responden que no hay novedades.
Cuando los cambios son raros pero deben verse rápido cuando ocurren, el empuje desde el servidor gana claramente. Cuando son frecuentes y regulares, consultar periódicamente resulta más simple y casi igual de bueno.
4. ¿La información fluye en un sentido o en los dos?
Si el servidor solo envía y el cliente solo recibe, hay mecanismos más simples que una conexión bidireccional. Si el cliente también necesita enviar continuamente, como en un editor colaborativo o un juego, entonces sí hace falta un canal en ambos sentidos.
Este punto descarta opciones con rapidez, y sin embargo casi nunca se plantea antes de elegir la tecnología.
5. ¿Qué pasa si un cambio se pierde?
Es la pregunta incómoda y la que más incidentes evita. Ninguna conexión es permanente de verdad: se caen, el móvil cambia de red, el portátil se suspende.
Si perder una actualización solo significa ver algo desactualizado unos segundos, cualquier mecanismo sirve. Si significa perder un mensaje o no enterarse de un pago, hace falta que el estado se pueda reconstruir al reconectar, y eso condiciona el diseño mucho más que la elección entre una tecnología u otra.
Las cuatro respuestas posibles
Con esas preguntas respondidas, casi todos los casos caen en uno de estos cuatro sitios.
- Recargar al entrar, y nada más. Suficiente para informes, configuraciones y listados que cambian poco. Es la opción por defecto y la que menos se considera.
- Consultar periódicamente. Una petición cada pocos segundos o minutos desde el cliente. Simple, sin infraestructura nueva, y suficiente para la mayoría de los paneles.
- Empuje desde el servidor en un solo sentido. El servidor envía cuando hay novedades y el cliente escucha. Encaja en notificaciones, estados de proceso y contadores.
- Canal bidireccional. Ambos lados envían en cualquier momento. Necesario en chats, edición colaborativa y cualquier cosa con interacción continua.
La asimetría entre ellas conviene tenerla presente: subir de nivel es sencillo y bajar también, porque el mecanismo de transporte suele estar aislado en una capa. Lo que no es reversible con facilidad es haber diseñado toda la aplicación asumiendo un estado compartido en vivo cuando no hacía falta.
Medir antes de decidir
Hay una comprobación que cuesta cinco minutos y que suele cambiar la conversación, porque sustituye la intuición sobre la frecuencia de cambio por un dato.
# ¿Cuántas veces cambió esta tabla en la última hora?
# (asumiendo una columna de fecha de actualización)
psql -c "SELECT count(*) FROM pedidos WHERE actualizado_en > now() - interval '1 hour';"

# Cuánto pesa la respuesta que se consultaría en cada sondeo
curl -s -o /dev/null -w 'bytes: %{size_download}  tiempo: %{time_total}s\n' \
  https://midominio.com/api/pedidos/estado
Con esos dos números, el cálculo del costo de consultar periódicamente deja de ser una discusión de opiniones. Peso de la respuesta, por usuarios activos, dividido por el intervalo, da el ancho de banda por segundo.
Y si el resultado es asumible, la decisión está tomada: consultar periódicamente es más simple de desplegar, más fácil de depurar y no exige mantener conexiones abiertas.
Lo que se paga al elegir una conexión permanente
Conviene conocer el costo real antes de asumirlo, porque no está en escribir el código sino en operarlo.
Cada conexión abierta ocupa memoria en el servidor durante todo el tiempo que dure. Mil usuarios conectados son mil conexiones que hay que sostener, y eso cambia el dimensionado de la máquina.
El despliegue se complica: al reiniciar el servicio, todas las conexiones se cortan a la vez y todos los clientes reconectan simultáneamente, lo que produce un pico justo después de cada despliegue. Hace falta reconexión con espera creciente en el cliente para que eso no tumbe el servidor.
Y si hay más de una instancia de la aplicación, aparece el problema de que un usuario conectado a una instancia no recibe los eventos que genera otra. Resolverlo exige un canal común entre instancias, que es infraestructura adicional.
Nada de esto es prohibitivo, y todo es trabajo que no existe si el caso se resolvía consultando cada treinta segundos.
El patrón intermedio que resuelve muchos casos
Hay una solución que combina lo mejor de los dos extremos y que se usa poco porque no tiene nombre llamativo.
Consiste en consultar periódicamente, pero de forma condicional: el cliente pregunta si hay algo nuevo desde la última vez, y el servidor responde con muy pocos bytes cuando no lo hay. Con las cabeceras estándar del protocolo, esa respuesta vacía es mínima.
# El servidor devuelve un identificador de version en la respuesta
curl -sI https://midominio.com/api/pedidos | grep -i etag
# ETag: "a3f21b"

# El cliente pregunta solo si cambió: si no, responde 304 sin cuerpo
curl -s -o /dev/null -w '%{http_code}\n' \
  -H 'If-None-Match: "a3f21b"' https://midominio.com/api/pedidos
# 304
Con eso, mil usuarios consultando cada diez segundos generan tráfico modesto mientras no haya novedades, y la complejidad del sistema no cambia en absoluto.
Es la opción que conviene descartar explícitamente antes de montar cualquier cosa más elaborada, y la que resuelve la mayoría de los paneles internos.
Qué se le escapa a una IA con esto
Pedir que una pantalla se actualice en tiempo real produce, con mucha fiabilidad, una implementación con conexión bidireccional, servidor de eventos y cliente que reconecta. Funciona y suele ser dos niveles más de lo necesario.
La razón es que el término tiempo real activa el patrón más completo que existe, y nadie mencionó cuántos usuarios hay, cada cuánto cambian los datos ni si alguien está esperando delante.
La frase que cambia la respuesta es dar esos tres datos y preguntar por la opción más simple que los cumpla. Decir que son cincuenta usuarios, que los datos cambian unas veces por hora y que un retraso de treinta segundos es aceptable suele devolver una consulta periódica de diez líneas.
Y conviene pedir siempre qué pasa al perder la conexión y al reconectar. Si esa parte no aparece, la implementación va a funcionar perfectamente en desarrollo, donde nadie cambia de red ni suspende el portátil, y va a fallar de forma intermitente en producción.
Cómo dejar la decisión abierta
Elegir hoy no obliga a acertar para siempre, siempre que la elección no se filtre por todo el código.
La forma de conseguirlo es que el resto de la aplicación no sepa cómo llegan los datos. Una única función que entrega actualizaciones, y detrás de ella el mecanismo que sea. Cambiar de consultar periódicamente a recibir empujes se convierte entonces en tocar un archivo.
Conviene además que el estado se pueda reconstruir siempre con una petición normal, aunque haya un canal en vivo. Es lo que permite recuperarse de una desconexión, lo que hace posible degradar a consultas si el canal falla, y lo que mantiene el sistema depurable con las herramientas de siempre.
Con esas dos condiciones, empezar por lo simple deja de ser una apuesta y pasa a ser el camino ordenado: se sube de nivel el día que una medición lo justifique, no el día que alguien lo imagine.