La primera cola de un proyecto casi nunca se instala por una decisión de arquitectura. Se instala porque algo tarda demasiado: el registro de un usuario se quedaba diez segundos esperando a que saliera el correo de bienvenida, y alguien decidió sacar eso de la petición.
Ese motivo es perfectamente válido y explica por qué conviene entender bien la herramienta antes de que aparezcan tres colas más y nadie recuerde qué hace cada una.
Qué resuelve realmente una cola
Hay tres problemas distintos que se resuelven con esto, y conviene saber cuál es el tuyo porque condiciona todo lo demás.
El primero es devolver la respuesta antes. El usuario no tiene por qué esperar a que se genere un informe o se envíe un correo. Se apunta la tarea, se responde, y el trabajo ocurre después.
El segundo es absorber picos. Si llegan mil peticiones en un minuto y el sistema procesa cien por minuto, la cola acumula el resto y las va sirviendo al ritmo que aguanta, en lugar de caerse.
El tercero es desacoplar servicios, que quien produce el mensaje no necesite saber quién lo consume ni que esté disponible en ese momento.
Los tres primeros casos se resuelven con casi cualquier herramienta. Es el cuarto, volver a leer mensajes antiguos, el que obliga a elegir con cuidado, y de ahí sale la distinción principal de este artículo.
Repartir trabajo no es lo mismo que registrar lo que pasó
Bajo el nombre común de cola conviven dos modelos con comportamientos distintos, y mezclarlos es la causa de la mayoría de las elecciones equivocadas.
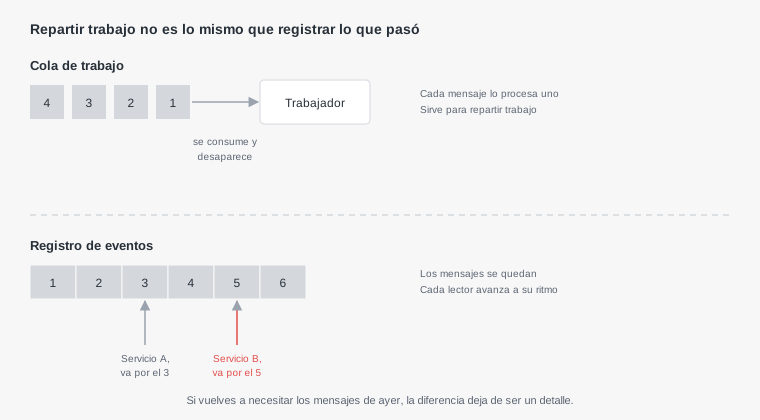
En una cola de trabajo, el mensaje se entrega a un consumidor, se procesa y desaparece. Es un reparto de tareas: si hay diez trabajadores, cada tarea la hace uno.
En un registro de eventos, los mensajes se quedan escritos durante un plazo y cada lector lleva su propia marca de por dónde va. Varios servicios distintos leen lo mismo, cada uno a su ritmo, y uno nuevo puede empezar desde el principio.
La pregunta que distingue los dos casos es directa: ¿si mañana añades un servicio que necesita los mensajes de la semana pasada, deberían estar disponibles? Si la respuesta es sí, necesitas el segundo modelo.
Las tres opciones habituales, comparadas
| RabbitMQ | Kafka | SQS | |
|---|---|---|---|
| Modelo | Cola de trabajo | Registro de eventos | Cola de trabajo |
| El mensaje tras leerse | Desaparece | Se queda el plazo fijado | Desaparece |
| Varios consumidores del mismo mensaje | Con configuración | Su forma natural | Con otro servicio delante |
| Releer lo antiguo | No | Sí | No |
| Orden garantizado | Por cola | Por partición | Solo en el modo FIFO |
| Quién lo opera | Tú | Tú, y no es poco | El proveedor |
| Enrutado complejo | Su especialidad | Limitado | Básico |
| Cuándo encaja | Tareas y flujos con reglas | Muchos eventos, varios lectores | Empezar sin operar nada |
La fila de quién lo opera es la que más pesa en un proyecto pequeño. Un servicio gestionado se configura en minutos; un sistema propio hay que instalarlo, vigilarlo, respaldarlo y actualizarlo, y eso es trabajo continuo que compite con construir el producto.
Conviene añadir una cuarta opción que no está en la tabla y que resuelve más casos de los que parece: una tabla en la base de datos que ya tienes. Con un campo de estado y una consulta que toma el siguiente pendiente, se cubre el caso de sacar trabajo de la petición sin añadir ninguna infraestructura.
La cola que ya tienes sin saberlo
Antes de instalar nada, conviene valorar esta opción, porque para volúmenes moderados funciona perfectamente y evita un componente más que mantener.
CREATE TABLE tareas (
    id          bigserial PRIMARY KEY,
    tipo        text NOT NULL,
    datos       jsonb NOT NULL,
    estado      text NOT NULL DEFAULT 'pendiente',
    intentos    int  NOT NULL DEFAULT 0,
    ejecutar_en timestamptz NOT NULL DEFAULT now()
);

-- Tomar la siguiente tarea sin que dos trabajadores tomen la misma
UPDATE tareas SET estado = 'en_curso', intentos = intentos + 1
 WHERE id = (
     SELECT id FROM tareas
      WHERE estado = 'pendiente' AND ejecutar_en <= now()
      ORDER BY id
      FOR UPDATE SKIP LOCKED
      LIMIT 1
 )
RETURNING *;
La instrucción clave es la que salta las filas bloqueadas por otra transacción: es lo que permite tener varios trabajadores sin que se pisen. Sin ella, dos procesos pueden tomar la misma tarea.
Esta solución deja de ser adecuada cuando el volumen crece mucho, cuando hacen falta varios consumidores independientes del mismo evento o cuando la tabla empieza a competir por recursos con la carga principal de la aplicación. Hasta entonces, es la opción con menos piezas móviles.
Lo que hay que resolver use la herramienta que use
Estos cuatro puntos aparecen en cualquier sistema de mensajes y son los que deciden si funciona bien un martes cualquiera.
- Los duplicados. La garantía habitual es que el mensaje llega al menos una vez, así que el consumidor tiene que tolerar procesar el mismo dos veces.
- Los reintentos con espera creciente. Reintentar de inmediato ante un servicio caído solo añade carga a lo que ya está mal.
- La cola de lo que no se pudo procesar. Tras un número acotado de intentos, el mensaje se aparta en lugar de reintentarse indefinidamente bloqueando a los que vienen detrás.
- La alerta cuando esa cola deja de estar vacía. Sin ella es un cajón donde los errores se acumulan en silencio.
Ese último punto es el que más veces falta. Una cola de mensajes fallidos que nadie mira es exactamente la situación que se quería evitar al montar todo esto.
El trabajador, que es la mitad que nadie diseña
Toda la atención se va en elegir la cola y casi ninguna en el proceso que consume los mensajes, que es donde ocurren la mayoría de los problemas reales.
Un trabajador es un programa que corre indefinidamente, y eso trae condiciones que un endpoint web no tiene. Tiene que sobrevivir a que la conexión con la base se caiga y vuelva. Tiene que liberar la memoria que acumula, porque un proceso de días amplifica cualquier fuga pequeña. Y tiene que terminar bien cuando alguien lo detiene.
Ese último punto es el que más datos corrompe. Si el proceso recibe la señal de apagado a mitad de un mensaje y muere de inmediato, ese mensaje queda a medias: ni completado ni devuelto a la cola.
La forma correcta es atender la señal, dejar de tomar mensajes nuevos, terminar el que está en curso y salir. Son unas pocas líneas y evitan la clase de incidente que aparece exactamente el día del despliegue.
$seguir = true;
pcntl_async_signals(true);
pcntl_signal(SIGTERM, function () use (&$seguir) { $seguir = false; });

while ($seguir) {
    $tarea = $repo->tomarSiguiente();
    if ($tarea === null) { sleep(1); continue; }

    $procesador->ejecutar($tarea);   // termina esta antes de salir
}
Conviene además que el trabajador se reinicie solo si muere, con el supervisor de procesos del sistema, y que registre al arrancar y al parar. Un trabajador caído en silencio es indistinguible de una cola vacía.
Cuando la cola crece y no baja
Hay una situación que conviene reconocer pronto porque tiene varias causas distintas y cada una pide una respuesta diferente.
Si la cola crece de forma sostenida, puede ser que lleguen más mensajes de los que se procesan, y entonces la respuesta es añadir trabajadores o hacer más rápido el procesamiento. Puede ser que los trabajadores estén caídos, y entonces no hay nada que escalar. O puede ser que un mensaje esté fallando en bucle y bloqueando a los que vienen detrás.
Distinguirlas exige mirar dos números, no uno: cuántos mensajes hay pendientes y cuántos se completan por minuto. Con el primero solo, las tres causas se parecen.
Y conviene fijar de antemano qué hacer si la cola se descontrola. Descartar mensajes viejos que ya no tienen sentido, priorizar unos tipos sobre otros o aceptar el retraso son decisiones que se toman mejor con calma que durante el incidente.
Lo que se vuelve más difícil
Conviene decir también el precio, porque desacoplar tiene uno y no es pequeño.
Depurar deja de ser lineal. Una operación que antes ocurría dentro de una petición ahora pasa por un mensaje, un consumidor y quizá otra cola. Seguirla exige arrastrar un identificador común por todas las piezas, y sin eso el diagnóstico se convierte en cruzar marcas de tiempo a mano.
El estado se vuelve eventual. El usuario pulsa y recibe respuesta antes de que el trabajo ocurra, así que la interfaz tiene que reflejar que algo está en proceso. Si no se contempla, el usuario recarga, no ve su acción reflejada y la repite.
Y aparecen fallos que antes no existían: mensajes que se procesan en orden distinto al esperado, consumidores que se quedan atascados, colas que crecen sin que nadie lo note. Todos se gestionan, y todos son trabajo que no existía antes.
Cómo elegir sin quedarte atrapado
La decisión es más reversible de lo que parece si se toma una precaución al escribir el código.
Lo que ata no es la herramienta, es que sus detalles se filtren por toda la aplicación. Si el código de negocio llama a una función propia que encola una tarea, cambiar lo que hay detrás es tocar un archivo. Si llama directamente a la librería del proveedor desde veinte sitios, la migración es otra cosa.
Con esa precaución, la recomendación práctica para un proyecto pequeño es empezar por la tabla en la base de datos, pasar a un servicio gestionado cuando el volumen o la operación lo justifiquen, y llegar a un registro de eventos solo cuando de verdad haya varios consumidores independientes que necesiten releer.
La asimetría conviene tenerla presente: subir de nivel es un trabajo acotado, y bajar desde una infraestructura compleja que nadie necesitaba es mucho más caro, porque para entonces el diseño ya asumió cosas que la opción simple no ofrece.
Qué se le escapa a una IA con esto
Pedir que se saque una tarea de la petición produce, con bastante fiabilidad, una propuesta con un sistema de colas completo y sus componentes, incluso cuando el proyecto envía cuarenta correos al día.
El motivo es el habitual: el patrón que abunda en la documentación es el de sistemas grandes, y nadie mencionó el volumen ni quién va a operar eso.
La frase que cambia la respuesta es dar el número real de tareas por hora y preguntar si se puede resolver con la base de datos que ya existe. Con cifras modestas, la respuesta honesta suele ser que sí.
Y cuando sí hace falta una cola, conviene pedir explícitamente las cuatro cosas de antes: tolerancia a duplicados, reintentos con espera creciente, cola de fallidos y alerta sobre ella. El consumidor generado por defecto casi nunca las trae, porque son justo lo que solo se necesita cuando algo va mal.
# Comprobación que conviene tener a mano: ¿la cola se está vaciando?
psql -c "SELECT estado, count(*) FROM tareas GROUP BY estado;"

# ¿Hay tareas atascadas en curso desde hace demasiado?
psql -c "SELECT count(*) FROM tareas
         WHERE estado = 'en_curso'
           AND ejecutar_en < now() - interval '15 minutes';"