Las tres aparecen juntas en cualquier comparación de estilos de API, y esa vecindad genera una expectativa equivocada: que hay que elegir una y que la elegida sustituye a las demás.
En la práctica, lo habitual en un sistema mediano es tener las tres a la vez. REST hacia fuera, gRPC entre servicios internos, y GraphQL delante de una aplicación con pantallas que necesitan datos de varios sitios. No es indecisión: es que resuelven problemas distintos.
Qué decide cada una
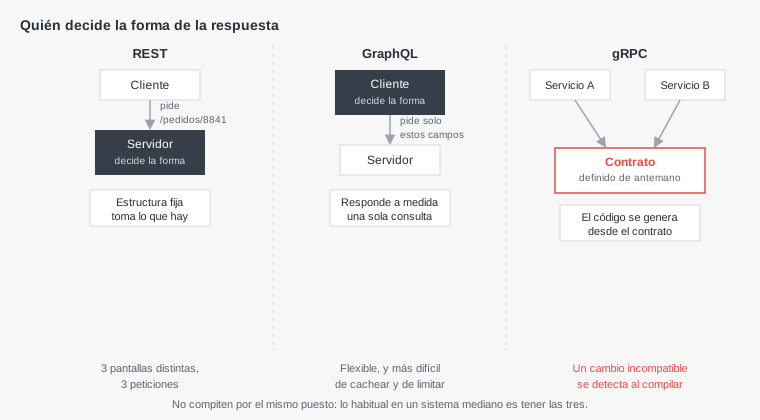
La diferencia de fondo no está en el rendimiento ni en la moda, sino en quién decide la forma de la respuesta.
En REST, la decide el servidor. Cada dirección devuelve una estructura fija, y el cliente toma lo que hay. Es predecible y significa que una pantalla que necesita datos de tres sitios hace tres peticiones.
En GraphQL, la decide el cliente. Pide exactamente los campos que va a usar, de varios recursos, en una sola consulta. Elimina el ir y venir a costa de que el servidor ya no sabe de antemano qué le van a pedir.
En gRPC, la decide un contrato escrito de antemano que ambos lados comparten y del que se genera el código. Ni cliente ni servidor improvisan: si el contrato cambia, los dos se enteran al compilar.
Esa tercera propiedad es la que explica dónde encaja gRPC: entre piezas que controlas tú, donde poder cambiar el contrato con garantías vale más que la flexibilidad.
Las tres, comparadas donde importa
| REST | GraphQL | gRPC | |
|---|---|---|---|
| Quién define la respuesta | El servidor | El cliente | Un contrato compartido |
| Formato en el cable | Texto (JSON) | Texto (JSON) | Binario |
| Se puede probar con curl | Sí, directo | Sí, con cuerpo | Necesita herramienta |
| Caché del navegador y CDN | Nativa | Difícil | No aplica |
| Varias peticiones por pantalla | Frecuente | Una sola | Frecuente |
| Desde el navegador | Directo | Directo | Necesita intermediario |
| Tipado entre las partes | Por convención | Por esquema | Obligatorio |
| Dónde encaja mejor | API pública | Clientes con pantallas ricas | Servicio a servicio |
Las filas de la caché y del navegador son las que más decisiones cierran y las que menos se miran. Una API pública que se beneficia de caché en CDN pierde esa ventaja al pasar a GraphQL, porque todas las consultas van al mismo sitio con cuerpos distintos.
Y gRPC no se puede llamar directamente desde una página web: necesita una capa que traduzca, lo que añade una pieza más al despliegue. Por eso su terreno natural es la comunicación entre servidores.
Probarlas desde la terminal
Una diferencia práctica que se nota desde el primer día es cuánto cuesta inspeccionar cada una sin escribir código.
# REST: directo, legible, sin nada instalado
curl -s https://api.ejemplo.com/pedidos/8841 | jq .

# GraphQL: una sola dirección, la consulta va en el cuerpo
curl -s -X POST https://api.ejemplo.com/graphql \
  -H 'Content-Type: application/json' \
  -d '{"query":"{ pedido(id:8841) { total cliente { nombre } } }"}' | jq .

# gRPC: hace falta una herramienta, y el servidor puede describirse a sí mismo
grpcurl -plaintext localhost:50051 list
grpcurl -plaintext -d '{"id": 8841}' localhost:50051 pedidos.Pedidos/Obtener
Esa facilidad de inspección de REST no es un detalle menor: es lo que permite que alguien depure un problema en producción con las herramientas que ya tiene, sin preparar nada.
El problema que GraphQL resuelve de verdad
Conviene ser preciso, porque se adopta con frecuencia por razones que no son la suya.
El problema real es una aplicación con muchas pantallas distintas, cada una necesitando una combinación diferente de datos, y un equipo de interfaz que no quiere esperar a que el equipo de servidor le cree una dirección nueva para cada caso.
Ahí GraphQL elimina una dependencia organizativa: el cliente compone lo que necesita sin pedir permiso. Si ese problema no existe, porque el equipo es la misma persona, la ventaja principal desaparece y quedan solo los costos.
Y los costos son concretos. Hay que controlar la profundidad y el coste de las consultas, porque una consulta anidada puede tumbar el servidor. Hay que resolver el problema de las consultas en cascada, donde pedir una lista con sus relaciones genera cientos de consultas a la base. Y se pierde la caché sencilla del protocolo.
Dónde gRPC gana con claridad
Entre servicios internos, sus ventajas son reales y medibles, no teóricas.
El formato binario ocupa bastante menos que el mismo contenido en texto, lo que importa cuando hay miles de llamadas por segundo entre piezas. La conexión se reutiliza, evitando el coste de abrir una nueva por llamada.
Pero la ventaja que de verdad cambia el día a día es el contrato. Al generarse el código de ambos lados desde el mismo archivo, un cambio incompatible se detecta al compilar, no en producción. En un sistema con varios servicios que evolucionan por separado, eso elimina una categoría entera de fallos.
Soporta además flujos continuos en ambas direcciones sin trucos, lo que lo hace adecuado para transmitir datos entre servicios de forma constante.
Por qué REST sigue siendo la respuesta por defecto
Para una API pública o para un proyecto pequeño, REST sigue ganando por motivos que no aparecen en las comparaciones técnicas.
Lo entiende todo el mundo, incluidos quienes van a integrarse contigo. Se depura con herramientas universales. Aprovecha la caché del protocolo sin configurar nada. Y cualquier proxy, cortafuegos o red corporativa lo deja pasar sin problemas.
A eso se suma algo práctico: la documentación y los ejemplos de cualquier lenguaje asumen REST, así que integrarlo es el camino más transitado y el que menos sorpresas da.
La objeción habitual, que obliga a varias peticiones por pantalla, tiene soluciones más baratas que cambiar de tecnología: incluir las relaciones que se piden siempre, ofrecer un parámetro para seleccionar campos, o poner una capa a medida delante de un cliente concreto cuando de verdad haga falta.
Lo que se comparte, elijas lo que elijas
Hay decisiones que no dependen del estilo y que pesan más que la elección misma.
- Versionar desde el principio. En cuanto alguien externo consume tu API, cambiarla rompe su código. Con una versión en la dirección o en una cabecera, se pueden convivir dos durante la transición.
- Paginar siempre las listas. Un listado sin límite funciona con cien registros y se cae con cien mil, y el cambio posterior rompe a todos los clientes.
- Errores consistentes y con significado. Un formato único de error, con un código que el cliente pueda tratar, ahorra más tiempo que cualquier optimización.
- Límite de peticiones. Aplica igual a las tres, y en GraphQL además hay que limitar el coste de la consulta, no solo su número.
Estas cuatro determinan si la API envejece bien mucho más que si es REST o GraphQL, y sin embargo casi nunca están en la conversación de la elección.
El cambio que rompe a quien ya te consume
Hay una diferencia entre los tres estilos que solo se nota cuando la API lleva tiempo funcionando: qué ocurre el día que hay que cambiarla.
Añadir un campo nuevo es seguro en los tres. El problema son las modificaciones: renombrar algo, cambiar un tipo, eliminar lo que ya nadie parecía usar. Ahí cada estilo avisa de forma distinta.
En gRPC el contrato detecta la incompatibilidad al compilar, siempre que se respeten sus reglas de numeración de campos. Un número reutilizado para otra cosa es el error clásico, y produce datos corruptos en lugar de un fallo limpio.
En GraphQL el esquema permite marcar campos como obsoletos y, como cada cliente pide explícitamente lo que usa, se puede saber quién consume qué antes de retirar nada. Es la mejor posición de las tres para evolucionar sin romper.
En REST no hay aviso de ningún tipo: el cambio sale a producción y el cliente se entera fallando. Por eso la versión y un periodo de convivencia entre dos versiones importan más aquí que en los otros dos.
Saber quién usa qué antes de cambiarlo
La decisión de retirar un campo se toma mucho mejor con datos que con suposiciones, y el dato se obtiene de los registros de acceso que ya tienes.
# Qué endpoints se llaman de verdad, ordenados por uso
awk '{print $7}' /var/log/nginx/access.log \
  | sed 's/?.*//' | sort | uniq -c | sort -rn | head -20

# Quién sigue llamando a la versión antigua, y desde cuándo
grep '/api/v1/' /var/log/nginx/access.log \
  | awk '{print $1, $7}' | sort | uniq -c | sort -rn | head
Ese segundo comando es el que convierte la retirada de una versión en una decisión informada: si nadie la ha llamado en un mes, se puede apagar; si la llaman tres direcciones conocidas, hay que avisarles primero.
Conviene además registrar la versión y el cliente en cada petición, con una cabecera que identifique la integración. Sin eso, los registros dicen qué se llama pero no quién llama, que es justo la mitad que hace falta.
Cómo elegir sin quedarte atrapado
La recomendación práctica para un proyecto que empieza es REST, y no por conservadurismo: es la opción que deja más puertas abiertas.
Desde REST se puede añadir GraphQL delante cuando aparezcan clientes con necesidades complejas, y se puede añadir gRPC entre servicios cuando haya varios servicios. El camino inverso es más incómodo, porque para entonces el cliente ya asume que puede pedir lo que quiera.
Conviene además que la lógica de negocio no viva en la capa que expone la API. Si las reglas están en funciones propias y la capa de transporte solo traduce, añadir otro estilo encima es un trabajo acotado en lugar de una reescritura.
Esa separación es la misma precaución que hace reversibles casi todas las decisiones de esta guía, y aquí se paga sola la primera vez que hay que ofrecer los mismos datos por dos vías distintas.
Qué se le escapa a una IA con esto
Pedir una API produce, con mucha fiabilidad, endpoints REST correctos sin paginación, sin versión y con errores en formato libre. Los tres huecos aparecen porque nadie los mencionó y porque el ejemplo funciona sin ellos.
Con GraphQL el patrón es más delicado: el esquema generado suele resolver las relaciones consultando la base una vez por elemento, lo que produce cientos de consultas al pedir una lista. Funciona perfectamente con los diez registros de prueba y se degrada con datos reales.
Las frases que cambian la respuesta son pedir paginación y formato de error desde el principio, y en GraphQL pedir explícitamente que las relaciones se resuelvan por lotes en lugar de una por elemento.
Y conviene medir antes de aceptar cualquier propuesta de cambio de estilo por rendimiento, porque casi siempre el problema está en otro sitio:
# Cuánto pesa y cuánto tarda realmente la respuesta actual
curl -s -o /dev/null -w 'bytes: %{size_download}  total: %{time_total}s\n' \
  https://api.ejemplo.com/pedidos

# Cuántas consultas a la base genera una sola petición
# (PostgreSQL, contando sentencias durante un minuto)
psql -c "SELECT calls, mean_exec_time, query FROM pg_stat_statements
         ORDER BY calls DESC LIMIT 10;"
Si una petición genera doscientas consultas, cambiar de REST a gRPC no va a arreglar nada: el problema es cómo se piden los datos, y ese viaja con la aplicación a cualquier estilo que se elija.