La deuda técnica clásica se reconoce a simple vista. Un archivo de tres mil líneas, una función que hace ocho cosas, nombres de variables que no significan nada. Abres el código y la ves.
La que genera la IA es distinta. El código suele estar bien formateado, con nombres razonables y hasta comentarios. Parece limpio. Y sin embargo el proyecto se vuelve cada vez más difícil de tocar.
Eso pasa porque esta deuda no vive en el estilo del código. Vive en la distancia entre lo que el sistema hace y lo que tú entiendes que hace.
Código que funciona en producción y que nadie en el proyecto puede explicar: ni por qué está escrito así, ni qué pasa si se cambia, ni qué otra cosa depende de él.
No se mide en líneas ni en complejidad ciclomática. Se mide en cuánto tarda alguien en poder modificarlo con confianza.
Un linter no la detecta. Una métrica de cobertura tampoco. Por eso conviene aprender a reconocerla por otras señales, que casi siempre son de comportamiento y no de código.
Cómo se acumula, paso a paso
Nadie decide un martes acumular deuda. Se llega ahí con una secuencia de decisiones que por separado parecen razonables.
-
Semana 1
Le pides una funcionalidad y funciona al primer intento. No revisas el código a fondo porque no hay motivo: pasa las pruebas manuales y el cliente lo aprueba.
-
Semana 3
Aparece un caso borde. Pides el arreglo, llega, funciona. El archivo ya tiene una condición que no recuerdas haber pedido, pero el conjunto sigue andando.
-
Mes 2
Necesitas cambiar algo en esa zona. Ya no editas directamente: le pasas el archivo a la IA y le pides que lo modifique, porque leerlo entero te tomaría más tiempo del que tienes.
-
Mes 4
Un cambio en esa zona rompe algo en otra parte del sistema. Nadie preveía la conexión, porque la dependencia nunca fue explícita para ti.
-
Mes 6
Evitas tocar ese módulo. Cuando hay que cambiar algo cerca, prefieres agregar código nuevo al lado antes que modificar el que ya está. El sistema empieza a crecer por acumulación.
El punto de quiebre no es el mes 6. Es el mes 2, cuando dejas de leer y empiezas a delegar la edición. A partir de ahí cada cambio se apoya en un entendimiento que ya no tienes.
El código no se volvió malo. Tú dejaste de ser quien lo entendía.
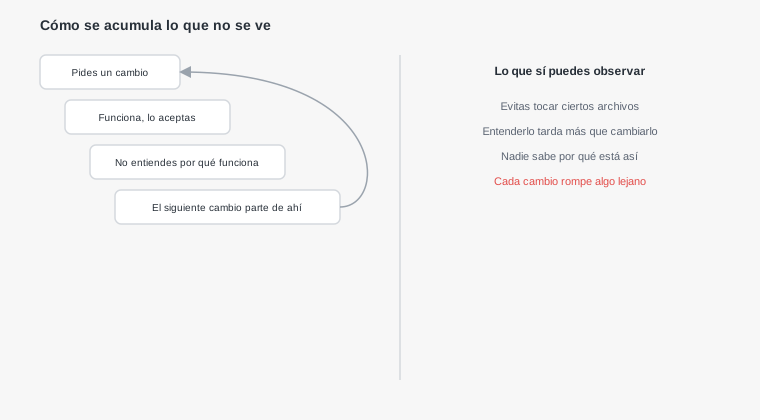
Las señales que sí puedes observar
Como la deuda no aparece en el código, hay que buscarla en cómo te comportas frente a él. Estas son las señales más confiables.
Evitas ciertos archivos
Es la señal más temprana y la más fácil de ignorar, porque se siente como una preferencia y no como un problema.
Si hay un archivo que prefieres no abrir, y cuando tienes que cambiar algo cerca de él buscas la forma de hacerlo por fuera, ese archivo ya es deuda. No importa que funcione.
La prueba concreta: intenta explicar en voz alta qué hace, de arriba abajo, sin leerlo. Si no puedes, no lo controlas.
No sabes qué se rompe si cambias algo
En un sistema que entiendes, puedes predecir el radio de impacto de un cambio antes de hacerlo. Sabes que tocar esta función afecta a esas tres pantallas y a ninguna más.
Cuando esa predicción desaparece, cada cambio se convierte en un experimento. Modificas, despliegas, y esperas a ver si alguien reporta algo.
Arreglar un error introduce otro
Esta es la señal de que la deuda ya está madura. Si corriges un problema y aparece otro en una zona que creías desconectada, el sistema tiene acoplamientos que no están en tu mapa mental.
Es también el punto donde la IA deja de ayudar y empieza a acelerar el problema, porque cada arreglo que pides se escribe sin conocer esas conexiones. Lo desarrollo en el círculo vicioso de no entender tu código.
Tienes tres formas de hacer lo mismo
Revisa cómo valida tu proyecto los datos de entrada. Si encuentras validación en el cliente en una pantalla, en el servidor en otra, y en la base de datos en una tercera, sin un criterio que explique la diferencia, eso no es defensa en profundidad. Es sedimento.
Pasa porque cada conversación con la IA empieza sin memoria de las anteriores. La herramienta resuelve el problema que le pones enfrente con el patrón que le parece mejor en ese momento, y no tiene forma de saber que hace dos semanas resolviste lo mismo de otra manera.
Lo mismo aplica al manejo de errores, al formato de las respuestas de la API y a cómo se leen las variables de entorno.
Hay dependencias que no sabes por qué están
Abre tu archivo de dependencias y recorre la lista. Por cada una, responde dos cosas: qué hace y qué pasaría si la quitas.
Las que no puedas responder son deuda doble. Son superficie de ataque que no estás vigilando y peso que no sabes si necesitas.
No puedes reconstruir el proyecto desde cero
Esta es la prueba más dura y la más reveladora. Si tuvieras que levantar el proyecto en una máquina limpia, solo con el repositorio, ¿podrías?
Si la respuesta depende de pasos que solo están en tu memoria, variables de entorno que nunca documentaste o un servicio que configuraste a mano hace meses, el repositorio no contiene tu sistema. Contiene una parte.
Dos señales que parecen deuda y no lo son
Conviene también saber qué no perseguir, porque arreglar lo que no está roto cuesta tiempo real.
No es deuda
- Código repetido en dos lugares que cambian por motivos distintos. Unificarlo suele crear un acoplamiento peor que la duplicación.
- Una solución simple y poco elegante en una zona estable que nadie toca desde hace un año.
- Falta de pruebas en código que se va a borrar en dos meses.
Sí es deuda
- Código repetido que siempre hay que cambiar en los dos lugares a la vez, y a veces se olvida uno.
- Cualquier zona que toque autenticación, permisos, pagos o datos personales y que no puedas explicar.
- Falta de pruebas en el flujo del que depende tu ingreso.
La diferencia no está en la forma del código, está en la frecuencia de cambio y en el costo de equivocarse. Duplicación en una zona congelada es gratis. Duplicación en la zona que tocas cada semana se cobra sola.
Una forma de medirla sin herramientas
No hace falta instalar nada. Toma los archivos que más cambiaron en los últimos tres meses y cruza esa lista con los archivos que puedes explicar.
# Los 15 archivos con más cambios en los últimos 3 meses
git log --since="3 months ago" --name-only --pretty=format: \
  | grep -v '^$' \
  | sort \
  | uniq -c \
  | sort -rn \
  | head -15
Los archivos que aparecen arriba en esa lista y que además no podrías explicar son tu deuda prioritaria. Ahí es donde el costo se paga todas las semanas.
Un archivo que no entiendes pero que nadie toca desde hace un año puede esperar. Uno que no entiendes y que cambia cada semana te está cobrando intereses.
Qué hacer cuando encuentras una
La reacción instintiva es pedirle a la IA que reescriba el archivo. Es exactamente lo que no conviene hacer, porque cambia código que no entiendes por código distinto que tampoco entiendes.
El orden que funciona es otro:
- Entender antes de tocar. Pide una explicación, no una reescritura. Un buen prompt para esto es explícame este archivo función por función, qué hace cada una y qué otras partes del sistema dependen de ella.
- Escribir una prueba de lo que hace hoy. Aunque el comportamiento actual te parezca raro, congélalo. Sin esa red, cualquier cambio posterior es a ciegas.
- Documentar la decisión, no el código. Una línea que diga por qué está así vale más que diez comentarios que repiten lo que ya se lee.
- Cambiar en pasos pequeños y verificables. Un cambio por vez, con la prueba corriendo entre uno y otro.
Este orden es el mismo que uso en cómo auditar código generado por IA, con más detalle sobre qué revisar en cada paso.
La deuda que solo aparece cuando llega otra persona
Mientras trabajas solo, buena parte de esta deuda queda enmascarada. Tú compensas lo que falta con memoria: recuerdas que ese servicio hay que levantarlo antes, que esa variable tiene que apuntar al entorno de pruebas, que ese módulo no acepta acentos por un motivo que ya nadie recuerda.
Esa memoria no está en el repositorio. Está en tu cabeza, y el proyecto depende de ella sin que aparezca en ningún archivo.
El momento en que se revela es cuando entra alguien más, o cuando vuelves tú después de cuatro meses, que a efectos prácticos es lo mismo. Ahí se descubre cuánto del sistema estaba sostenido por conocimiento no escrito.
Hay una prueba barata para medirlo sin esperar a que pase: escribe las instrucciones para levantar el proyecto desde cero, sin consultar nada, y después síguelas al pie de la letra en una carpeta limpia. Cada vez que tengas que improvisar un paso que no anotaste, encontraste una pieza de deuda.
El caso particular de las capas que nadie pidió
Hay una forma de deuda que la IA genera con especial facilidad: envoltorios sobre cosas que ya funcionaban bien.
Pides acceso a la base de datos y recibes una capa de repositorios sobre el cliente que ya tenías. Pides una llamada HTTP y recibes un servicio genérico con reintentos, caché y manejo de errores propio. Cada pieza es defendible por separado.
El problema aparece cuando necesitas algo que la capa no contempla. Entonces tienes que entender dos cosas en lugar de una: la herramienta original y la abstracción que alguien puso encima. Y como esa abstracción no la diseñaste tú, no sabes qué casos consideró ni cuáles dejó fuera.
La pregunta útil frente a una capa así es directa: ¿qué problema concreto de este proyecto resuelve, que la herramienta de abajo no resolvía? Si no hay una respuesta específica, la capa no es arquitectura, es peso.
Esto vale doble en las zonas sensibles. Un envoltorio propio sobre autenticación o sobre el manejo de sesiones significa que la seguridad del proyecto ya no depende de una librería revisada por mucha gente, sino de código que se escribió en una conversación y que nadie auditó.
Por qué esta deuda es más cara que la clásica
La deuda técnica tradicional tiene una propiedad que la hace manejable: quien la contrajo sabe dónde está. El desarrollador que escribió el atajo recuerda que lo escribió y por qué.
La deuda de comprensión no tiene esa propiedad. No hay nadie que recuerde la decisión, porque nadie la tomó conscientemente. La tomó un modelo, en una conversación que ya se cerró, con un criterio que nunca quedó registrado.
Eso cambia el trabajo de pagarla. Con deuda clásica, refactorizas. Con deuda de comprensión, primero tienes que hacer arqueología, y solo después puedes refactorizar.
Por eso la inversión que más rinde no es limpiar código viejo, es dejar de generar deuda nueva: leer lo que aceptas antes de aceptarlo, y anotar en el repositorio las decisiones que no se deducen leyendo archivos.