Hay un momento muy concreto en el que un proyecto empieza a escaparse de las manos. No es cuando aparece el primer error. Es la primera vez que pegas un mensaje de error en el chat y aceptas la corrección sin entender qué la causaba.
Esa vez funciona. Casi siempre funciona. Por eso el hábito se instala tan rápido.
El problema es que arreglar sin diagnosticar no deja el sistema como estaba. Lo deja con una pieza más, puesta por un motivo que nadie registró.
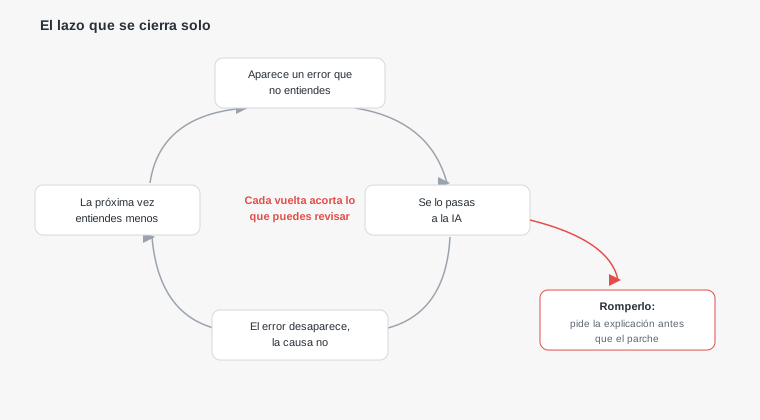
Por qué el parche suele funcionar
Conviene entender por qué este camino es tan tentador, porque no es pereza. Es que la mayoría de las veces da resultado.
Cuando le pasas un error a la IA, recibe un síntoma y responde con la corrección más probable para ese síntoma. Si el error dice que algo es nulo, va a agregar una comprobación de nulo. Si dice que un índice no existe, va a agregar un control de rango.
Esas correcciones son correctas en el sentido literal: el error desaparece. Lo que no hacen es responder por qué ese valor llegó nulo, que es una pregunta distinta y casi siempre la importante.
Hacer que el mensaje de error deje de aparecer, sin haber determinado qué condición del sistema lo produjo.
El código resultante funciona y es, al mismo tiempo, una pieza de evidencia perdida: el error era la única señal visible de un problema que sigue ahí.
Un valor nulo que no debería serlo suele significar que algo falló antes: una consulta que no encontró lo que esperaba, una respuesta de un servicio externo que llegó vacía, un dato que nunca se guardó. La comprobación de nulo hace que la pantalla no se rompa. El dato sigue sin estar.
Un recorrido completo del ciclo
Vale la pena seguir un caso hasta el final, porque el daño no se ve en ninguna vuelta individual.
Vuelta 1. Los totales de algunos pedidos aparecen en cero. Pides el arreglo y llega un recálculo del total al momento de mostrarlo. Los pedidos se ven bien.
Vuelta 2. Los reportes mensuales no cuadran con lo que ve el cliente en pantalla. Pides el arreglo y llega la misma lógica de recálculo, ahora también en el reporte. Cuadra.
Vuelta 3. Un cliente reclama que su factura dice un monto distinto al del correo de confirmación. Pides el arreglo y llega una tercera copia del recálculo, en el generador de facturas.
Vuelta 4. Cambian los impuestos. Ahora hay tres lugares que calculan totales y nadie recuerda que son tres. Se actualizan dos.
El error original nunca se tocó: algo en el proceso de guardado escribía el total en cero. Las cuatro vueltas construyeron un sistema que compensa ese fallo en tres lugares distintos, en lugar de un sistema que guarda bien el dato.
Y el estado final es peor que el inicial en una forma que importa: al principio había un error visible y una causa. Ahora hay tres copias de una lógica de compensación, una inconsistencia intermitente, y ninguna señal que apunte al origen.
El error no era el problema. Era la única pista.
Qué empeora exactamente en cada vuelta
Hay cuatro cosas que se degradan a la vez, y conviene nombrarlas por separado porque se arreglan de formas distintas.
- Aumenta el código que nadie decidió. Cada parche agrega líneas cuya justificación no está escrita en ninguna parte. Dentro de tres meses van a parecer intencionales.
- Se pierde la señal. El error era un indicador que apuntaba a una zona. Silenciarlo no apaga el problema, apaga el indicador.
- Crece el acoplamiento invisible. El parche de la vuelta 2 depende del de la vuelta 1 sin declararlo. Quitar uno rompe el otro, y no hay forma de saberlo leyendo.
- Baja tu capacidad de diagnosticar. Cada capa nueva es una capa más entre tú y la causa. El diagnóstico se vuelve más caro justo cuando se vuelve más necesario.
La cuarta es la que cierra el círculo. Por eso la siguiente vuelta llega antes y se resuelve peor que la anterior.
Cómo distinguir un diagnóstico de una corrección
La diferencia práctica se nota en una sola cosa: si puedes explicar por qué el error ocurría, hubo diagnóstico. Si solo puedes explicar qué se cambió, hubo corrección.
| Lo que recibes | Lo que no sabes todavía | Qué preguntar |
|---|---|---|
| Una comprobación de nulo | Por qué ese valor llegó nulo | ¿En qué punto del flujo debería haberse llenado este dato? |
| Un bloque que captura el error | Qué operación estaba fallando | ¿Qué excepción concreta se está capturando y cuándo se lanza? |
| Una espera antes de una llamada | Qué condición de carrera existe | ¿Qué tiene que terminar antes de que esto se ejecute? |
| Un valor convertido de tipo | Por qué llegó con el tipo equivocado | ¿Quién produce este valor y con qué tipo lo produce? |
| Un recálculo al mostrar | Por qué el dato guardado está mal | ¿Qué escribe este campo y en qué momento? |
La columna del medio es la deuda que se contrae en cada vuelta. Mientras siga vacía, el problema sigue abierto aunque la pantalla se vea bien.
Cómo se rompe el ciclo
Romperlo no requiere saber más de programación. Requiere cambiar el orden de dos pasos: diagnosticar antes de corregir, aunque la corrección ya esté disponible.
1. Pide la causa, no la solución
Es el cambio más barato y el que más rinde. En lugar de pegar el error y esperar código, pide una explicación y bloquea explícitamente la reescritura.
“Este es el error. No me des todavía la corrección. Dime cuáles son las tres causas posibles y cómo puedo verificar cuál es, desde el código.”
Pedir cómo verificar es la parte que hace la diferencia. Una lista de causas posibles sin forma de comprobarlas te deja eligiendo por intuición, que es donde empieza el problema.
2. Reproduce antes de tocar
Si no puedes provocar el error a voluntad, no vas a poder confirmar que lo arreglaste. Vas a poder confirmar que dejó de aparecer, que no es lo mismo.
Un error intermitente que desaparece después de un cambio puede estar arreglado o puede estar escondido. Sin reproducción no hay manera de distinguir los dos casos.
3. Cambia una cosa por vez
Cuando llega una corrección que toca cuatro lugares a la vez y el error desaparece, no sabes cuál de los cuatro cambios lo resolvió. Los otros tres quedan en el proyecto sin motivo conocido.
Aplicar un cambio, verificar, y solo entonces seguir, es más lento en la sesión y mucho más rápido en el mes.
4. Escribe la causa donde se vea
Cuando encuentres el origen, déjalo escrito en el commit o en un comentario corto. No lo que hiciste, sino qué lo causaba.
git commit -m "Guardar el total al confirmar el pedido

Causa: el total se calculaba en el carrito y nunca se
escribia al confirmar, quedaba en cero para los pedidos
creados desde el flujo de pago rapido.
Se elimina el recalculo al mostrar, ya no hace falta."
Ese mensaje tiene una función concreta: la próxima vez que alguien vea un total raro, no va a empezar de cero.
5. Quita los parches anteriores
Este paso casi siempre se salta y es el único que reduce el tamaño del problema. Cuando arreglas la causa real, los parches que la compensaban dejan de tener sentido y pasan a ser código que oculta futuros errores.
Si da miedo quitarlos, es buena señal de que hacía falta quitarlos. Ese miedo mide exactamente cuánto no entiendes de esa zona.
Por qué la IA no rompe el ciclo sola
Hay una expectativa razonable detrás de pedirle el arreglo: si el modelo escribió el código, debería poder diagnosticarlo. En la práctica hay tres motivos estructurales por los que eso no ocurre.
No ve tu sistema corriendo. Ve el texto que le pegaste. No sabe qué hay en la base de datos, qué devolvió el servicio externo esta mañana ni en qué orden se ejecutaron las cosas. Diagnosticar requiere observar el estado, y el estado no viaja en el mensaje de error.
Cada conversación empieza sin memoria. Los parches de las vueltas anteriores están en tu repositorio, no en su contexto. Cuando pides el arreglo de la vuelta 3, no sabe que ya existen dos compensaciones para lo mismo, así que agrega la tercera con toda naturalidad.
La pregunta que le haces pide una corrección. Pegar un error y esperar código es, literalmente, pedir que el error deje de aparecer. Responde bien a lo que se le pidió. El problema está en el pedido, no en la respuesta.
Los tres se compensan con la misma medida: darle el contexto que no puede ver y pedirle explícitamente diagnóstico en lugar de código. Lo desarrollo en cómo darle contexto arquitectónico a la IA.
Tres herramientas que acortan el diagnóstico
Buscar la causa a ojo, leyendo archivos hasta que algo encaje, es lo que hace que diagnosticar parezca caro. Estas tres reducen mucho ese costo y no requieren instalar nada nuevo.
Búsqueda binaria en el historial. Si el error no estaba hace un mes y ahora sí, el historial ya contiene la respuesta. En lugar de revisar los commits uno por uno, se parte el rango a la mitad cada vez.
git bisect start
git bisect bad                 # el estado actual falla
git bisect good HEAD~40        # hace 40 commits funcionaba
# git te deja en un punto intermedio: pruebas y marcas
git bisect good                # o: git bisect bad
git bisect reset               # al terminar
Con cuarenta commits, esto llega al culpable en unas seis pruebas en lugar de cuarenta.
Registro en los bordes. Antes de leer código, conviene confirmar qué entra y qué sale de la función sospechosa. Muchas veces el valor ya llegaba mal desde antes, y toda la lectura del cuerpo de la función era tiempo perdido.
Quitar en lugar de agregar. Si sospechas de una capa, desactívala temporalmente y observa qué cambia. Es más rápido que razonar sobre lo que hace, y responde a la vez la pregunta de si sigue haciendo falta.
Cuándo el parche es la decisión correcta
Nada de esto significa que siempre haya que diagnosticar a fondo. Hay situaciones donde el parche es lo profesional.
Si el sistema está caído y hay usuarios afectados, se estabiliza primero y se investiga después. Si el error está en una zona que vas a borrar en dos semanas, gastar horas en la causa raíz es tirar tiempo.
La diferencia entre un parche sano y uno que alimenta el círculo está en tres condiciones: que sea una decisión consciente y no una salida automática, que quede anotado como pendiente en algún lugar visible, y que no se acumule sobre parches anteriores en la misma zona.
Un parche declarado es una deuda. Tres parches sin declarar sobre la misma función son un sistema que ya nadie controla.
Si ya estás dentro del círculo
Lo más probable es que llegues a este artículo cuando el ciclo ya lleva varias vueltas. No hace falta reescribir nada.
Elige el error que más veces haya vuelto. Ese es el que tiene una causa sin resolver debajo, y es también donde más parches acumulados vas a encontrar.
Sobre esa única zona, aplica el orden completo: reproducir, pedir causas posibles con forma de verificarlas, confirmar cuál es, arreglar el origen, quitar los parches que lo compensaban y dejar escrito qué era.
Una zona recuperada por completo vale más que cinco zonas parcialmente ordenadas, porque devuelve algo que no se recupera parcialmente: la capacidad de predecir qué pasa cuando cambias algo. Las señales que indican cuánta de esa capacidad has perdido están en señales de deuda técnica invisible, y el método de revisión que evita entrar de nuevo está en cómo auditar código generado por IA.