Hay una técnica que casi nadie elige de entrada y que sigue estando en producción en medio internet: mantener una petición abierta esperando a que el servidor tenga algo que decir.
No es un mecanismo de moda ni una alternativa moderna a nada. Es el plan de respaldo que se activa cuando la conexión permanente no se puede establecer, y entender cuándo ocurre eso vale más que la técnica en sí.
Qué es exactamente
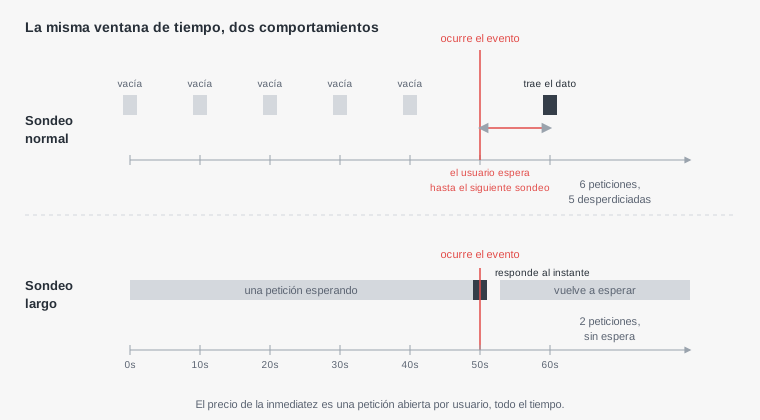
El sondeo normal funciona así: el cliente pregunta si hay novedades, el servidor responde que no, y el cliente vuelve a preguntar a los diez segundos. La mayoría de esas peticiones se desperdician.
El sondeo largo cambia una sola cosa: cuando no hay novedades, el servidor no responde. Deja la petición esperando, hasta treinta o sesenta segundos, y solo contesta cuando hay algo que enviar o cuando se agota el tiempo.
El efecto es que el dato llega prácticamente en el instante en que existe, sin que el cliente tenga que preguntar constantemente. Desde fuera se comporta como un empuje del servidor, y por dentro sigue siendo una petición normal.
Esa última parte es la que explica su supervivencia: como es tráfico corriente, atraviesa cortafuegos, proxies corporativos y redes restrictivas que bloquean o rompen las conexiones permanentes.
Por qué sigue existiendo teniendo cosas mejores
La pregunta razonable es por qué molestarse, existiendo mecanismos diseñados específicamente para esto.
La respuesta es que esos mecanismos fallan más de lo que uno espera, y no por defectos propios. Un proxy corporativo que no entiende el cambio de protocolo, una red de invitados que cierra conexiones inactivas, un antivirus que inspecciona el tráfico, una red móvil con portal cautivo. En todos esos casos el canal permanente no se establece o se cae a los pocos segundos.
Cuando eso pasa y no hay plan B, el usuario ve una aplicación que no se actualiza nunca, sin ningún mensaje de error. Es de los fallos más difíciles de diagnosticar, porque funciona perfectamente en la máquina de quien lo programó.
Por eso las librerías serias de tiempo real llevan años implementando una cascada: intentan la conexión permanente, y si no se puede, bajan a sondeo largo sin decir nada. El usuario no nota la diferencia salvo en el consumo.
El coste que tiene y dónde se nota
No es gratis, y conviene saber qué se paga antes de usarlo como opción principal.
Cada cliente mantiene una petición abierta todo el tiempo, así que el servidor tiene tantas peticiones en curso como usuarios conectados. En servidores que asignan un proceso o un hilo por petición, eso agota los recursos muy rápido: cien usuarios pueden bastar para bloquear un servidor configurado con ese modelo.
En servidores de entrada y salida no bloqueante el problema es mucho menor, porque una petición esperando consume poca cosa. Esa diferencia de modelo es lo que decide si esta técnica es viable en tu infraestructura, y se comprueba antes de escribir una línea.
Hay además un costo de reconexión: cada vez que se completa un ciclo, el cliente abre una petición nueva, con su intercambio de cifrado y sus cabeceras. Con ciclos de sesenta segundos es irrelevante; con ciclos de cinco, es mucho tráfico repetido.
Comprobar si tu servidor lo aguanta
Antes de decidir nada conviene medir cuántas peticiones simultáneas soporta la configuración actual, que casi nunca es la que uno cree.
# Cuántos procesos o hilos tiene configurados PHP-FPM
grep -E "^pm|^pm.max_children" /etc/php/8.3/fpm/pool.d/www.conf

# Peticiones en curso ahora mismo en nginx
curl -s http://127.0.0.1/nginx_status

# Conexiones establecidas contra el puerto de la aplicación
ss -tan state established '( dport = :8080 or sport = :8080 )' | wc -l
Si el número máximo de procesos es, por ejemplo, cincuenta, entonces cincuenta usuarios con una petición en espera dejan el servidor sin capacidad para atender ninguna otra cosa, incluida la carga de la propia página.
Esa comprobación es la que convierte esta decisión en técnica en lugar de en preferencia, y es la que casi nunca se hace.
Los detalles de implementación que importan
La idea es simple y los detalles son los que deciden si funciona bien o produce fallos raros.
- Un tiempo de espera menor que el de los intermediarios. Proxies y balanceadores cortan peticiones inactivas, a menudo a los sesenta segundos. Si el servidor espera más que ellos, el cliente recibe errores de conexión en lugar de respuestas vacías.
- Responder vacío al agotar el tiempo, no con error. El cliente debe distinguir entre no hay novedades y algo falló, porque la reacción es distinta.
- Un marcador de posición en cada petición. El cliente envía desde qué punto quiere novedades, y el servidor responde con lo ocurrido desde entonces. Sin eso, todo lo que pase entre el fin de una petición y el inicio de la siguiente se pierde.
- Espera creciente ante errores. Si el servidor devuelve error, reintentar de inmediato multiplica la carga sobre algo que ya está en problemas.
El tercer punto es el más importante y el que más se olvida. Entre que una petición se completa y la siguiente sale hay un hueco de milisegundos, y sin marcador de posición los eventos que caen ahí desaparecen sin dejar rastro.
Cómo se ve por dentro
Una implementación mínima en el servidor consiste en esperar en un bucle, comprobando si hay novedades y cediendo el control entre comprobaciones.
// El cliente envía desde dónde quiere novedades
$desde = (int) ($_GET['desde'] ?? 0);
$limite = time() + 45;          // menos que el tiempo de corte del proxy

while (time() < $limite) {
    $nuevos = $repo->desde($desde);

    if ($nuevos !== []) {
        header('Content-Type: application/json');
        echo json_encode(['eventos' => $nuevos, 'cursor' => end($nuevos)['id']]);
        return;
    }

    usleep(500_000);            // medio segundo entre comprobaciones
}

// Se agotó el tiempo: respuesta vacía, no un error
http_response_code(204);
Ese bucle consulta la base cada medio segundo, lo que con muchos clientes se convierte en mucha carga. En sistemas con más tráfico se sustituye por un mecanismo de notificación del propio motor, que despierta la petición solo cuando hay algo.
-- PostgreSQL permite avisar sin sondear la tabla
LISTEN eventos_nuevos;

-- Y desde donde se inserta el dato
NOTIFY eventos_nuevos, '{"id": 8841}';
Con eso, la petición espera un aviso en lugar de preguntar en bucle, y el costo por cliente en espera baja de forma considerable.
Del lado del cliente
La parte del navegador es un ciclo que vuelve a empezar tras cada respuesta, y donde importa manejar bien los tres casos posibles.
async function escuchar(cursor = 0) {
    try {
        const r = await fetch(`/api/eventos?desde=${cursor}`);

        if (r.status === 204) {          // sin novedades, se reabre
            return escuchar(cursor);
        }
        if (!r.ok) throw new Error(r.status);

        const datos = await r.json();
        datos.eventos.forEach(pintar);
        return escuchar(datos.cursor);   // continúa desde el último visto
    } catch (e) {
        // Error real: esperar antes de reintentar, con margen aleatorio
        const espera = Math.min(30000, 1000 * 2 ** intentos++) + Math.random() * 500;
        setTimeout(() => escuchar(cursor), espera);
    }
}
El detalle que evita el problema más común es que el cursor se arrastra en todas las ramas: al reabrir sin novedades, al continuar tras recibir y al reintentar tras un error. Si en alguna se pierde, se pierden eventos.
Cuándo elegirlo a propósito
Como opción principal tiene tres casos donde es la decisión correcta y no un apaño.
El primero es cuando el público está detrás de redes restrictivas: aplicaciones internas de empresas grandes, sectores con cortafuegos estrictos, entornos educativos. Ahí la conexión permanente falla para una parte de los usuarios y hay que soportar esto igualmente.
El segundo es cuando los eventos son poco frecuentes pero deben verse rápido al ocurrir. Un aviso que llega tres veces al día no justifica mantener infraestructura de conexiones permanentes.
El tercero es cuando la infraestructura actual no permite otra cosa. Alojamientos compartidos, algunas plataformas de funciones y ciertos proxies impiden mantener conexiones abiertas, y esta técnica funciona donde las demás no.
Fuera de esos casos, conviene tratarlo como lo que es: el respaldo, no la primera opción.
Qué se le escapa a una IA con esto
Pedir una implementación de sondeo largo produce, casi siempre, un bucle en el servidor y un ciclo en el cliente. Lo que suele faltar son exactamente los tres detalles que lo hacen funcionar en producción.
Falta el marcador de posición, así que se pierden eventos en el hueco entre peticiones. Falta la distinción entre respuesta vacía y error, así que el cliente reintenta agresivamente cuando el servidor va lento. Y falta el ajuste del tiempo de espera a los cortes del proxy, así que funciona en local y da errores intermitentes al desplegar.
Las frases que cambian la respuesta son pedir que el cliente envíe desde qué punto quiere novedades, que el servidor responda sin contenido al agotar el tiempo, y que ese tiempo sea menor que el corte del intermediario.
Conviene además preguntar por el modelo de concurrencia del servidor donde se va a desplegar. Sin ese dato, la implementación puede ser correcta y aun así tumbar el servicio con treinta usuarios.
Cómo encaja con lo demás
La forma sensata de usarlo no es elegirlo frente a las otras opciones, sino colocarlo debajo de ellas.
La aplicación intenta primero el mecanismo que prefiera, y si la conexión no se establece o se cae repetidamente, baja a sondeo largo de forma automática. El resto del código no se entera, porque ambas cosas entregan actualizaciones por la misma vía.
Eso exige que el transporte esté aislado tras una interfaz común, que es la misma condición que hace reversible cualquier decisión de esta familia. Con ella, soportar dos mecanismos cuesta poco más que soportar uno.
Y conviene registrar cuántos usuarios acaban en cada modo. Si una parte importante termina en el respaldo, eso es información valiosa sobre dónde están tus usuarios, y puede justificar simplificar el sistema quedándose solo con el que funciona para todos.