Un servidor que atiende cien peticiones a la vez no está haciendo cien cosas a la vez. Casi todo el tiempo está esperando: a que responda la base de datos, a que llegue la respuesta de un servicio externo, a que se escriba un archivo. El trabajo real de procesador ocupa una fracción mínima de cada petición.
Esa observación es la clave para entender por qué existen tres modelos de concurrencia distintos y por qué la discusión sobre cuál es mejor suele plantearse mal. No compiten en velocidad de cálculo: compiten en cuánto cuesta esperar.
Concurrencia no es paralelismo
Conviene separar dos ideas que se mezclan constantemente, porque de esa confusión salen muchas decisiones equivocadas.
Paralelismo es hacer varias cosas exactamente al mismo tiempo, lo que requiere varios núcleos de procesador. Sirve para trabajo de cálculo intensivo: comprimir vídeo, entrenar un modelo, procesar una imagen enorme.
Concurrencia es gestionar varias tareas que avanzan intercalándose, aunque en un instante concreto solo una esté usando el procesador. Sirve para trabajo que espera: atender peticiones web, consultar APIs, leer de una cola.
Una aplicación web típica es casi toda concurrencia y casi nada de paralelismo. Por eso un proceso de un solo hilo bien diseñado puede atender miles de conexiones, y por eso añadir núcleos a un servidor que pasa el día esperando a la base de datos no lo hace más rápido.
Qué pasa mientras se espera
Los tres modelos se distinguen por lo que hace el sistema durante esa espera, que es donde se va casi todo el tiempo.
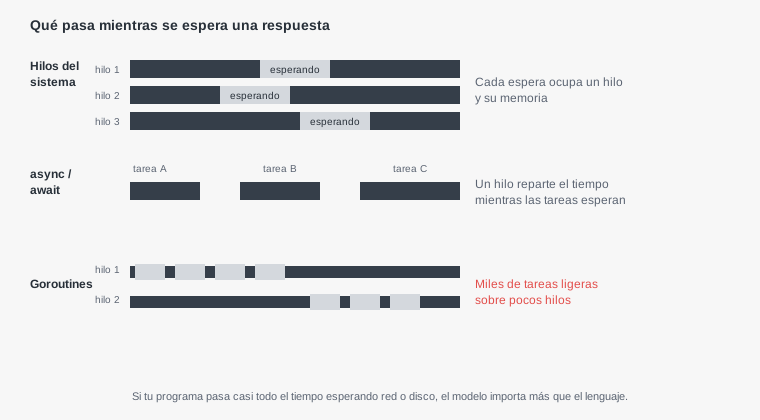
La diferencia de fondo es cuánto cuesta cada tarea en espera. Un hilo del sistema reserva memoria para su pila, del orden de megabytes. Una tarea asíncrona o una goroutine ocupan kilobytes. Con diez conexiones da igual; con diez mil, esa diferencia decide si el servidor aguanta.
Hilos del sistema: lo más simple de razonar
Es el modelo clásico: cada petición recibe un hilo, y ese hilo se bloquea mientras espera. El código se lee de arriba abajo, igual que si solo hubiera un usuario.
Su gran ventaja es precisamente esa legibilidad. No hay que marcar qué funciones esperan ni pensar en qué orden se reanudan las cosas. Un error se depura siguiendo la pila de llamadas, que refleja fielmente lo que pasó.
Su límite es el coste por hilo. Cada uno reserva memoria y el sistema operativo tiene que repartir el procesador entre todos, lo que con miles de hilos se convierte en trabajo de gestión que no hace nada útil.
La mayoría de los servidores de PHP y Java tradicionales funcionan así, y siguen siendo una opción perfectamente razonable para aplicaciones con decenas o cientos de peticiones simultáneas, que es donde está la mayoría de los proyectos.
async/await: un hilo que no se queda quieto
En este modelo, las funciones que esperan se marcan explícitamente. Cuando una llega a un punto de espera, cede el control y el mismo hilo pasa a atender otra tarea. Cuando la respuesta llega, la tarea original se reanuda.
// Las tres consultas se lanzan a la vez y el hilo no se bloquea
async function panel(usuarioId) {
    const [pedidos, facturas, avisos] = await Promise.all([
        db.pedidos(usuarioId),
        db.facturas(usuarioId),
        api.avisos(usuarioId),
    ]);
    return { pedidos, facturas, avisos };
}
La ganancia es enorme para trabajo que espera: un solo hilo atiende miles de conexiones. Es el modelo de Node, de Python con asyncio y de Rust con sus entornos asíncronos.
El precio aparece de dos formas. La primera es que una sola operación que no cede, un cálculo pesado o una función síncrona olvidada, bloquea a todas las demás, porque comparten hilo. La segunda es que el modelo se contagia: una función asíncrona obliga a que quien la llama también lo sea, y esa marca se propaga por todo el código.
El fallo que tumba un servidor asíncrono
Merece sección propia porque es el problema más común de este modelo y el más difícil de diagnosticar.
Si una petición ejecuta algo que ocupa el procesador durante dos segundos, por ejemplo interpretar un archivo enorme o calcular un resumen criptográfico costoso, durante esos dos segundos el servidor entero no atiende a nadie. No hay error, no hay caída: todas las peticiones simplemente se quedan esperando.
// Mal: bloquea el hilo para todos los usuarios
app.post('/informe', (req, res) => {
    const resultado = calcularAlgoPesado(req.body);   // 2 segundos de CPU
    res.json(resultado);
});

// Bien: el trabajo pesado va a otro hilo y el principal sigue libre
import { Worker } from 'node:worker_threads';
app.post('/informe', (req, res) => {
    const w = new Worker('./calculo.js', { workerData: req.body });
    w.once('message', r => res.json(r));
});
La forma de detectarlo es medir cuánto tarda el bucle de eventos en volver a atender, que es un dato que el propio entorno ofrece:
# Node: perfilar qué está ocupando el procesador
node --cpu-prof servidor.js
# genera un archivo .cpuprofile que se abre en las herramientas del navegador

# Carga sostenida para ver si la latencia se dispara con concurrencia
npx autocannon -c 100 -d 20 http://localhost:3000/informe
Goroutines: lo mejor de los dos, con condiciones
Go toma un camino intermedio. El código se escribe de forma bloqueante, como con hilos, pero cada tarea es una goroutine ligera que el propio entorno de Go reparte sobre unos pocos hilos del sistema.
// Parece código bloqueante, pero cada goroutine cuesta kilobytes
func panel(usuarioID int) Panel {
    var wg sync.WaitGroup
    var p Panel
    wg.Add(3)
    go func() { defer wg.Done(); p.Pedidos = db.Pedidos(usuarioID) }()
    go func() { defer wg.Done(); p.Facturas = db.Facturas(usuarioID) }()
    go func() { defer wg.Done(); p.Avisos = api.Avisos(usuarioID) }()
    wg.Wait()
    return p
}
Se obtiene la legibilidad de los hilos con el coste de las tareas asíncronas, y sin el contagio de marcar funciones. Por eso Go se usa tanto en servicios de red.
La contrapartida es que el estado compartido vuelve a ser un problema real. Dos goroutines que modifican la misma variable sin protección producen errores intermitentes que no aparecen en las pruebas. Go incluye un detector que conviene usar siempre:
# Detecta accesos concurrentes a la misma memoria sin protección
go test -race ./...
go run -race main.go
Los tres, comparados
| Hilos del sistema | async/await | Goroutines | |
|---|---|---|---|
| Coste por tarea en espera | Megabytes | Kilobytes | Kilobytes |
| Cómo se lee el código | Secuencial | Marcado con await | Secuencial |
| Una tarea lenta de CPU | Afecta solo a su hilo | Bloquea a todas | Afecta poco |
| Estado compartido | Hay que protegerlo | Casi no hay problema | Hay que protegerlo |
| Se contagia al resto del código | No | Sí | No |
| Depuración | La más sencilla | Pilas fragmentadas | Buena, con herramientas |
| Dónde encaja | Carga moderada | Mucha E/S, poco cálculo | Servicios de red |
La fila del estado compartido explica una ventaja poco comentada del modelo asíncrono de un solo hilo: como solo una tarea se ejecuta en cada momento, no hay dos modificando la misma variable a la vez. Los errores de concurrencia más difíciles simplemente no pueden ocurrir.
Cómo saber cuál es tu caso
La elección se aclara midiendo qué hace realmente tu aplicación con su tiempo, que casi nunca es lo que uno imagina.
# ¿Cuántos hilos tiene el proceso ahora mismo?
ps -o nlwp= -p $(pgrep -f servidor)

# ¿El proceso usa CPU o está esperando? (columna %CPU frente a estado S)
top -p $(pgrep -f servidor)

# Cuánto tarda de verdad cada petición bajo 50 usuarios simultáneos
ab -n 2000 -c 50 http://localhost:8080/api/pedidos
Si con carga el procesador está bajo y la latencia sube, la aplicación espera: el cuello de botella es la base de datos o un servicio externo, y cambiar de modelo de concurrencia no lo arregla. Si el procesador está al máximo, el problema es de cálculo, y ahí sí importa poder repartir trabajo entre núcleos.
Esa medición tiene una consecuencia práctica muy concreta: en la mayoría de las aplicaciones web el cuello de botella es la base de datos, y ningún modelo de concurrencia hace más rápida una consulta sin índice.
El límite que llega antes que el del modelo
Hay un techo que casi siempre aparece antes de que importe qué modelo de concurrencia usas, y que conviene conocer porque convierte en inútil cualquier mejora del lado de la aplicación: el número de conexiones a la base de datos.
Un servidor asíncrono puede aceptar diez mil peticiones simultáneas sin despeinarse. Pero si cada una necesita consultar la base, y la base admite cien conexiones, las nueve mil novecientas restantes esperan su turno. El cuello de botella se mueve, no desaparece.
Por eso toda aplicación que habla con una base usa un conjunto limitado de conexiones reutilizables, y su tamaño es uno de los ajustes que más influyen en el rendimiento real. Demasiado pequeño, y las peticiones hacen cola en la aplicación. Demasiado grande, y la base se satura atendiendo conexiones en lugar de consultas.
-- PostgreSQL: cuántas conexiones admite y cuántas se usan ahora
SHOW max_connections;
SELECT count(*), state FROM pg_stat_activity GROUP BY state;
La intuición falla aquí en una dirección concreta: un conjunto más pequeño suele rendir mejor que uno grande, porque la base trabaja más rápido con pocas consultas simultáneas que con muchas compitiendo por disco y memoria. Empezar con un número modesto y subirlo solo si las mediciones lo piden es la estrategia que menos sorpresas da.
Y hay un detalle que se olvida al escalar: si hay cuatro instancias de la aplicación y cada una abre su propio conjunto de cincuenta conexiones, la base recibe doscientas. El límite hay que calcularlo sumando todas las instancias, no mirando una sola.
Qué se le escapa a una IA con esto
Pedir un servicio que atienda muchas peticiones produce, con frecuencia, código asíncrono correcto con una operación síncrona escondida en medio: una lectura de archivo, una compresión o un cálculo que bloquea el hilo para todos. Funciona perfectamente con un usuario y se degrada con cincuenta.
En código con hilos o goroutines, el patrón que se repite es el contrario: estado compartido sin protección. Un contador, un mapa en memoria o una caché modificados desde varias tareas a la vez, que dan resultados incorrectos de forma intermitente.
Las frases que cambian la respuesta son preguntar qué operaciones de ese código bloquean el hilo, y qué variables se modifican desde más de una tarea. Con esas dos preguntas aparecen los dos fallos antes de que lleguen a producción.
Y conviene no aceptar un cambio de lenguaje o de modelo como solución a un problema de rendimiento sin haber medido antes dónde se va el tiempo. La respuesta casi siempre está en otro sitio.