De todas las decisiones de arquitectura, esta es probablemente la que más veces se toma demasiado pronto. Se habla de repartir la base de datos en proyectos que caben de sobra en una sola máquina, y se hace con un argumento que suena responsable: prepararse para crecer.
Conviene poner el listón donde está de verdad. Una base de datos en un servidor modesto maneja sin esfuerzo decenas de millones de filas y cientos de peticiones por segundo, siempre que las consultas estén bien escritas. La mayoría de los proyectos que creen necesitar esto necesitan en realidad un índice.
Dicho eso, los dos mecanismos existen, resuelven problemas reales y se confunden constantemente entre sí. Distinguirlos es lo que permite saber cuál, si alguno, hace falta.
Copiar y repartir no son lo mismo
La confusión habitual viene de que ambos implican más de un servidor, y ahí terminan los parecidos.
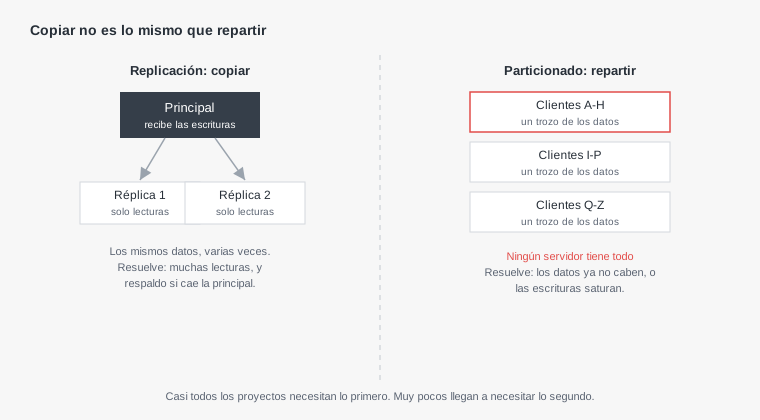
Replicar es tener los mismos datos en varios servidores. Uno recibe las escrituras y los demás mantienen copias que sirven lecturas. Cada servidor tiene todo.
Particionar es repartir datos distintos entre servidores. Cada uno guarda un trozo y ninguno tiene el conjunto completo.
De esa diferencia sale todo lo demás. Replicar es relativamente sencillo, lo traen incorporado todos los motores y se puede deshacer apagando una réplica. Particionar cambia cómo se escriben las consultas, cómo se relacionan los datos y cómo se opera el sistema, y es muy difícil de revertir.
Qué problema resuelve cada uno
La pregunta correcta no es cuál es mejor, sino cuál de los dos problemas tienes, porque son distintos y raramente aparecen a la vez.
La replicación resuelve dos cosas: un exceso de lecturas, repartiéndolas entre copias, y la disponibilidad, porque si el principal cae hay otro servidor con los datos listo para ocupar su lugar. Ese segundo motivo es el que justifica la mayoría de las réplicas que existen.
El particionado resuelve otras dos: que los datos ya no quepan en una máquina, y que el volumen de escrituras sature al único servidor que puede aceptarlas. Es importante notar que la replicación no ayuda con las escrituras, porque todas siguen pasando por el principal.
Puesto así, el orden natural queda claro. Si el problema son las lecturas o la disponibilidad, una réplica lo resuelve. Solo cuando el problema son las escrituras o el tamaño entra en juego el particionado, y ese caso es mucho menos común de lo que parece.
El retraso de réplica, que no es un fallo
Al añadir una réplica aparece un comportamiento que sorprende y que conviene entender antes de montarla, porque genera incidentes difíciles de explicar.
La copia no es instantánea. Los datos viajan del principal a la réplica con un retraso que suele ser de milisegundos y que puede crecer si hay mucha carga. Durante esa ventana, los dos servidores no dicen lo mismo.
El síntoma clásico es un usuario que guarda algo, la aplicación lo redirige a la pantalla siguiente y ahí no aparece lo que acaba de crear. No hay ningún error: la escritura fue al principal, la lectura fue a una réplica que todavía no la tenía.
La solución habitual es enviar al principal las lecturas que ocurren justo después de una escritura del mismo usuario, y dejar en las réplicas todo lo demás. Los listados, las búsquedas y los informes toleran perfectamente unos milisegundos de retraso.
Conviene también vigilar ese retraso. Cuando una réplica se queda muy atrás, deja de ser útil y se convierte en una fuente de datos incorrectos, y eso no produce ninguna alerta por sí solo.
Lo que hay que resolver antes de particionar
Si después de todo lo anterior el particionado sigue pareciendo necesario, hay una decisión previa que condiciona todo el diseño: por qué criterio se reparten los datos.
Esa clave determina en qué servidor vive cada registro, y elegirla mal es el error caro de este terreno, porque cambiarla después implica mover todos los datos.
- Debe repartir de forma pareja. Si un criterio deja el ochenta por ciento de los datos en una partición, no se ha resuelto nada y se ha añadido complejidad.
- Debe estar en casi todas las consultas. Si la mayoría de las búsquedas no incluyen la clave, hay que preguntar a todos los servidores y juntar resultados, que es más lento que no haber particionado.
- Debe agrupar lo que se consulta junto. Si los datos de un mismo cliente acaban repartidos, cada operación suya toca varios servidores.
En aplicaciones donde cada cliente es independiente, el propio identificador de cliente suele cumplir las tres condiciones y es la elección natural. Cuando no existe una clave así, la pregunta que conviene hacerse es si el particionado es realmente la respuesta.
Lo que se pierde al repartir
Particionar tiene un costo que no se nota en el diagrama y aparece entero el día que se implementa.
Las relaciones entre datos que viven en servidores distintos dejan de poder resolverse con una consulta: hay que pedir a cada uno y combinar en el código. Las garantías de coherencia entre particiones desaparecen, porque una transacción no abarca varios servidores. Y operaciones simples como contar el total o listar ordenando por fecha requieren consultar todo y unir resultados.
A eso se suma el trabajo de operación: cada partición necesita sus copias, su monitoreo y sus actualizaciones, y hay que probar restauraciones de cada una.
Por eso conviene agotar antes las alternativas, que casi siempre alcanzan: revisar índices, mover los informes pesados a una réplica, archivar datos históricos que ya nadie consulta, o simplemente subir de tamaño el servidor, que sigue siendo la solución más barata en horas de trabajo.
Qué pasa cuando cae el servidor principal
Una de las razones para tener réplicas es poder sobrevivir a la caída del principal, y ahí aparece la parte que casi nunca se monta: el relevo no es automático por defecto.
Tener una copia de los datos no significa que el sistema vaya a usarla. Alguien o algo tiene que detectar que el principal no responde, decidir que está caído de verdad y no solo lento, promover una réplica a principal y redirigir la aplicación hacia ella.
Ese proceso tiene una trampa conocida: si se hace automático sin cuidado, una interrupción de red puede llevar a que dos servidores se crean principales al mismo tiempo y acepten escrituras por separado. Reconciliar eso después es de los problemas más desagradables que existen con datos.
Por eso en servicios gestionados conviene usar el relevo que ofrece el proveedor, que ya resolvió esa parte, y en instalaciones propias conviene empezar por un relevo manual documentado. Un procedimiento escrito que alguien ejecuta en diez minutos es mejor que una automatización que nadie probó.
Y como todo lo que solo se usa en emergencias, hay que ensayarlo. Promover una réplica en un entorno de prueba, una vez, revela los pasos que faltaban en la documentación mucho antes de necesitarlos.
Los datos que no tienen por qué estar en la base principal
Antes de plantearse repartir, conviene mirar qué está ocupando espacio, porque muchas bases grandes lo son por cosas que nunca debieron guardarse ahí.
- Archivos e imágenes. Guardar binarios en la base hace que las copias tarden horas y que el espacio crezca rápido. Su sitio es un almacenamiento de objetos, con la base guardando solo la referencia.
- Registros de eventos y auditoría. Crecen sin parar y casi nunca se consultan. Conviene moverlos a un almacén aparte con su propia política de retención.
- Datos históricos que ya nadie mira. Los pedidos de hace cinco años no necesitan estar en la misma tabla que los de esta semana. Archivarlos reduce el tamaño y acelera las consultas habituales.
- Tablas temporales que quedaron. Copias creadas para una migración o una prueba que nadie borró.
Revisar estos cuatro puntos es una tarde de trabajo y con frecuencia reduce la base lo suficiente como para que la conversación sobre particionar deje de tener sentido durante varios años.
El orden sensato para crecer
Ordenado de menor a mayor esfuerzo, este es el camino que evita resolver problemas que todavía no existen.
Primero, medir y arreglar lo que está mal: índices que faltan, consultas dentro de bucles, datos que se piden de más. Aquí se resuelve la gran mayoría de los problemas de rendimiento reales.
Segundo, una máquina más grande. No es elegante y suele ser la mejor relación entre lo que cuesta y lo que resuelve.
Tercero, una réplica para lecturas, si el problema son las lecturas, y por disponibilidad si el sistema ya no puede permitirse estar caído.
Cuarto, separar lo que no pertenece a la base principal: archivos, registros de eventos, datos históricos. Muchas bases grandes lo son por cosas que no deberían estar ahí.
Y solo entonces, particionar. Llegar hasta este punto es señal de un proyecto con un volumen considerable, y para entonces la decisión se toma con datos reales en lugar de con suposiciones.
Qué preguntar cuando lo propone una IA
Pedir una arquitectura de datos que escale produce con frecuencia una propuesta con particionado incluido, porque es lo que aparece en la literatura sobre sistemas grandes.
La pregunta que reordena la conversación es cuántos datos y cuántas operaciones por segundo se manejan hoy, y a partir de qué cifra concreta haría falta cada pieza. Una respuesta honesta a eso suele revelar que faltan dos órdenes de magnitud para necesitar la mitad de lo propuesto.
La segunda pregunta útil es qué habría que cambiar en el código para revertir cada parte de la propuesta. La replicación se quita apagando una réplica; el particionado, no. Saber cuál es reversible cambia el orden en que conviene adoptarlas.
Y si la propuesta incluye réplicas, conviene preguntar explícitamente qué consultas irían al principal y cuáles a las copias. Si esa distinción no está hecha, el sistema va a mostrar datos viejos justo después de guardarlos, y ese fallo es de los que cuesta reproducir.