La promesa es atractiva y se repite mucho: ejecutar tu código en decenas de ubicaciones repartidas por el mundo, de modo que cada visitante reciba respuesta desde un punto cercano. Suena a mejora gratuita.
La parte que se cuenta menos es que acercar el código no acerca los datos. Y como casi cualquier página útil necesita consultar algo, el viaje que se quería evitar se acaba haciendo igual, solo que ahora desde un sitio distinto.
Dónde se ejecuta el código
Conviene ver la diferencia estructural antes de hablar de proveedores, porque es lo que decide si la ganancia existe en tu caso.
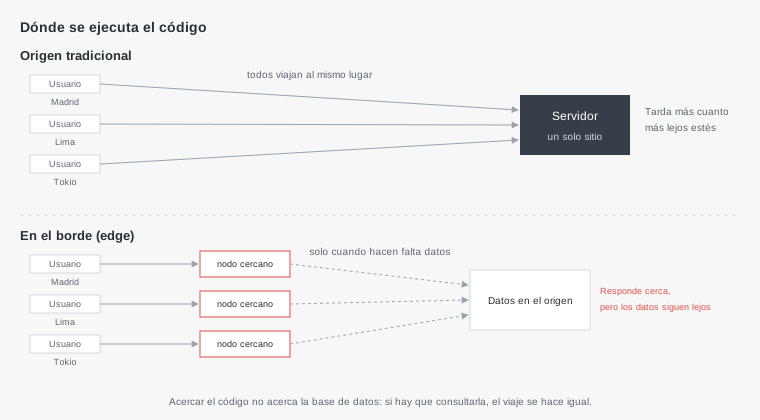
La ganancia real aparece cuando la respuesta se puede construir sin preguntar a nadie: una página que no cambia, una redirección, una comprobación de permisos con un token firmado, una prueba A/B.
Cuando hace falta un dato que vive en una sola base, el nodo cercano al usuario está lejos de esa base, y la petición recorre la misma distancia que antes. En el peor caso recorre más, si hace varias consultas seguidas.
Qué encaja bien en el borde
La lista de casos donde esto rinde es concreta y más corta de lo que sugiere el entusiasmo.
- Servir contenido que no cambia, que es lo que una red de distribución ya hacía sin necesidad de ejecutar código.
- Decisiones de enrutado: mandar a cada visitante a una versión según su país, su idioma o un experimento.
- Comprobaciones con información autocontenida: validar la firma de un token y rechazar sin molestar al origen.
- Transformar respuestas: redimensionar una imagen, reescribir cabeceras, componer una página con trozos ya cacheados.
- Filtrar tráfico abusivo antes de que llegue a tu infraestructura, que además ahorra el coste de recibirlo.
El patrón común es que ninguno de estos necesita consultar una base de datos. En el momento en que se necesita, la ventaja se diluye.
Las restricciones que conviene conocer antes
Estos entornos no ejecutan un servidor normal. Funcionan con un modelo más limitado, y esas limitaciones deciden si tu código puede vivir ahí.
El tiempo de ejecución por petición está acotado, normalmente en pocos milisegundos de procesador. Un proceso largo no encaja.
No hay sistema de archivos ni estado entre peticiones: todo lo que se necesite recordar tiene que ir a un almacén externo, con el viaje que eso implica.
Y la parte que más sorprende al migrar: no siempre están disponibles las librerías habituales, porque el entorno no es el mismo que en un servidor convencional. Una dependencia que usa funciones del sistema operativo o conexiones que no sean web puede no funcionar, y eso incluye a varios clientes de base de datos.
Por eso la comprobación previa no es si el proveedor te convence, sino si tus dependencias pueden ejecutarse ahí. Es una revisión de media hora que evita descubrirlo a mitad de la migración.
El problema de los datos, que es el que decide
Si el código en el borde necesita datos, hay tres salidas y conviene conocerlas porque cada una tiene un precio distinto.
La primera es consultar al origen, aceptando el viaje. Sigue habiendo ganancia si el nodo hace una sola consulta y el resto del trabajo lo resuelve él, pero desaparece si hace varias en cadena.
La segunda es replicar los datos cerca de cada nodo, que es lo que ofrecen los almacenes distribuidos de estos proveedores. Funciona bien para datos que se leen mucho y se escriben poco, como configuraciones o catálogos, y trae consigo el problema de siempre: la réplica no es instantánea, así que un dato recién escrito puede no verse todavía.
La tercera es no necesitar datos, que es la que de verdad funciona: llevar al borde solo la parte que puede decidir por sí sola y dejar el resto en el origen.
Esa tercera opción es la que usan en la práctica la mayoría de las implementaciones sensatas, y explica por qué esto se parece más a una capa delante de tu aplicación que a un sustituto de ella.
Medir antes de mover nada
La decisión se toma mucho mejor sabiendo cuánto de tu tiempo de respuesta es distancia y cuánto es trabajo propio.
# Desglose del tiempo: conexión, cifrado y espera del servidor
curl -s -o /dev/null -w \
 'dns: %{time_namelookup}s  conexin: %{time_connect}s  tls: %{time_appconnect}s
espera del servidor: %{time_starttransfer}s  total: %{time_total}s\n' \
 https://midominio.com/api/pedidos
La lectura es directa: lo que va desde el inicio hasta el cifrado es distancia, y lo que va del cifrado a la primera respuesta es trabajo de tu servidor. Si el grueso está en la segunda parte, mover el código al borde no lo arregla, porque ese tiempo viaja con la aplicación.
Conviene medir desde varios sitios, no solo desde el tuyo. Un servicio de comprobación desde distintas regiones, o simplemente pedirle a alguien en otro continente que ejecute ese comando, da el dato que falta.
Y si resulta que la distancia sí domina, hay una escala de soluciones antes de mover código: servir imágenes y archivos desde una red de distribución, cachear las páginas que no cambian, y solo después plantearse ejecutar lógica cerca del usuario.
Las tres opciones, comparadas
| Origen tradicional | Funciones en el borde | Solo CDN delante | |
|---|---|---|---|
| Dónde corre el código | Un servidor | Muchos nodos | No corre código propio |
| Acceso a base de datos | Directo y cercano | Lejano o replicado | No aplica |
| Tiempo de ejecución | Sin límite práctico | Muy acotado | No aplica |
| Librerías disponibles | Todas | Subconjunto | No aplica |
| Coste con poco tráfico | El del servidor | Casi cero | Bajo |
| Facilidad para depurar | Alta | Media | Alta |
| Costo de salir | Días | Semanas o meses | Días |
| Dónde encaja | La aplicación entera | Decisiones sin datos | Contenido estable |
La tercera columna merece atención porque es la que más veces resuelve el problema real. Una red de distribución bien configurada delante de un servidor normal cubre la mayor parte de la mejora de velocidad, sin cambiar nada de la arquitectura ni atarse a un proveedor.
La fila del costo de salir también pesa: el código escrito para estos entornos usa interfaces propias de cada proveedor para almacenamiento, caché y configuración, y eso no se mueve sin reescribir.
El arranque en frío, que aquí se comporta distinto
Una de las razones por las que estos entornos resultan atractivos es que no sufren el retraso de arranque que sí tienen las funciones tradicionales sin servidor, y conviene entender por qué, porque explica también sus límites.
Las funciones convencionales levantan un contenedor con su sistema operativo y su entorno de ejecución, lo que lleva cientos de milisegundos la primera vez. Los entornos del borde usan un modelo más ligero, donde el código de muchos clientes convive en el mismo proceso, aislado por el propio motor de ejecución en lugar de por una máquina virtual.
Esa es la razón de que arranquen en muy poco tiempo, y también la de las restricciones de antes: no hay sistema de archivos ni acceso al sistema operativo porque, sencillamente, no hay un sistema operativo propio para ese código.
La consecuencia práctica es que el argumento del arranque en frío, que sí es decisivo al elegir entre un servidor y funciones tradicionales, aquí deja de ser el factor que decide. Lo que decide sigue siendo la distancia a los datos.
Cuánto cuesta esto en la factura
El modelo de cobro habitual se parece al de las funciones: se paga por invocación y por tiempo de procesador, no por tener algo encendido.
Con tráfico bajo eso significa casi cero, lo que hace muy barato empezar. Con tráfico alto, la cuenta se invierte respecto a un servidor de precio fijo, igual que vimos al comparar modelos de alojamiento.
Hay dos cargos que suelen quedar fuera de la estimación inicial. El primero es el almacén distribuido que se usa para guardar estado, que se cobra por lectura y por escritura, y en una aplicación con muchas consultas suma más que el propio cómputo. El segundo es la transferencia de salida, que sigue existiendo aunque el código esté repartido.
La medida preventiva es la misma de siempre: configurar un aviso de gasto antes de desplegar, y comprobar la primera factura línea por línea en lugar de mirar solo el total.
Depurar cuando el código corre en otra parte
Un aspecto práctico que se descubre tarde: el diagnóstico cambia bastante cuando la ejecución ocurre en un nodo que no controlas.
No hay una máquina a la que conectarse ni un archivo de registro que leer. Todo lo que se quiera saber tiene que enviarse fuera en el momento, y los registros del proveedor suelen tener un retraso y un plazo de retención corto.
Eso hace que valga la pena registrar desde el principio qué nodo atendió cada petición y cuánto tardó cada parte. Cuando algo va mal en una región concreta, esa información es lo único que permite verlo.
Y conviene tener un camino de vuelta probado: poder desviar el tráfico al origen si el borde falla. Es una configuración que se prepara en calma y se agradece el día que un despliegue en el borde sale mal.
Cómo decidir sin quedarte atrapado
Para un proyecto pequeño, la recomendación es clara y va en escalones.
Primero, una red de distribución delante del servidor, que es barato, reversible y cubre buena parte de la ganancia. Segundo, si tras medir la distancia sigue dominando, mover al borde solo las decisiones que no necesitan datos: redirecciones, comprobación de tokens, filtrado de abuso.
Y dejar en el origen todo lo que consulte la base, salvo que exista una razón medida para replicar. La arquitectura que funciona en la práctica es un borde delgado delante de una aplicación normal, no una aplicación repartida.
La precaución que mantiene esto reversible es la de siempre: que la lógica de negocio no viva en el código del borde. Si ahí solo hay decisiones de enrutado y validaciones autocontenidas, cambiar de proveedor o volver atrás es un trabajo de días.
Qué se le escapa a una IA con esto
Pedir que se mueva una aplicación al borde produce, con frecuencia, una propuesta que asume que todo el código puede ejecutarse ahí, incluido el acceso a la base de datos, sin mencionar la distancia a los datos ni las limitaciones del entorno.
El resultado funciona en las pruebas, porque en desarrollo todo está cerca, y en producción resulta más lento que antes para los usuarios que estaban cerca del origen.
Las frases que cambian la respuesta son preguntar qué partes pueden decidir sin consultar datos, y pedir que diga explícitamente cuántas consultas a la base hace cada ruta que se propone mover.
Y conviene preguntar por las dependencias antes de nada: cuáles de las librerías actuales no funcionan en ese entorno. Esa lista, que el modelo puede dar si se le pide, decide si la migración es viable mucho antes que cualquier consideración de rendimiento.