Un proyecto de tamaño medio en JavaScript arrastra sin esfuerzo novecientas dependencias. Casi nadie ha mirado bajo qué licencia está cada una, y la mayoría de las veces no pasa nada, porque la mayoría son permisivas.
El problema aparece con las pocas que no lo son, en el momento menos oportuno: cuando un cliente pide el inventario de componentes, cuando llega una auditoría antes de una compra, o cuando alguien se da cuenta de que la librería que resuelve el problema difícil obliga a publicar el código que la usa.
Nada de lo que sigue es asesoramiento legal. Es el mapa mínimo para saber cuándo puedes seguir y cuándo tienes que preguntar a alguien que sí lo es.
Lo que una licencia es en realidad
La confusión de partida es pensar que el código publicado en abierto es de libre uso. No lo es: es código con derechos de autor, igual que cualquier otro, sobre el que su titular concede un permiso condicionado.
Esa es la estructura de toda licencia libre: se te permite usar, copiar y modificar, a cambio de cumplir unas condiciones. Si no las cumples, el permiso decae y lo que queda es una infracción de derechos de autor.
Las condiciones varían poco en la práctica y se reducen a tres tipos. Conservar los avisos de autoría, publicar los cambios que hagas al propio componente, y publicar también tu código si lo combinas con él.
Las tres primeras familias de licencia se distinguen exactamente por cuáles de esas tres condiciones imponen.
Las tres familias y qué exige cada una
Con esto basta para clasificar el noventa y cinco por ciento de lo que te vas a encontrar.
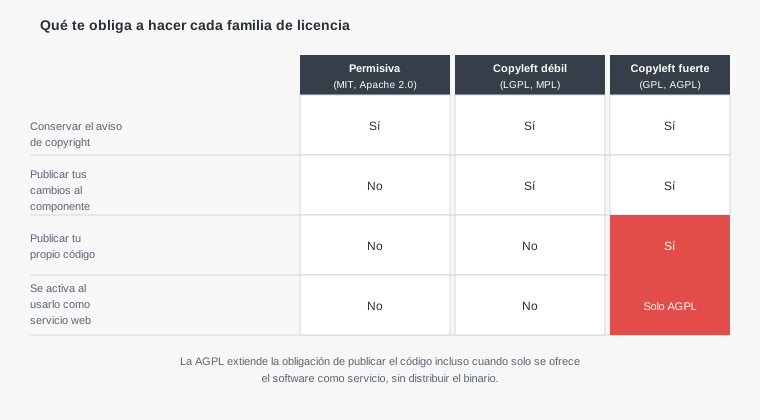
Las permisivas, con MIT, BSD y Apache 2.0 a la cabeza, piden lo mínimo: conserva el aviso de copyright y el texto de la licencia. Puedes usarlas en software cerrado sin publicar nada tuyo. Apache 2.0 añade una concesión expresa de patentes y la obligación de indicar los archivos que modificaste.
El copyleft débil, con LGPL y MPL 2.0, añade una condición: si modificas el propio componente, esos cambios se publican bajo la misma licencia. Tu código, el que solo lo usa, sigue siendo tuyo y puede ser cerrado. La frontera en MPL es especialmente clara porque es por archivo.
El copyleft fuerte, con GPL a la cabeza, es el que cambia las reglas: si distribuyes un programa que incorpora código GPL, el conjunto se distribuye bajo GPL, con el código fuente disponible. Es la condición que hace que una sola dependencia pueda determinar la licencia de todo tu producto.
La AGPL y el matiz que pilla a casi todo el mundo
De todas las trampas de este terreno, esta es la que más veces se descubre tarde, y merece su propio apartado.
El copyleft clásico se activa con la distribución: cuando entregas el programa a alguien. Durante años eso dejó fuera al software que se ejecuta en un servidor, porque un usuario que abre tu web no recibe ninguna copia del programa.
La AGPL cierra ese hueco. Si los usuarios interactúan con el programa a través de una red, tienes que ofrecerles el código fuente de la versión que estás ejecutando, con tus modificaciones incluidas.
Traducido a la práctica: una base de datos o una librería con licencia AGPL incorporada a tu servicio web puede obligarte a publicar el código de ese servicio. No siempre, porque depende de cómo esté integrada, pero lo bastante a menudo como para que muchas empresas la prohíban directamente en sus políticas internas.
La regla práctica que se sigue en la mayoría de los equipos es sencilla: una dependencia AGPL no entra sin una revisión explícita de qué implica en tu caso concreto.
Enlazar, copiar y llamar por red no son lo mismo
El detalle que decide si el copyleft te alcanza es la forma en que tu código toca el suyo, y aquí hay tres situaciones bien distintas.
Copiar el código en tu proyecto, aunque sean treinta líneas de una respuesta en un foro, te somete a su licencia. Es el caso más claro y el que más veces se hace sin pensar.
Enlazar con una librería es el terreno donde más se discute. La postura de la Free Software Foundation es que enlazar crea una obra derivada, y por eso existe la LGPL, que permite el enlace desde software cerrado a cambio de que el usuario pueda sustituir la librería.
Llamar a un proceso separado por red o mediante la línea de comandos generalmente no crea obra derivada. Es la razón por la que puedes usar una base de datos GPL desde una aplicación cerrada: hablas con ella por su protocolo, no la incorporas.
Ese último punto tiene una excepción importante, que es justamente la AGPL cuando el programa que hay al otro lado del protocolo es el que tú ejecutas y modificaste.
Cómo saber qué tienes ahora mismo
Antes de cualquier discusión conviene tener el inventario, y eso son dos comandos.
# Resumen por licencia en un proyecto de Node
npx license-checker --summary

# Detalle, para localizar quien introduce una licencia concreta
npx license-checker --onlyunknown
npm ls <paquete>            # quien depende de el y por que esta ahi
# En PHP con Composer
composer licenses
# En Python
pip install pip-licenses && pip-licenses --format=markdown --order=licenseLa primera vez que se ejecuta esto en un proyecto con años encima suelen aparecer dos o tres sorpresas. Lo habitual no es una dependencia directa sino una transitiva, que entró como dependencia de una dependencia.
Conviene también generar el inventario en un formato estándar y guardarlo en el repositorio, porque es exactamente lo que va a pedir un cliente grande o una auditoría.
# Inventario de componentes en formato estandar (SBOM)
npx @cyclonedx/cyclonedx-npm --output-file sbom.json
composer require --dev cyclonedx/cyclonedx-php-composer
El código sin licencia no es código libre
Hay un caso que se malinterpreta de forma sistemática: el repositorio público sin archivo de licencia.
La ausencia de licencia no significa permiso amplio, significa lo contrario. Sin una concesión expresa, se aplican los derechos de autor por omisión, que reservan al titular el derecho de copia. Publicarlo en un sitio público no renuncia a nada.
Lo mismo vale para el código que aparece en respuestas de foros y en documentación: está bajo la licencia del sitio o de quien lo escribió, aunque parezca de dominio público por estar a la vista.
La salida cuando necesitas algo así es pedirlo por escrito. Un mensaje del autor autorizando el uso, guardado, vale más que la suposición de que no le importará.
La licencia que tú pones
El otro lado del asunto, cuando publicas algo, se decide con dos preguntas.
La primera es qué quieres que pueda hacer quien lo use. Si el objetivo es máxima adopción, incluso dentro de productos comerciales cerrados, la respuesta es una permisiva. Si el objetivo es que las mejoras vuelvan a la comunidad, es una copyleft.
La segunda es si te preocupan las patentes. Apache 2.0 incluye una concesión expresa y una cláusula que retira los derechos a quien te demande por patentes; MIT no dice nada al respecto. Para un proyecto que aspira a uso corporativo, esa diferencia pesa.
# Poner la licencia donde las herramientas la encuentran
curl -sL https://www.apache.org/licenses/LICENSE-2.0.txt -o LICENSE
# y declararla tambien en los metadatos del paquete
# package.json: "license": "Apache-2.0"
# composer.json: "license": "Apache-2.0"
Esos identificadores no son texto libre: son códigos de una lista estándar, y usarlos correctamente es lo que permite que las herramientas de inventario funcionen.
El caso del código propuesto por un asistente
Hay una situación nueva que conviene tratar aparte, porque la pregunta se plantea mal casi siempre.
Un asistente puede reproducir fragmentos que ha visto durante su entrenamiento, y cuanto más conocido y específico es el fragmento, más probable es que salga tal cual. Una implementación estándar de un algoritmo con nombre propio es un buen candidato.
El riesgo práctico no es que el asistente infrinja nada: es que tú incorpores un fragmento con licencia copyleft sin saberlo y sin el aviso de autoría. La obligación recae sobre tu proyecto.
La comprobación es la misma que se haría con código copiado de cualquier otro sitio, y funciona razonablemente bien con buscar un fragmento distintivo.
# Buscar si un fragmento distintivo ya existe en algun repositorio
gh search code "una linea muy caracteristica del fragmento" --limit 10

# Detectar bloques largos duplicados dentro de tu propio proyecto
npx jscpd src/ --min-lines 20
Para la mayoría del código generado, que es repetitivo o específico de tu dominio, la preocupación es teórica. Conviene reservar la comprobación para lo que tenga aspecto de implementación conocida de algo con nombre propio.
Cuándo esto se convierte en un problema real
Merece la pena saber en qué momentos se revisa todo esto, porque son pocos y predecibles.
El más frecuente es la venta a una empresa grande. En el proceso de compra piden el inventario de componentes y sus licencias, y una AGPL sin resolver puede detener la operación.
El segundo es una ronda de inversión o una adquisición, donde la revisión es más estricta todavía porque afecta a lo que se está comprando.
El tercero es distribuir software que el cliente instala en sus máquinas, que es el escenario clásico que activa el copyleft.
Si tu proyecto es interno y no lo distribuyes ni lo vendes, el riesgo real es bajo. Eso no es motivo para no tener el inventario, porque el día que la situación cambia es tarde para haberlo hecho.
Qué se le escapa a una IA con esto
Preguntar por licencias produce respuestas que suenan seguras y tienen dos problemas de fondo.
El primero es que responde en general cuando la respuesta depende de detalles: si distribuyes o solo ejecutas en servidor, si enlazas o llamas por red, si modificaste el componente, en qué jurisdicción estás. Cambia cualquiera de esos y la conclusión se invierte.
El segundo es que afirma cosas sobre licencias concretas de proyectos concretos que pueden haber cambiado. Varios proyectos conocidos han cambiado de licencia en los últimos años, y la información del entrenamiento puede ser anterior al cambio. La licencia válida es la del archivo en la versión que estás usando, no la que se recuerda.
Tampoco distingue entre lo que es una obligación legal y lo que es una costumbre extendida. Presenta ambas con el mismo tono, y eso lleva tanto a preocuparse por cosas irrelevantes como a saltarse obligaciones reales.
Donde sí es útil es en lo mecánico: explicarte qué dice una cláusula concreta que tienes delante, ayudarte a leer el inventario, o enumerar qué preguntas tendrías que llevar a un abogado. Para la decisión sobre si puedes usar una dependencia copyleft en tu producto, la fuente es el texto de la licencia y, si hay dinero en juego, alguien cualificado.