Cuando alguien pregunta por dónde empezar con la seguridad de una aplicación web, la respuesta que aparece siempre es el OWASP Top 10. Y quien va a leerlo se encuentra con un documento organizado por categorías de riesgo, con nombres abstractos y referencias cruzadas, escrito para gente que ya conoce el terreno.
La lista es buena y el problema es de presentación. No es un temario para estudiar de principio a fin: es un mapa de dónde suelen romperse las cosas, y sirve cuando se traduce a preguntas concretas sobre el sistema propio.
Qué es y qué no es esta lista
Conviene aclarar el malentendido de partida, porque cambia cómo se usa.
No es una lista de los diez ataques más peligrosos ni un estándar de cumplimiento. Es una recopilación de las categorías de fallo que aparecen con más frecuencia en aplicaciones reales, elaborada a partir de datos de muchas organizaciones y revisada cada pocos años.
Que algo ocupe el primer puesto no significa que sea lo más grave, sino lo más común. Y esa es justamente la razón de su utilidad para un proyecto pequeño: describe lo que probablemente te va a pasar, no lo que le pasa a un banco.
Tampoco es una lista de cosas que se resuelven una vez. Varias categorías son propiedades del diseño, no defectos puntuales, y se mantienen o se pierden con cada funcionalidad nueva.
Dónde ocurre cada riesgo
La forma que a mí me resulta más útil de ordenarlas no es por su número, sino por la capa del sistema donde se producen.
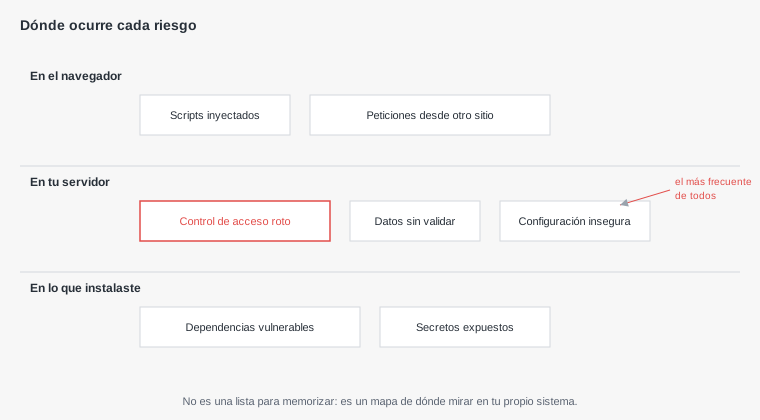
Esa distribución explica algo importante sobre dónde conviene poner el esfuerzo. La mayoría de los fallos ocurren en el servidor, que es la parte que uno controla por completo, y no en ataques sofisticados contra el navegador del visitante.
El primero de la lista, y por qué lidera
El control de acceso roto ocupa el primer puesto, y merece más atención que el resto junto porque es el que más veces aparece y el que menos ruido hace.
Consiste en que alguien acceda a algo que no le corresponde. No requiere ninguna técnica: basta con cambiar un número en la dirección, llamar a un endpoint que la interfaz no muestra o repetir una petición propia sustituyendo un identificador.
La razón de que sea tan común es que no produce ningún síntoma. La aplicación funciona perfectamente mientras cada usuario pida lo suyo, y todas las pruebas pasan, porque las pruebas también piden lo suyo.
La comprobación que lo detecta lleva dos minutos y debería ser obligatoria antes de publicar cualquier pantalla con datos de alguien: crear dos cuentas, iniciar sesión con la primera y pedir un recurso de la segunda. Si responde con datos, el fallo está ahí.
Las categorías que son de diseño, no de código
Un grupo de la lista no se corrige con una línea concreta, porque describe decisiones estructurales.
- Fallos criptográficos. No es que el cifrado esté mal implementado: casi siempre es que datos que debían viajar o guardarse cifrados no lo estaban, o que las contraseñas se guardaron con un método inadecuado.
- Diseño inseguro. Fallos que vienen de no haber pensado el caso: un proceso de recuperación de contraseña que permite enumerar usuarios, un flujo de compra que se puede completar sin pagar.
- Configuración insegura. Paneles accesibles, credenciales por defecto, mensajes de error detallados en producción, permisos abiertos en un almacenamiento. Es la categoría que más crece con el tiempo sin que nadie toque nada.
- Fallos de registro y vigilancia. No causan la brecha, determinan cuánto tarda en detectarse y si se puede reconstruir después.
Estas cuatro tienen algo en común: no aparecen en ningún análisis automático del código, porque no hay nada sintácticamente incorrecto. Solo se detectan preguntándose qué debería ocurrir y comprobando si ocurre.
Las que sí se detectan con herramientas
El resto de la lista tiene mejor cobertura automática, y ahí conviene apoyarse en herramientas en lugar de en la atención humana.
Las inyecciones, que incluyen tanto las de base de datos como los scripts insertados en páginas, se detectan bastante bien con análisis estático y se previenen de raíz con consultas parametrizadas y escapado automático en las plantillas.
Las dependencias vulnerables se detectan con el análisis que ofrecen las propias plataformas de alojamiento de código, que avisa cuando un paquete tiene un problema conocido.
La falsificación de peticiones del lado del servidor, que consiste en conseguir que tu servidor haga peticiones a direcciones elegidas por el atacante, es más sutil y aparece en cualquier funcionalidad que reciba una dirección del usuario y la consulte, como una previsualización de enlaces o una importación desde una URL.
Comprobar el control de acceso con dos cuentas. Activar el análisis de dependencias. Revisar que no haya paneles ni almacenamientos abiertos. Confirmar que las contraseñas se guardan con una función adecuada.
Esas cuatro cosas cubren, en proyectos pequeños, una parte desproporcionada del riesgo real.
Traducirla a preguntas sobre tu sistema
La lista se vuelve útil cuando deja de ser genérica. Estas son las preguntas que la aterrizan, y conviene responderlas con el código delante en lugar de de memoria.
¿Puede un usuario ver datos de otro cambiando un identificador? ¿Hay algún endpoint que la interfaz no muestra y que no comprueba permisos? ¿Cómo se guardan las contraseñas y qué pasa si se filtra la base? ¿Qué muestra un error en producción? ¿Qué hay accesible desde internet que no debería estarlo? ¿Cuánto tardaría en enterarme de que alguien está probando credenciales?
Cada una apunta a una categoría concreta, y todas se pueden responder en una tarde. Lo que no funciona es leer la lista entera y quedarse con la sensación de que hay mucho por hacer, que es el resultado habitual de enfrentarse al documento original.
La categoría que aparece cuando el sistema envejece
Hay un riesgo de la lista que no existe el día que se publica el proyecto y aparece solo con el paso del tiempo, sin que nadie haga nada. Por eso se escapa de cualquier revisión puntual.
Los componentes que se instalaron en su día se quedan en la versión que tenían. La configuración que era razonable deja de serlo cuando cambian las recomendaciones. Los permisos concedidos para una tarea siguen ahí. Y las cuentas de personas que ya no están conservan su acceso.
Ninguno de esos cambios produce un fallo visible: el sistema sigue funcionando igual de bien que el primer día. La diferencia es que su superficie de ataque creció mientras la atención sobre él bajaba.
La medida que lo corrige no es técnica sino de calendario. Una revisión anual de cuatro cosas concretas, las dependencias desactualizadas, los accesos concedidos, lo que está expuesto a internet y las credenciales que nunca se rotaron, cubre casi todo este envejecimiento.
Conviene hacerla en una fecha fija en lugar de cuando surja, porque nunca surge. Y conviene anotar qué se revisó, para que la siguiente empiece donde terminó la anterior en vez de desde cero.
Cómo usar esto sin convertirlo en un proyecto
El riesgo de un documento como este es que genere la sensación de que hay demasiado por hacer, y que por eso no se haga nada. Conviene una forma de entrar que no exija reservar una semana.
- Empieza por lo que ya está publicado, no por lo que vas a escribir. Las funcionalidades en producción son las que tienen usuarios y datos reales; lo que aún no existe puede esperar.
- Una categoría por sesión. Revisar el control de acceso de todas las pantallas en una tarde rinde más que mirar las diez categorías por encima.
- Escribe lo que encuentres aunque no lo arregles ese día. Una lista de hallazgos con su gravedad es lo que permite decidir con criterio, y evita arreglar lo fácil mientras queda abierto lo importante.
- Convierte cada hallazgo en una comprobación permanente. Si apareció una vez por un descuido, va a volver a aparecer, y una comprobación automática o una pregunta fija en la revisión evita repetir el mismo trabajo.
Ese último punto es el que marca la diferencia a largo plazo: cada revisión debería dejar el sistema no solo más seguro, sino más difícil de volver a romper de la misma manera.
Por qué esta lista importa más con código generado
Hay una relación directa entre este listado y la forma de trabajar con asistentes, y no es la que suele mencionarse.
El código generado no es peor que el escrito a mano en cuanto a errores de sintaxis o de lógica local: suele ser mejor. Donde falla es precisamente en las categorías de esta lista, porque casi todas dependen de contexto que el modelo no tiene.
No sabe qué datos son sensibles en tu negocio, ni qué usuarios deberían ver qué, ni si ese endpoint va a estar expuesto a internet. Genera lo que se le pidió, que era una funcionalidad, y las comprobaciones que nadie mencionó no aparecen.
A eso se suma un efecto de velocidad: cuando se producen diez pantallas en una tarde, la revisión que antes ocurría de forma natural al escribir cada una deja de ocurrir. El volumen de código crece más rápido que la atención disponible para revisarlo.
Por eso la lista funciona bien como guion de revisión: no para leerla entera, sino para tener cuatro o cinco preguntas fijas que se aplican a cada funcionalidad nueva antes de darla por terminada.
Qué hacer con esto a partir de mañana
Una forma realista de incorporarlo sin que se convierta en un proyecto aparte.
Elige las tres categorías que más aplican a tu sistema y escríbelas como preguntas concretas. Para una aplicación con usuarios y datos propios, casi siempre son control de acceso, validación de entradas y configuración expuesta.
Conviértelas en una comprobación que se hace antes de publicar cada funcionalidad. Tres preguntas, dos minutos, siempre las mismas. Una lista corta que se usa vale más que una exhaustiva que se consulta una vez.
Y revisa la lista completa una vez al año, o cuando salga una versión nueva, para ver si algo que antes no aplicaba ha empezado a aplicar. Los sistemas cambian, y una categoría que era irrelevante cuando no había usuarios deja de serlo cuando los hay.