Cuando una aplicación necesita reflejar cambios en tiempo real, un mensaje nuevo, el estado de un pedido, una notificación, hay tres formas distintas de resolverlo. La IA suele proponer siempre la misma sin preguntar cuál encaja con tu caso, y casi siempre propone la más compleja de las tres.
Las tres funcionan. La diferencia está en la latencia que necesitas, en si el cliente también envía datos o solo los recibe, y en cuánta complejidad operativa estás dispuesto a sostener.
Latencia, dirección e infraestructura de cada mecanismo
Antes del detalle, el cuadro completo. La columna de infraestructura es la que más se subestima al decidir.
| Polling | SSE | WebSockets | |
|---|---|---|---|
| Dirección | Cliente pregunta | Servidor envía | Ambos, en cualquier momento |
| Latencia típica | La mitad del intervalo | Casi inmediata | Casi inmediata |
| Protocolo | HTTP normal | HTTP normal | Protocolo propio tras un upgrade |
| Reconexión | No aplica | Automática del navegador | La programas tú |
| Proxies y balanceadores | Sin cambios | Sin cambios | Requieren configuración |
| Varios servidores | Trivial | Trivial | Necesita capa de mensajería |
| Costo de quitarlo después | Bajo | Bajo | Alto |
Las pestañas de abajo resumen cada mecanismo. El detalle de implementación viene después, en su propia sección.
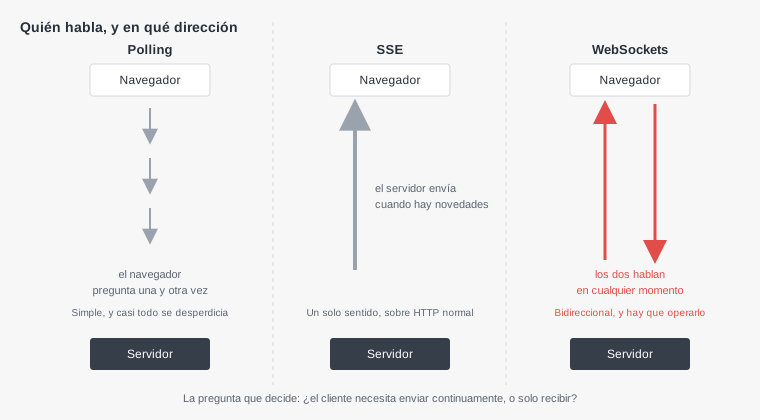
La pregunta que ordena la decisión
Antes de comparar latencias conviene responder una sola cosa: ¿el cliente necesita enviar datos en tiempo real, o solo recibirlos?
Si solo recibe, WebSockets queda descartado por sobredimensionado, y la elección se reduce a polling o SSE según qué tan rápido tenga que enterarse. Esa única pregunta elimina la mayoría de las propuestas infladas que devuelve un modelo cuando le pides algo en tiempo real sin más contexto.
Casi nadie necesita bidireccional. Casi todos piden WebSockets.
Qué significa realmente la latencia de polling
Con polling, el usuario no espera el intervalo completo ni cero: espera, en promedio, la mitad. Con un intervalo de 10 segundos, la espera media es de 5 y la peor de 10.
Ese número importa porque define si polling alcanza. Para el estado de un pedido que cambia cada varios minutos, 5 segundos de retraso medio no los nota nadie. Para un chat, sí.
El otro número es el desperdicio. Con 500 usuarios y un intervalo de 10 segundos, el servidor atiende 3.000 peticiones por minuto, y si los datos cambian pocas veces por hora, casi todas responden que no hay nada nuevo.
Ese contraste es el argumento real para pasar de polling a SSE, y aparece mucho antes por costo de servidor que por latencia.
Cómo se implementa cada uno
El código de los tres es más corto de lo que su reputación sugiere. Lo que cambia entre ellos no es el volumen, es qué tienes que resolver tú.
Polling: pedir solo lo nuevo
// Guarda la marca del último cambio recibido y pregunta solo por lo nuevo
let desde = Date.now();

setInterval(async () => {
    const r = await fetch(`/api/pedidos/cambios?desde=${desde}`);
    const { cambios, ahora } = await r.json();
    desde = ahora;              // el servidor manda su reloj, no el del cliente
    cambios.forEach(pintar);
}, 10000);
Dos detalles que se olvidan seguido. El primero es pedir solo los cambios desde la última consulta, no la lista completa cada vez. El segundo es que la marca de tiempo la debe fijar el servidor: el reloj del navegador puede estar desfasado y hacer que se pierdan o se repitan eventos.
SSE: cuatro líneas en el cliente
const flujo = new EventSource('/api/notificaciones');

flujo.addEventListener('pedido', (e) => pintar(JSON.parse(e.data)));
flujo.onerror = () => { /* el navegador reintenta solo */ };
Del lado del servidor el formato es texto plano con una estructura mínima:
header('Content-Type: text/event-stream');
header('Cache-Control: no-cache');
header('X-Accel-Buffering: no');   // evita que nginx acumule la salida

foreach ($eventos as $e) {
    echo "event: pedido\n";
    echo 'data: ' . json_encode($e) . "\n";
    echo "id: {$e['id']}\n\n";     // el navegador lo reenvía al reconectar
    flush();
}
El campo id es el que hace que la reconexión no pierda eventos: el navegador lo devuelve en la cabecera Last-Event-ID y el servidor puede retomar desde ahí. Sin él, cada corte de red deja un hueco.
WebSockets: lo que hay que escribir a mano
const ws = new WebSocket('wss://ejemplo.com/sala/42');

ws.onmessage = (e) => pintar(JSON.parse(e.data));
ws.onopen    = () => ws.send(JSON.stringify({ tipo: 'entrar', sala: 42 }));

// La reconexión hay que escribirla: el navegador no la hace por ti
ws.onclose = () => setTimeout(conectar, espera);
Esa última línea resume buena parte del costo. Una reconexión correcta necesita espera creciente entre intentos, un tope para no reintentar infinito, y recuperar el estado perdido durante el corte. Son tres cosas que en SSE no escribes.
Un chat con miles de usuarios necesita que cada servidor sepa a qué otros avisar cuando llega un mensaje, porque remitente y destinatario pueden estar conectados a servidores distintos.
Eso se resuelve con un sistema de mensajería intermedio, por ejemplo Redis Pub/Sub. Es infraestructura adicional que hay que desplegar, monitorear y pagar, y rara vez aparece en la propuesta inicial cuando uno pide un chat en tiempo real.
Dos límites que aparecen en producción
Ninguno de los dos sale en las comparativas y los dos se descubren tarde.
El tope de conexiones por dominio. Sobre HTTP/1.1 los navegadores permiten unas 6 conexiones simultáneas por dominio, y cada pestaña abierta con SSE consume una. Un usuario con cuatro pestañas de tu sitio puede agotarlas. Con HTTP/2 la restricción desaparece.
El costo por conexión en el servidor. En PHP sobre hosting compartido, cada conexión SSE abierta ocupa un proceso durante todo el tiempo que dure. Con pocos usuarios no se nota; con cientos, se agota el conjunto de procesos disponibles y el sitio deja de responder para todos, no solo para quienes usan tiempo real.
Cómo probar esto antes de desplegarlo
Los tres mecanismos se comportan bien en desarrollo, donde hay un usuario, la red no falla y el servidor tiene todos los recursos para él solo. Los problemas aparecen en condiciones que no se dan en tu máquina, así que conviene provocarlas a propósito.
Corta la red a mitad de camino. Con las herramientas del navegador se puede poner la conexión en modo desconectado unos segundos y volver a activarla. Ahí se ve si tu interfaz avisa del corte, si reconecta, y sobre todo si recupera lo que pasó mientras estuvo fuera.
Abre varias pestañas del mismo sitio. Es la forma más rápida de toparse con el tope de conexiones por dominio con SSE sobre HTTP/1.1, y de descubrir si tu servidor aguanta varias conexiones simultáneas del mismo usuario.
Deja la pestaña en segundo plano media hora. Los navegadores suspenden las pestañas inactivas para ahorrar batería, y al volver puede haber un hueco de eventos que nunca llegaron. Si tu aplicación no lo detecta, el usuario ve datos viejos creyendo que están al día.
Con polling estas tres pruebas casi siempre pasan sin cambios, porque cada consulta es independiente y pregunta por todo lo posterior a la última marca. Es otra forma de ver por qué sigue siendo una opción legítima y no un lugar de paso.
Lo que ninguna de las tres resuelve sola
Elegir el mecanismo es la mitad del problema. La otra mitad son tres cuestiones que aparecen igual con polling, con SSE y con WebSockets, y que casi nunca vienen en la propuesta inicial.
Quién puede escuchar qué
Una conexión de tiempo real es un canal de lectura al servidor, y hereda exactamente los mismos problemas de autorización que un endpoint normal. Si un usuario puede suscribirse al canal de otro cambiando un identificador, acabas de construir una fuga de datos que además es continua.
Con SSE y WebSockets esto se agrava porque la comprobación se hace una sola vez, al abrir la conexión. Si los permisos del usuario cambian mientras la conexión sigue viva, el canal sigue emitiendo con los permisos de antes hasta que algo lo cierre.
Qué pasa con lo que ocurrió mientras no estabas
Ninguno de los tres mecanismos garantiza por sí solo que no se pierdan eventos. Un túnel se cae, el teléfono se bloquea, el navegador suspende la pestaña, y durante ese hueco el servidor siguió generando cambios.
SSE trae una respuesta parcial con el identificador de evento, siempre que el servidor lo emita y sepa retomar desde ahí. Con WebSockets hay que diseñarlo a mano. Con polling el problema casi no existe, porque cada consulta pregunta por todo lo posterior a la última marca conocida, y esa es una ventaja real que rara vez se menciona.
La pregunta práctica es qué es peor para tu caso: perder un evento o mostrarlo dos veces. Si perderlo es inaceptable, el cliente necesita poder pedir lo que se perdió, y eso es un endpoint normal además del canal en vivo.
Qué ve el usuario cuando se cae
Una interfaz en tiempo real que pierde la conexión y no lo dice es peor que una que nunca la tuvo, porque el usuario sigue creyendo que lo que ve está al día.
El mínimo es un indicador de estado y, al reconectar, una recarga de lo que haya cambiado. Con SSE el navegador reintenta solo, pero tu interfaz igual tiene que enterarse de que hubo un corte para volver a pedir lo perdido.