El correo de bienvenida llegó dos veces. El cobro se hizo una sola vez. Los dos salieron del mismo evento, publicado una sola vez, en el mismo instante.
No hay contradicción ahí: es el comportamiento normal de un sistema de eventos y, si nadie lo previó, el resultado es una bandeja de entrada molesta hoy y un cobro duplicado el día que toque al otro servicio.
Los eventos resuelven un problema real de acoplamiento. Lo que traen a cambio son un puñado de garantías que dejan de cumplirse y que casi nunca aparecen en la propuesta inicial.
Qué se está desacoplando
La idea es sencilla: en lugar de que un servicio llame a los demás cuando ocurre algo, anuncia que ocurrió y sigue con lo suyo. Quien tenga interés, escucha.
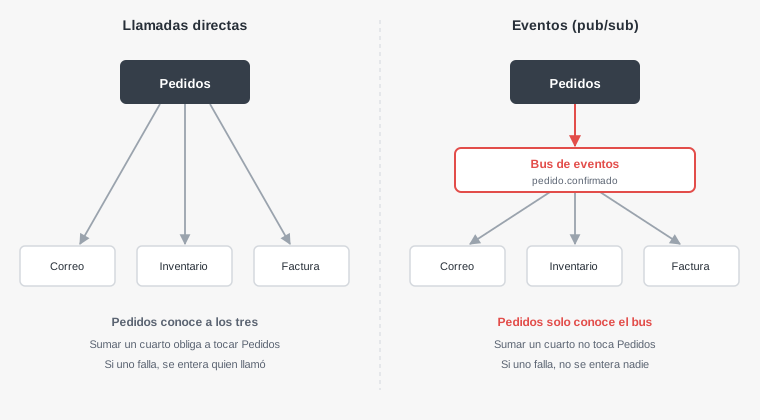
La ganancia concreta está en el cuarto servicio. Con llamadas directas, sumar un servicio de analítica obliga a modificar el de pedidos, desplegarlo y arriesgarse a romperlo. Con eventos, el nuevo servicio se suscribe y pedidos no se entera.
La pérdida está en la misma frase: pedidos no se entera. Tampoco se entera de que el correo falló, ni de que la factura nunca se generó.
Un evento dice que algo ya ocurrió: pedido.confirmado. Va en pasado, no espera respuesta y a quien lo publica no le importa quién lo escuche.
Un comando pide que algo ocurra: enviar_correo. Va dirigido a alguien concreto y suele esperar confirmación.
Publicar comandos disfrazados de eventos es el origen de buena parte de los líos: si al publicar esperas que alguien haga algo concreto, no desacoplaste nada, solo escondiste la llamada.
Trampa 1: la entrega no ocurre exactamente una vez
Es la que produjo el correo duplicado del principio, y la que más sorprende porque contradice lo que uno supone por defecto.
| Garantía | Qué significa | Qué te toca resolver |
|---|---|---|
| Como mucho una vez | Puede perderse, nunca se duplica | Detectar lo que no llegó |
| Al menos una vez | Nunca se pierde, puede llegar repetido | Que repetirlo no haga daño |
| Exactamente una vez | Ni se pierde ni se duplica | Existe, pero con condiciones y costo |
La mayoría de los servicios gestionados entregan al menos una vez, y eso es lo sensato: prefieren repetir antes que perder. Un reintento tras un tiempo de espera agotado, un reinicio del consumidor en mitad del procesamiento o una confirmación que se pierde bastan para que el mismo mensaje se procese dos veces.
Así se ve una entrega duplicada, que en los registros no parece un error:
-
10:04:01
Pedidos publica
pedido.confirmadocon identificador 8841. Una sola vez. -
10:04:02
El servicio de correo lo recibe y envía el mensaje al cliente. Correctamente.
-
10:04:32
Antes de confirmar que terminó, el proceso se reinicia por un despliegue. El bus nunca recibió la confirmación.
-
10:05:02
El bus hace lo correcto según su contrato: vuelve a entregar el mensaje, porque para él quedó sin procesar.
-
10:05:03
Se envía el segundo correo. Nadie registró un error, porque no lo hubo.
La solución no es evitar los duplicados, es que dejen de importar. Un consumidor idempotente produce el mismo resultado la primera vez y la quinta:
function alConfirmarPedido(array $evento, PDO $db): void
{
    // El identificador viaja EN el evento, no se genera al recibirlo
    $id = $evento['id'];

    // Insertar y fallar es más seguro que consultar y luego insertar:
    // entre la consulta y la inserción caben dos entregas simultáneas
    $stmt = $db->prepare(
        'INSERT INTO eventos_procesados (id) VALUES (?)
         ON CONFLICT (id) DO NOTHING'
    );
    $stmt->execute([$id]);

    if ($stmt->rowCount() === 0) {
        return;                 // ya se procesó: no es un error, es lo normal
    }

    enviarCorreo($evento['cliente']);
}
El detalle de la restricción de unicidad importa: comprobar primero y escribir después deja una ventana en la que dos entregas simultáneas pasan ambas la comprobación. Dejar que la base de datos rechace el duplicado cierra esa ventana.
No evites los duplicados. Haz que den igual.
Trampa 2: el orden tampoco está garantizado
Dos eventos publicados en orden pueden procesarse al revés. Con varios consumidores en paralelo es lo esperable, no una anomalía.
El caso que rompe: se publica pedido.confirmado y, un segundo después, pedido.cancelado. Si el segundo se procesa primero, el pedido queda cancelado y luego confirmado. Activo, cobrado y camino al cliente.
Hay tres formas de manejarlo, y la elección no es técnica sino de negocio:
- Ordenar por clave. Varios servicios permiten garantizar orden dentro de una misma clave, por ejemplo todos los eventos de un pedido. Se paga con menos paralelismo.
- Incluir un número de versión en el evento y descartar lo que llegue con una versión anterior a la ya aplicada.
- Diseñar estados que no dependan del orden: un pedido cancelado no vuelve a confirmarse, sin importar en qué orden lleguen los mensajes.
La tercera es la más robusta y la que menos se elige, porque obliga a pensar el modelo antes de escribir el consumidor.
Trampa 3: nadie sabe quién escucha
Con llamadas directas, para saber qué pasa cuando se confirma un pedido basta con leer el servicio de pedidos. Con eventos, esa información no está en ninguna parte del código.
El contrato existe aunque no esté escrito
Quien publica cree que el evento es suyo y lo cambia libremente: renombra un campo, quita otro que ya no usa. Tres servicios dejan de funcionar, y el fallo no aparece al desplegar sino la próxima vez que se publique ese evento.
Un evento publicado es una interfaz pública con los mismos deberes que una API: se versiona, se documenta y se amplía sin quitar campos.
Borrar un consumidor no borra su suscripción
Cuando un servicio deja de existir pero su suscripción sigue viva, los mensajes se acumulan en una cola que nadie lee. Eso consume almacenamiento y, en los servicios gestionados, dinero. Suele descubrirse meses después, al revisar una factura.
El flujo completo no existe en ningún sitio
Ningún archivo describe la secuencia completa de lo que ocurre al confirmar un pedido. Está repartida entre servicios que no se mencionan entre sí, y reconstruirla exige leerlos todos y confiar en que no falta ninguno.
Es la contrapartida directa del desacoplamiento: lo que ganas en independencia lo pierdes en visibilidad.
Trampa 4: depurar algo que nadie vio entero
Cuando una operación falla a mitad de camino, la pregunta es dónde se detuvo. Y no hay una traza única que responda: hay cinco registros separados, cada uno con su propia numeración.
Lo que lo hace manejable es un identificador de correlación que viaja con el evento y que cada servicio incluye en todo lo que registra:
{
  "id": "evt_01J9X2K",
  "tipo": "pedido.confirmado",
  "correlacion": "req_7f3a91",
  "version": 2,
  "ocurrido_en": "2026-09-14T10:04:01Z",
  "datos": { "pedido_id": 8841 }
}
Con ese campo, buscar req_7f3a91 devuelve la historia completa en los cinco servicios. Sin él, hay que cruzar marcas de tiempo a mano y confiar en que los relojes están sincronizados.
Conviene añadirlo desde el primer evento. Incorporarlo después obliga a tocar todos los consumidores a la vez, que es justamente lo que la arquitectura de eventos intentaba evitar.
Trampa 5: guardar y publicar no son una sola operación
Esta es la más silenciosa de todas, y la que rompe la confianza en los datos.
El código habitual hace dos cosas seguidas: escribe en la base y publica el evento. Parecen un solo paso, pero son dos sistemas distintos y nada garantiza que ocurran los dos.
$db->beginTransaction();
$pedidos->confirmar($id);
$db->commit();                    // ✓ el pedido quedó confirmado

$bus->publicar('pedido.confirmado', ['pedido_id' => $id]);
// ✗ si esto falla, el pedido está confirmado y nadie se entera nunca
Si el bus está caído o la red falla en ese instante, el pedido queda confirmado en la base y el correo no sale, la factura no se genera y el inventario no se descuenta. Nada registra un error: la operación principal terminó bien.
Invertir el orden no ayuda, solo cambia el síntoma: publicas primero y, si la escritura falla, hay tres servicios reaccionando a un pedido que no existe.
Se llama bandeja de salida, y consiste en escribir el evento en una tabla de la misma base, dentro de la misma transacción que el cambio de negocio.
Si la transacción se confirma, el cambio y el evento quedan juntos. Si falla, no queda ninguno de los dos. Después, un proceso aparte lee esa tabla y publica al bus, reintentando hasta conseguirlo.
-- Una sola transacción: o quedan los dos, o no queda ninguno
BEGIN;
  UPDATE pedidos SET estado = 'confirmado' WHERE id = 8841;
  INSERT INTO eventos_salientes (tipo, datos, publicado)
    VALUES ('pedido.confirmado', '{"pedido_id":8841}', false);
COMMIT;
El precio es un pequeño retraso, el que tarde el proceso publicador en pasar. A cambio, deja de existir la posibilidad de que el sistema cambie de estado sin que nadie se entere, que es el fallo caro.
Y encaja con lo dicho antes: como el publicador reintenta hasta confirmar, puede publicar dos veces el mismo evento. Por eso el identificador propio y el consumidor idempotente no son opcionales, son la otra mitad de esta solución.
Qué pasa cuando un consumidor no puede procesar algo
Un evento con un dato corrupto, un servicio externo caído o un fallo en el código del consumidor producen la misma situación: el mensaje no se puede procesar. Y aquí es donde muchos sistemas se atascan de una forma peculiar.
Si el consumidor falla y el bus reintenta, vuelve a fallar. Y otra vez. El mismo mensaje se procesa en bucle, consumiendo recursos y, lo que es peor, bloqueando a los que vienen detrás si hay garantía de orden.
Las dos piezas que lo resuelven suelen quedar sin montar hasta el día del incidente:
- Espera creciente entre reintentos. Reintentar de inmediato ante un servicio caído solo añade carga a algo que ya está en problemas. Cada intento espera más que el anterior, con un pequeño margen aleatorio para que todos los consumidores no reintenten a la vez.
- Una cola para lo que no se pudo procesar. Tras un número acotado de intentos, el mensaje se aparta a una cola separada en lugar de reintentarse para siempre. El flujo sigue y el mensaje queda guardado para revisarlo.
Esa segunda cola solo sirve si alguien la mira. Sin una alerta cuando deja de estar vacía, es un cajón donde los errores se acumulan en silencio, que es exactamente la situación que se intentaba evitar.
Conviene además decidir qué hacer con lo que cae ahí. Un evento apartado no es un error que se descarta: representa algo que ocurrió de verdad en el negocio y que quedó a medias. Reprocesarlo tras arreglar la causa es parte del diseño, no una tarea de emergencia.
Cuándo no usar eventos
La regla práctica es corta: si necesitas la respuesta para continuar, no es un evento.
Validar un pago, comprobar si queda inventario antes de confirmar o autenticar a alguien son operaciones donde el resultado condiciona lo siguiente. Convertirlas en eventos añade complejidad para simular una espera que con una llamada directa era gratis.
Tampoco compensan cuando hay un solo consumidor y no se prevén más: un bus entre dos servicios es infraestructura que mantener, y la llamada directa dice exactamente quién habla con quién.
Y hay un caso intermedio que se pasa por alto: se puede publicar eventos sin bus. Una tabla en la base de datos que registre lo ocurrido, y un proceso que la lea cada pocos segundos, da desacoplamiento, reintentos e historial, con la infraestructura que ya tienes. Es suficiente durante mucho más tiempo del que suele suponerse, y el salto a un bus real es directo cuando llegue.