Un proyecto que arranca hoy puede tener autenticación, base de datos, almacenamiento de archivos y una API funcionando en una tarde. Hace diez años eso era trabajo de semanas, y buena parte de la diferencia la explican los servicios que venden todo ese bloque ya montado.
Esa velocidad es real y conviene aprovecharla. Lo que conviene entender antes es qué se está aceptando a cambio, porque la decisión afecta a cosas que se descubren mucho después: dónde viven tus datos, quién responde cuando algo falla de madrugada y cuánto costaría irse.
BaaS es un servicio que te entrega el bloque completo de servidor listo para usar: base de datos, usuarios, archivos y permisos, con una interfaz para configurarlo.
Self-hosted significa que ese mismo bloque lo ejecutas tú, en una máquina que alquilas, y te encargas de mantenerlo en marcha.
Varias herramientas se ofrecen de las dos formas, así que la elección no es tanto de producto como de quién lo opera.
Quién opera cada capa
La comparación más útil no es de funciones, porque en eso se parecen bastante. Es de reparto de trabajo.
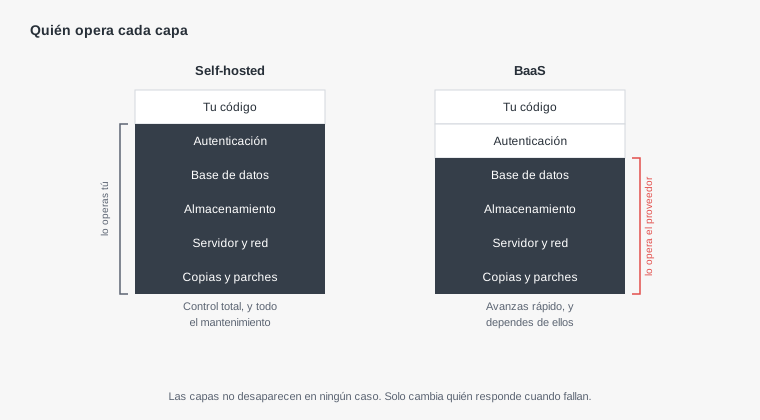
Lo importante del dibujo es que ninguna capa desaparece. Las actualizaciones de seguridad hay que aplicarlas igual, las copias hay que hacerlas igual y alguien tiene que estar disponible cuando el servicio deje de responder. La elección es si esa persona eres tú o es el equipo de alguien más.
Para un proyecto de una o dos personas, esa diferencia pesa más que cualquier comparación de características. El tiempo que se va en operar no se va en construir, y suele llegar en el peor momento, porque los servidores no fallan en horario de oficina.
Lo que de verdad se gana con un BaaS
La ventaja evidente es la velocidad de arranque, y es la que todos mencionan. Hay otras tres que se notan más adelante y se mencionan menos.
La primera es que ciertas piezas difíciles vienen resueltas y probadas. La autenticación, con su recuperación de contraseña, verificación de correo y sesiones, es un componente que se hace mal con facilidad y cuyos fallos son caros. Usar una implementación que ya han auditado miles de proyectos es una decisión sensata.
La segunda es que el trabajo de mantenimiento simplemente no aparece en tu calendario. No hay parches que aplicar ni versiones que actualizar con miedo.
La tercera, menos obvia: cuando algo falla a las tres de la mañana, hay alguien de guardia que no eres tú. Para un proyecto personal eso puede ser la diferencia entre sostenerlo o abandonarlo.
Lo que se gana alojándolo uno mismo
El argumento habitual a favor es el costo, y es el menos sólido de todos en proyectos pequeños, porque a poco volumen los planes gestionados suelen salir baratos o gratis.
Las razones fuertes son otras. La primera es el control sobre los datos: dónde están físicamente, quién puede verlos y bajo qué jurisdicción caen. Para proyectos con datos sensibles o requisitos legales concretos, esa pregunta puede decidirlo todo antes de mirar nada más.
La segunda es que no hay sorpresas de producto. Un servicio gestionado puede cambiar precios, retirar funciones o cerrar. Un componente que ejecutas tú sigue funcionando exactamente igual mañana.
La tercera es el techo. Cuando el volumen crece, los planes gestionados escalan en precio de forma que a partir de cierto punto un servidor propio resulta claramente más barato. Ese punto llega más tarde de lo que la mayoría espera, pero llega.
Las dos opciones, punto por punto
| BaaS gestionado | Self-hosted | |
|---|---|---|
| Tiempo hasta algo funcionando | Horas | Días |
| Quién aplica los parches | El proveedor | Tú |
| Quién responde de madrugada | Su equipo | Tú |
| Costo con poco volumen | Bajo o gratis | El del servidor |
| Costo con volumen alto | Crece rápido | Más predecible |
| Dónde viven los datos | Donde decide el proveedor | Donde tú decidas |
| Riesgo de cambio de producto | Real | Ninguno |
| Costo de salida | Semanas o meses | Días |
La última fila merece atención, porque es la que se ignora al elegir y la que más duele al cambiar de opinión. Y no todos los servicios están en el mismo punto: los que se apoyan en un motor estándar dejan salir con los datos en un formato que otro sistema entiende, mientras que los que usan un modelo propio atan mucho más.
Esa distinción vale más que la comparación de precios. Un servicio construido sobre una base de datos común permite, llegado el caso, llevarse los datos y montarlos en otro sitio; uno con almacenamiento propietario convierte esa mudanza en una reescritura.
La prueba que conviene hacer el primer día
Con cualquiera de las dos opciones, hay una comprobación que resuelve la mayor parte de la incertidumbre y casi nadie hace hasta que la necesita con urgencia.
Antes de construir nada encima, exporta los datos de prueba y mira el archivo. Comprueba que están las relaciones, que el formato lo lee algo que no sea el propio producto y que el proceso termina.
Si la exportación funciona bien, tu costo de salida es alto pero conocido. Si no, acabas de descubrir tu dependencia más cara en un día tranquilo.
Conviene repetirla cuando el volumen crezca, porque muchas exportaciones funcionan con datos de prueba y fallan por tiempo de espera con los reales.
El error de usarlo como si fuera solo una base de datos
Hay un patrón que aparece con frecuencia cuando el código lo escribe una IA, y que anula buena parte del valor de estos servicios.
Estas plataformas incluyen un sistema de permisos que se define en el propio servicio y decide qué puede ver y modificar cada usuario. Es su pieza más importante, porque el cliente habla directamente con la base de datos y no hay un servidor propio que filtre en medio.
Cuando esas reglas se dejan abiertas para que todo funcione mientras se desarrolla, y nadie las cierra después, el resultado es una base de datos donde cualquiera con la clave pública puede leer o modificar lo que quiera. No hace falta ningún ataque sofisticado: basta con pedir los datos.
Es un fallo frecuente y grave, y no produce ningún síntoma: la aplicación funciona perfectamente. La única forma de detectarlo es revisarlo a propósito, intentando acceder a datos de otro usuario desde una sesión distinta antes de publicar.
El cliente habla con la base de datos, y eso cambia todo
Hay una diferencia de arquitectura entre estas plataformas y un backend tradicional que conviene entender, porque de ella salen casi todas sus ventajas y todos sus riesgos.
En una aplicación clásica, el navegador habla con tu servidor y tu servidor habla con la base de datos. Ese servidor intermedio decide qué se puede pedir, valida lo que llega y filtra lo que sale. Es una capa de control que existe porque alguien la escribió.
En un BaaS usado de la forma habitual, el navegador habla directamente con la plataforma. No hay servidor propio en medio, y esa es la razón de que se avance tan rápido: desaparece todo el código que solo servía para pasar datos de un lado a otro.
Lo que ocupa el lugar de ese control son las reglas de acceso configuradas en el servicio. No son un detalle de seguridad añadido al final: son la única cosa que separa los datos de cualquiera que abra las herramientas de desarrollo del navegador y vea la clave pública.
Entenderlo así cambia la prioridad. Las reglas dejan de ser una tarea pendiente para el final y pasan a ser la pieza que hay que escribir junto con cada tabla, porque una tabla sin regla es una tabla abierta.
Lo que conviene resolver del lado del servidor igualmente
Aunque el modelo permita prescindir del servidor propio, hay operaciones que no deberían ocurrir nunca en el navegador, y esta es la lista corta de las que más problemas causan cuando se ignoran.
- Cualquier cosa que use una clave secreta. Una llave de pagos o de un servicio externo puesta en el cliente es una llave publicada, por mucho que esté en una variable de entorno del proceso de construcción.
- Cálculos que determinan dinero. El precio final, el descuento aplicado o el total de un pedido tienen que calcularse donde el usuario no pueda intervenir. Confiar en el importe que manda el cliente es un error clásico y caro.
- Validaciones que importan de verdad. Las del navegador son para ayudar a quien rellena el formulario, no para proteger los datos. Se saltan con un par de clics.
- Operaciones que tocan varios registros a la vez. Si a mitad de la secuencia el usuario cierra la pestaña, queda un estado incompleto que nadie va a reparar.
Todas estas plataformas ofrecen una forma de ejecutar código propio en su lado, con nombres distintos según el producto. Usarla para esa lista corta, y solo para ella, mantiene la velocidad del modelo sin dejar los huecos que más duelen.
La regla práctica que resume el criterio es sencilla: si un usuario malintencionado pudiera beneficiarse modificando la petición, esa lógica no puede vivir en el navegador.
Qué mirar antes de comprometerse con un servicio
Más allá de la comparación general, hay cuatro preguntas concretas que distinguen bastante entre productos y que conviene responder antes de construir encima.
La primera es sobre el motor: si lo que hay debajo es una base de datos estándar o un almacenamiento propio. Esa respuesta determina casi por completo el costo de salida, y suele estar en la primera página de su documentación.
La segunda es sobre el desarrollo local: si se puede ejecutar el servicio en tu propia máquina mientras trabajas. Poder hacerlo evita depender de la red para programar, permite probar sin tocar datos reales y, de paso, demuestra que el producto se puede ejecutar fuera de su nube.
La tercera es sobre los límites del plan gratuito y del siguiente. Conviene saber qué se agota primero y qué ocurre al agotarse, porque algunos servicios simplemente dejan de responder y otros cobran.
La cuarta es sobre las copias de seguridad: si el plan que vas a usar las incluye, con qué frecuencia y durante cuánto tiempo. En varios servicios las copias automáticas empiezan en un plan de pago, y ese detalle cambia la comparación de precios.
Cómo decidir sin quedarte atrapado
Para la mayoría de los proyectos que empiezan, la respuesta razonable es un servicio gestionado, y conviene decirlo sin rodeos: la velocidad de arranque importa más que la independencia cuando todavía no se sabe si el proyecto va a existir dentro de seis meses.
Lo que sí conviene desde el principio es no dejar que la dependencia crezca sin control. Mantener las llamadas al servicio concentradas en un punto del código, y no repartidas por toda la aplicación, cuesta muy poco al escribirlo y convierte una futura migración en un trabajo acotado.
Y hay un criterio que ordena la decisión mejor que cualquier tabla: si el proyecto maneja datos cuya filtración sería un problema serio, o hay un requisito legal sobre dónde deben residir, esa pregunta se responde primero y condiciona todo lo demás. En cualquier otro caso, empezar gestionado y reevaluar cuando el volumen lo justifique es la opción reversible.