Existen buscadores especializados en encontrar credenciales publicadas por accidente en repositorios. No son herramientas clandestinas: cualquiera puede usarlas, y hay gente que las ejecuta de forma continua sobre todo lo que se publica en internet.
El tiempo entre que una clave aparece en un repositorio público y alguien la prueba se mide en minutos, no en días. Por eso este tema no admite el razonamiento habitual de que un proyecto pequeño no le interesa a nadie: no hay nadie eligiendo objetivos, hay programas recorriendo todo lo que se publica.
Por qué el repositorio es el peor sitio posible
Un repositorio está diseñado para conservar todo lo que pasó por él. Esa virtud, que es lo que lo hace útil, es exactamente lo que lo convierte en un mal lugar para un secreto.
Se copia entero cada vez que alguien lo descarga, así que una credencial subida hoy queda en la máquina de todos los que trabajaron en el proyecto. Se sincroniza con servicios externos de integración y análisis. Y, sobre todo, guarda el historial: borrar el archivo en un cambio posterior no elimina nada, solo añade un cambio que dice que el archivo ya no está.
Ese último punto es el que más confusión genera. Mucha gente cree haber resuelto el problema al borrar el archivo y hacer un nuevo envío. La credencial sigue ahí, a un comando de distancia, para siempre.
La conclusión práctica es dura y conviene asumirla: todo secreto que haya entrado alguna vez en un repositorio debe considerarse filtrado, aunque sea privado y aunque se haya borrado después. La única respuesta válida es rotarlo.
Dónde deben vivir los secretos
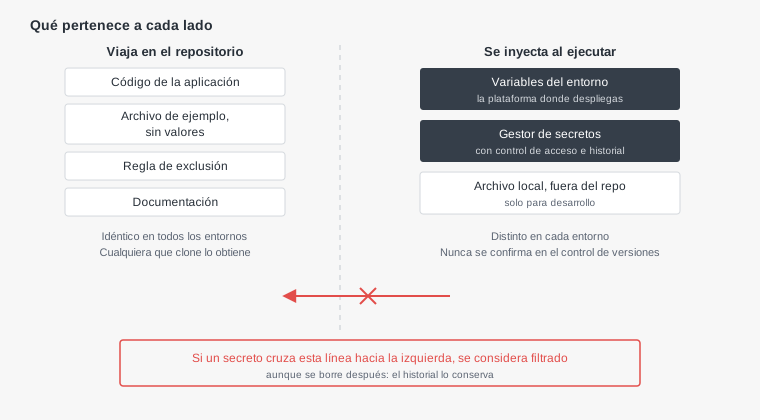
El principio que ordena este terreno es viejo y sigue vigente: la configuración que cambia según el entorno no pertenece al código, y los secretos son el caso extremo de esa regla.
El código debe ser idéntico en desarrollo y en producción. Lo que cambia entre ambos, las direcciones de las bases de datos, las claves, los modos de depuración, se inyecta desde fuera en el momento de ejecutar.
Las opciones razonables, de menor a mayor esfuerzo, son tres. La primera es la sección de variables de entorno de la plataforma donde se despliega, que para la mayoría de los proyectos pequeños es suficiente y no cuesta nada. La segunda es un gestor de secretos dedicado, que añade control de acceso, historial y rotación asistida. La tercera, en máquinas propias, son archivos fuera del directorio del proyecto con permisos restringidos.
Lo que ninguna de las tres hace es dejar el valor escrito en un archivo que viaja con el código, que es precisamente lo que ocurre por defecto cuando nadie decide nada.
El archivo local y la trampa que esconde
En desarrollo lo habitual es un archivo con las variables, que no se sube y que cada persona tiene en su máquina. Es una práctica correcta y tiene dos detalles que fallan constantemente.
El primero es que la regla de exclusión se añade tarde. Si el archivo se creó y se subió antes de escribir la regla, la exclusión no lo saca del historial: solo evita futuros cambios. El orden correcto es escribir la regla primero y crear el archivo después.
El segundo es el archivo de ejemplo, que sí debe subirse y que sirve para que alguien nuevo sepa qué variables hacen falta. La trampa está en que se genera copiando el archivo real, y si no se vacían los valores, se acaba de subir todo lo que se quería proteger.
El archivo de ejemplo lleva los nombres de las variables y valores vacíos o claramente falsos. Nunca el valor real, ni siquiera el de desarrollo.
Y conviene que la aplicación falle al arrancar si falta una variable obligatoria, en lugar de continuar con un valor vacío y romperse más tarde de forma confusa.
Hay un tercer caso que sorprende a quien trabaja con interfaces modernas: las variables destinadas al navegador no son secretas por estar en un archivo de configuración. Se incrustan en el paquete que se envía al cliente, así que cualquiera puede leerlas abriendo las herramientas del navegador. Si una clave debe permanecer secreta, no puede usarse desde el código que se ejecuta en el navegador, y ningún prefijo ni convención de nombres cambia eso.
Quién puede ver los secretos del proyecto
Sacar las credenciales del repositorio resuelve la mitad del problema. La otra mitad es quién tiene acceso al sitio donde acabaron, y esa pregunta casi nunca se hace.
En la mayoría de las plataformas, cualquier persona con permiso sobre el proyecto puede ver las variables de entorno configuradas. Eso significa que un colaborador temporal, alguien que entró para una tarea puntual o una integración externa conectada al repositorio pueden leer las claves de producción.
La consecuencia práctica es que el acceso al panel de configuración debe tratarse con el mismo cuidado que el acceso a la base de datos, porque son equivalentes: quien puede leer la credencial puede hacer todo lo que la credencial permite.
Conviene además revisar qué aplicaciones de terceros están conectadas al repositorio y qué permisos tienen. Es una lista que crece sola, con herramientas que se probaron una vez y nunca se desconectaron, y cada una es una vía de acceso que sigue abierta.
Cuando la plataforma lo permite, separar los secretos por entorno con permisos distintos evita el caso más común: que alguien con acceso legítimo a desarrollo lo tenga también a producción sin que nadie lo decidiera.
Que falten variables debe romper pronto y claro
Hay un detalle de implementación que parece menor y que determina si este esquema se sostiene con el tiempo: qué hace la aplicación cuando una variable no está.
El comportamiento por defecto en casi todos los lenguajes es devolver un valor vacío. La aplicación arranca, parece funcionar y falla más tarde con un error que no menciona la variable ausente. Alguien pasa media hora buscando la causa y, cuando la encuentra con prisa, la escribe directamente en un archivo para salir del paso.
La alternativa es comprobar al arrancar que están todas las variables obligatorias y detener el proceso con un mensaje que diga exactamente cuál falta. Son unas pocas líneas y convierten un problema confuso en uno evidente.
// Al arrancar, antes de cualquier otra cosa
$obligatorias = ['DB_DSN', 'DB_USER', 'DB_PASS', 'APP_KEY'];

foreach ($obligatorias as $nombre) {
    if (getenv($nombre) === false || getenv($nombre) === '') {
        fwrite(STDERR, "Falta la variable de entorno: $nombre\n");
        exit(1);
    }
}
Esa comprobación tiene un beneficio adicional que se nota al incorporar a alguien nuevo: en lugar de descubrir las variables necesarias por ensayo y error, el programa las enumera en el primer intento.
Detectarlo antes de que ocurra
Depender de la disciplina individual no funciona, porque el descuido ocurre justo el día con prisa. Lo que sí funciona es que una máquina revise antes de que el cambio salga.
- Una comprobación automática antes de confirmar el cambio. Se ejecuta en la máquina de quien programa y busca patrones que parecen credenciales. Detiene el envío antes de que exista el problema.
- Un análisis en el servidor de integración. Cubre a quien no tenga la comprobación local instalada, que siempre es alguien.
- El escaneo que ofrecen las propias plataformas de alojamiento de código, que además avisan al proveedor cuando detectan una clave suya, y en varios casos la revocan automáticamente.
- Una revisión del historial completo, una vez. Si el proyecto lleva tiempo funcionando, conviene mirar qué hay en el pasado antes de dar por buena la situación actual.
Esa última revisión suele deparar sorpresas en proyectos con más de un año, y es mejor descubrirlas en una tarde tranquila que por un aviso del proveedor.
Qué hacer si ya está subido
Si la credencial ya viajó al repositorio, el orden de los pasos determina si esto queda en un susto.
Lo primero, siempre, es rotar la credencial en el proveedor. Antes de limpiar, antes de avisar, antes de cualquier otra cosa. Mientras el valor siga siendo válido, todo lo demás es cosmético.
Lo segundo es comprobar en los registros del proveedor si se usó desde algún lugar desconocido, porque eso decide si estamos ante una limpieza o ante un incidente que hay que tratar como tal.
Lo tercero es la limpieza del historial, que en un repositorio compartido obliga a reescribirlo y a coordinar con todo el equipo. Merece la pena en repositorios públicos; en uno privado con la credencial ya rotada, a menudo el esfuerzo no compensa frente al riesgo de romper el historial de todos.
Y lo cuarto es cerrar la causa. Si el secreto acabó ahí porque no había otro sitio donde ponerlo, volverá a ocurrir mientras eso no cambie.
Los comandos, paso a paso
Hasta aquí el qué y el porqué. Esta sección es el cómo, con los comandos concretos en el orden en que conviene ejecutarlos.
1. Averiguar si hay algo comprometido
Lo primero es saber si el archivo está siendo seguido por el control de versiones, porque de eso depende todo lo demás.
# ¿Git está siguiendo este archivo ahora mismo?
git ls-files --error-unmatch .env

# ¿Aparece en algún momento del historial?
git log --all --oneline -- .env

# Buscar patrones que parecen credenciales en todo el historial
git grep -nI -e "API_KEY" -e "SECRET" -e "PASSWORD" -e "BEGIN PRIVATE KEY" $(git rev-list --all)
Ese último comando recorre todos los commits del repositorio y puede tardar en proyectos grandes. Si devuelve resultados, cada uno es una credencial que hay que dar por filtrada.
2. Sacar el archivo del seguimiento sin borrarlo
Si el archivo está siendo seguido pero aún no se ha enviado al repositorio remoto, esto basta y es la situación más cómoda.
# Primero, la regla de exclusión
echo ".env" >> .gitignore

# Quitarlo del índice conservando el archivo en tu disco
git rm --cached .env

git add .gitignore
git commit -m "Excluir el archivo de entorno del control de versiones"
La opción --cached es la parte importante: sin ella, el comando borra el archivo de tu máquina, que casi nunca es lo que se quiere.
3. Si el commit todavía no se ha enviado
Cuando la credencial está en el último commit y ese commit sigue siendo local, se corrige sin reescribir nada compartido.
# Deshacer el último commit conservando los cambios en el disco
git reset --soft HEAD~1

# Quitar el archivo del índice y rehacer el commit sin él
git rm --cached .env
git commit -m "Mensaje del commit original"
Conviene comprobar antes con git status y git log origin/main..HEAD qué commits son locales todavía. Si el commit ya viajó, este camino no sirve y hay que ir al siguiente.
4. Si ya está en el historial compartido
Aquí no hay atajo: hay que reescribir el historial, y eso afecta a todo el que tenga copia del repositorio. La herramienta recomendada hoy por la propia documentación de Git es git filter-repo, que sustituyó a la antigua filter-branch.
# Trabaja siempre sobre una copia fresca, nunca sobre tu repo de trabajo
git clone --mirror git@servidor:usuario/proyecto.git proyecto-limpieza
cd proyecto-limpieza

# Eliminar el archivo de todo el historial
git filter-repo --path .env --invert-paths

# Alternativa: sustituir un valor concreto allí donde aparezca
# (requiere un archivo con lineas del tipo  valor-secreto==>ELIMINADO )
git filter-repo --replace-text reemplazos.txt

# Volver a publicar el historial reescrito
git push --force --all
git push --force --tags
Después de esto, cualquiera con una copia debe volver a clonar. Si intentan integrar su copia antigua, reintroducen los commits eliminados y el trabajo se pierde.
Rotar la credencial va siempre antes de limpiar el historial. La reescritura puede tardar horas en coordinarse con el equipo, y durante todo ese tiempo la clave sigue siendo válida si no se rotó.
Además, en muchas plataformas los commits eliminados siguen siendo accesibles por su identificador durante un tiempo, e incluso indefinidamente si alguien hizo una copia del proyecto.
5. Evitar que vuelva a pasar
Una comprobación local que se ejecuta antes de cada commit detiene el problema antes de que exista. Sin instalar nada, con un gancho propio:
# Crear el gancho
cat > .git/hooks/pre-commit <<'FIN'
#!/bin/sh
# Rechaza el commit si aparecen patrones que parecen credenciales
if git diff --cached -U0 | grep -nE "(API_KEY|SECRET|PASSWORD|TOKEN)[[:space:]]*=[[:space:]]*['\"][^'\"]{8,}"; then
    echo "Posible credencial en los cambios. Revisa antes de confirmar."
    exit 1
fi
FIN

chmod +x .git/hooks/pre-commit
Es una comprobación simple y por eso tiene falsos positivos y se le escapan cosas. Para algo más completo existen herramientas de código abierto dedicadas a esto, como gitleaks o git-secrets, que se integran igual como gancho y traen conjuntos de patrones mantenidos.
El inconveniente de los ganchos locales es que viven en la carpeta .git y no se comparten al clonar, así que cada persona debe instalarlos. Por eso conviene complementarlos con la misma comprobación en el servidor de integración, que cubre a quien no lo tenga puesto.
El caso particular de trabajar con IA
Este flujo de trabajo añade dos vías de exposición que no existían antes y que conviene tener presentes.
La primera es pegar código en una conversación para pedir ayuda. Es tan habitual que se hace sin pensar, y con frecuencia ese fragmento incluye la configuración real. Cualquier credencial que haya pasado por ahí debe darse por expuesta y rotarse.
La segunda es más sutil: al pedir que se genere código de conexión, el resultado frecuente incluye la clave escrita directamente en el archivo, porque así el ejemplo funciona a la primera. Ese código se copia, funciona, y el valor se queda donde lo puso el ejemplo.
La frase que corrige lo segundo es pedir explícitamente que las credenciales se lean de variables de entorno y que el programa falle si faltan. Con eso el código generado ya sale con la estructura correcta en lugar de tener que arreglarla después.
Y conviene revisar siempre qué archivos se han creado, porque los asistentes que escriben en el proyecto pueden añadir archivos de configuración o de ejemplo que no estaban previstos en la regla de exclusión.