La pregunta de qué base de datos usar suele resolverse por costumbre, no por análisis: usas la que ya conoces, o la que la IA propuso primero. Las tres opciones más comunes son sólidas, pero sirven para escenarios distintos, y elegir mal no se nota el primer mes. Se nota cuando el proyecto ya tiene usuarios reales y migrar duele.
Este artículo compara las tres por los criterios que de verdad cambian la decisión: concurrencia de escritura, operación y costo de salida.
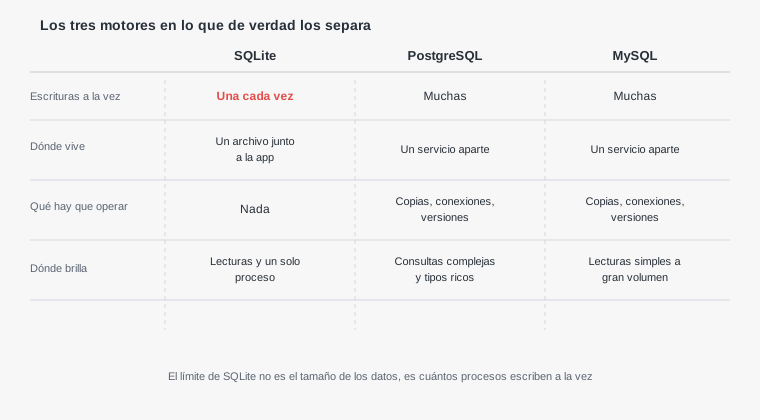
Concurrencia, operación y costo de cada motor
| SQLite | PostgreSQL | MySQL | |
|---|---|---|---|
| Qué es | Una librería sobre un archivo | Un servidor | Un servidor |
| Proceso aparte | No | Sí | Sí |
| Escrituras simultáneas | Una a la vez | Muchas | Muchas |
| Lecturas simultáneas | Muchas | Muchas | Muchas |
| Límite práctico | Concurrencia de escritura | Recursos del servidor | Recursos del servidor |
| Copia de seguridad | Copiar un archivo | Herramienta dedicada | Herramienta dedicada |
| Hosting compartido | Casi siempre disponible | Poco frecuente | Casi siempre disponible |
| Costo mensual típico | Cero | Desde unos dólares | Desde unos dólares |
La fila que decide casi todos los casos es la tercera. Las demás son consecuencias.
SQLite
SQLite no es un servidor de base de datos, es una librería que lee y escribe directamente en un archivo. No hay proceso separado que administrar, no hay configuración de red, no hay usuarios ni contraseñas que gestionar.
Para un proyecto pequeño, una aplicación de escritorio, un prototipo o un sitio con tráfico bajo y pocas escrituras simultáneas, es difícil encontrar algo más simple.
El límite de SQLite no es cuántos datos aguanta. Un archivo de varios gigabytes funciona sin problema, y para lectura es rapidísimo porque no hay red de por medio.
El límite es que solo admite una escritura a la vez. Todo lo demás se deriva de ahí.
Esa restricción se suaviza bastante con una configuración que muchos proyectos no activan:
-- Permite leer mientras alguien escribe, en vez de bloquear todo
PRAGMA journal_mode = WAL;

-- Espera hasta 5 segundos antes de fallar con "database is locked"
PRAGMA busy_timeout = 5000;

-- Compromiso razonable entre durabilidad y velocidad de escritura
PRAGMA synchronous = NORMAL;
Sin WAL, una escritura bloquea también a los lectores. Con él, las lecturas siguen funcionando mientras alguien escribe, que es el patrón de la mayoría de los sitios: muchas lecturas y pocas escrituras.
Aun así, las escrituras siguen siendo de a una. Si dos peticiones intentan escribir al mismo tiempo, la segunda espera. Con pocas escrituras por minuto eso es invisible; con decenas por segundo, se convierte en errores de bloqueo.
Hay un segundo límite que se descubre tarde: SQLite vive en el disco de esa máquina. Si mañana necesitas dos servidores de aplicación, no hay forma directa de que ambos escriban en el mismo archivo. Ese es el punto donde SQLite deja de alcanzar, y llega por arquitectura, no por tamaño.
PostgreSQL
PostgreSQL es la opción con el ecosistema más completo: tipos de datos avanzados como JSON nativo y arrays, búsqueda de texto completo, extensiones para datos geográficos o vectoriales, y un motor de concurrencia pensado para muchas escrituras simultáneas sin bloquear el sistema entero.
Ese poder tiene un costo de operación: necesitas un servidor corriendo, configurado, con copias de seguridad, actualizaciones de versión y alguien pendiente de que no se caiga. Los proveedores gestionados reducen bastante esa carga a cambio de una factura mensual.
Hay una consecuencia de su modelo de concurrencia que conviene conocer antes de que aparezca: PostgreSQL guarda versiones de cada fila para que los lectores no bloqueen a los escritores, y esas versiones antiguas hay que limpiarlas.
La limpieza es automática, pero en tablas con muchas actualizaciones puede quedarse atrás y hacer que el tamaño en disco crezca muy por encima de lo que suman los datos. Es el motivo más común de sorpresas de espacio en proyectos que llevan meses corriendo.
MySQL
MySQL ocupa un lugar parecido a PostgreSQL en cuanto a necesitar un servidor propio, pero con un ecosistema históricamente orientado a aplicaciones web tradicionales: WordPress, la mayoría de los CMS clásicos, y años de documentación y hosting compartido pensados específicamente para él.
Si tu stack ya vive en ese mundo, es la opción con menos fricción, y eso vale más de lo que suele admitirse en las comparativas técnicas.
Técnicamente la brecha con PostgreSQL es hoy más chica de lo que era, aunque PostgreSQL sigue con ventaja en funciones avanzadas y en el manejo de datos semiestructurados.
Hay una trampa específica de MySQL que cuesta cara y que la IA no suele mencionar: el juego de caracteres. Durante años, utf8 en MySQL no era UTF-8 completo y no admitía emoji ni ciertos caracteres asiáticos, porque usaba tres bytes en vez de cuatro.
-- Esto NO es UTF-8 completo, pese al nombre
CREATE TABLE mensajes (texto TEXT) CHARACTER SET utf8;

-- Esto sí
CREATE TABLE mensajes (texto TEXT)
  CHARACTER SET utf8mb4
  COLLATE utf8mb4_unicode_ci;
Descubrirlo después de tener datos guardados implica una migración de todas las tablas afectadas. Vale la pena revisarlo el primer día.
El problema que aparece después de elegir
Elegido el motor, el siguiente dolor no viene del motor: viene de cómo consultas los datos. Una tabla con diez mil filas responde rápido con cualquier consulta, incluso con las mal escritas. La misma consulta sobre un millón de filas puede tardar segundos.
Ese salto sorprende porque no es gradual. El sistema funciona bien durante meses y un día empieza a ir lento, sin que nadie haya cambiado nada: simplemente se cruzó el umbral donde recorrer la tabla entera dejó de ser barato.
Cuando la base de datos no tiene por dónde buscar, lee todas las filas una por una y descarta las que no cumplen. Con pocas filas es instantáneo. El costo crece en proporción directa al tamaño de la tabla.
Un índice es lo que evita ese recorrido: una estructura aparte que le permite ir directo a las filas que importan.
Los tres motores te dicen cuál de las dos cosas está haciendo, con la misma palabra:
-- Antepón EXPLAIN a cualquier consulta lenta
EXPLAIN ANALYZE
SELECT * FROM pedidos WHERE usuario_id = 42 ORDER BY creado_en DESC;

-- En la salida buscas una de estas dos:
--   Seq Scan on pedidos        <- lee la tabla entera, mal indicio
--   Index Scan using idx_...   <- va directo, bien
Esa lectura es la habilidad más rentable de toda esta sección, porque convierte "va lento" en un diagnóstico concreto. Y es la misma en los tres motores, aunque la salida se vea distinta.
El índice que resuelve la consulta de arriba cubre las dos columnas que intervienen, en el orden en que se usan:
-- Primero por lo que se filtra, después por lo que se ordena
CREATE INDEX idx_pedidos_usuario_fecha
    ON pedidos (usuario_id, creado_en DESC);
El orden de las columnas importa y es la fuente de confusión más común: un índice sobre (usuario_id, creado_en) sirve para buscar por usuario, y también para buscar por usuario y ordenar por fecha. Pero no sirve para buscar solo por fecha.
Por qué no indexar todo
Si los índices aceleran las lecturas, la tentación es ponerlos en todas las columnas. El costo aparece del otro lado: cada índice hay que actualizarlo en cada escritura.
Una tabla con ocho índices paga ocho actualizaciones extra por cada fila que insertas. En una tabla que se escribe mucho, eso convierte un problema de lectura en uno de escritura.
La regla práctica es indexar lo que aparece en los filtros y en los JOIN que de verdad ejecutas, no lo que podría hacer falta algún día.
Las migraciones son parte de la decisión
Hay una cosa que la comparación de motores no cubre y que pesa más en el día a día: cómo cambia el esquema con el tiempo.
Cuando trabajas con IA, los cambios de esquema llegan sueltos, como instrucciones aisladas: agrega esta columna, crea esta tabla. Aplicados a mano y sin registro, el resultado previsible es que la base de desarrollo y la de producción dejan de coincidir, y nadie sabe exactamente en qué se diferencian.
La solución no depende del motor: es llevar los cambios de esquema como archivos versionados en el repositorio, en orden, junto al código que los necesita.
migraciones/
  001_crear_usuarios.sql
  002_crear_pedidos.sql
  003_agregar_indice_pedidos_usuario.sql
  004_pedidos_agregar_estado.sql
Con eso, reconstruir la base desde cero es correr los archivos en orden, y la pregunta de qué diferencia hay entre dos entornos tiene una respuesta exacta en vez de una conjetura.
Dos detalles que ahorran incidentes. El primero es que una migración nunca debería borrar una columna en el mismo despliegue en que se deja de usar: primero se despliega el código que ya no la usa, después se elimina. El segundo es que agregar una columna obligatoria a una tabla con datos existentes falla, salvo que le des un valor por defecto o la agregues como opcional.
Ese segundo caso es exactamente el que rompe al desplegar y funciona perfecto en desarrollo, porque en desarrollo la tabla casi siempre está vacía.
Cuatro números que conviene conocer de tu propia base
Antes de preocuparse por límites teóricos, vale la pena saber dónde estás parado. Los cuatro se consultan en un minuto.
- Cuántas filas tiene tu tabla más grande. Marca si estás cerca del umbral donde los índices dejan de ser opcionales.
- Cuánto ocupa la base en disco. Si crece mucho más rápido que los datos, en PostgreSQL suele apuntar a la limpieza de versiones antiguas.
- Cuántas conexiones simultáneas abre tu aplicación. Los servidores gestionados suelen tener un tope bajo en los planes de entrada, y agotarlo produce errores que no parecen de base de datos.
- Cuánto tarda tu consulta más frecuente. No la más lenta: la que corre cientos de veces al día.
Ese último número es el que mejor predice cómo se va a comportar el sistema al crecer, y casi nadie lo mide.
Lo que cambia cuando el esquema lo diseña la IA
Hay un patrón que se repite en proyectos donde el modelo de datos se fue armando a base de prompts, y que no depende del motor elegido.
Todo termina siendo texto. Pedir una tabla para guardar pedidos suele devolver columnas de tipo texto para fechas, importes y estados, porque el texto siempre funciona y nunca da error al insertar. El costo llega después: no puedes ordenar por fecha de forma confiable, las sumas de importes fallan o pierden precisión, y nada impide guardar un estado que no existe.
Los importes merecen mención aparte. Guardar dinero en un tipo de coma flotante produce errores de redondeo que aparecen recién al sumar miles de registros, y entonces ya están en los datos. Para dinero se usa un tipo decimal exacto, o enteros en la unidad mínima.
Las relaciones quedan sin declarar. Es común recibir una columna usuario_id sin la clave foránea que la respalda. Funciona igual, hasta que alguien borra un usuario y quedan pedidos apuntando a nadie.
-- Tipos que dicen lo que son, y una relación declarada
CREATE TABLE pedidos (
    id          INTEGER PRIMARY KEY,
    usuario_id  INTEGER NOT NULL REFERENCES usuarios(id),
    total       DECIMAL(10,2) NOT NULL,   -- nunca float para dinero
    estado      TEXT NOT NULL CHECK (estado IN ('nuevo','pagado','enviado')),
    creado_en   TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP
);
Cada restricción de ahí es una clase de error que la base rechaza sola, sin depender de que todo el código de la aplicación se acuerde de validar. Y esa diferencia importa más cuando parte del código lo escribió un modelo en una conversación que ya se cerró.
Un detalle específico de SQLite: las claves foráneas existen pero vienen desactivadas por compatibilidad, y hay que habilitarlas en cada conexión con PRAGMA foreign_keys = ON. Muchos proyectos las declaran y nunca se aplican.
Por qué no usar siempre PostgreSQL
Porque para proyectos pequeños o embebidos, operar un servidor separado es complejidad que no necesitas. SQLite no es una versión inferior de una base de datos real: es la herramienta correcta para un problema distinto.
La pregunta útil no es cuál es mejor en abstracto, sino qué te cuesta cambiar de opinión más adelante. Y ahí la respuesta es tranquilizadora: si usas SQL estándar y evitas funciones específicas de un motor, migrar de SQLite a PostgreSQL es un trabajo acotado, muy lejos de la reescritura que la gente imagina.
Lo que sí encarece esa migración es haberse apoyado en extensiones propietarias o en tipos de datos que solo existen en un motor. Esa es la decisión que conviene tomar conscientemente, no cuál de los tres nombres elegir.