Este artículo es la segunda mitad de un tema que ya apareció antes en la guía. En el eje de seguridad vimos por qué hace falta limitar el ritmo de peticiones y qué abusos detiene. Aquí vemos cómo se cuenta y en qué capa se pone, que son las dos decisiones que deciden si funciona bajo carga real.
La distinción importa porque una implementación puede estar perfectamente justificada y ser inútil en producción, por elegir mal el algoritmo o el sitio donde vive el contador.
El problema de contar por minutos naturales
La forma intuitiva de limitar es contar cuántas peticiones lleva alguien en el minuto actual y reiniciar el contador al cambiar de minuto. Es la que sale sola al implementarlo a mano, y tiene un defecto conocido.
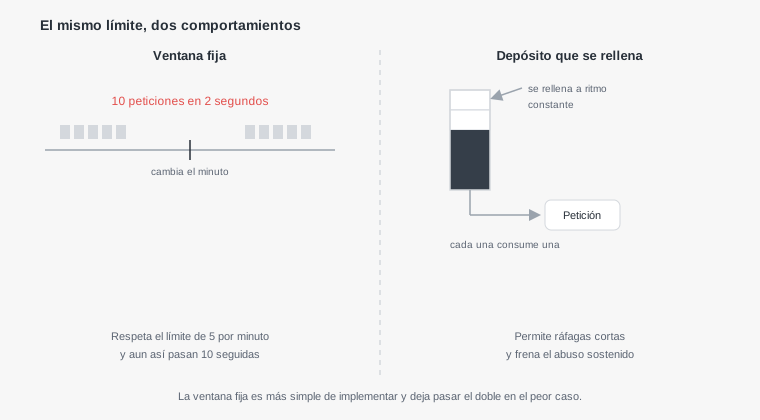
Si el límite es de cien por minuto, alguien puede hacer cien en el segundo 59 y cien más en el segundo 61. Doscientas en dos segundos, sin incumplir la regla en ningún momento.
Para un límite pensado contra el abuso ocasional eso puede dar igual. Para uno que protege un recurso caro, ese doble de golpe es exactamente el pico que se quería evitar.
Los cuatro algoritmos, y cuándo usar cada uno
Hay cuatro formas establecidas de contar, ordenadas de más simple a más precisa.
- Ventana fija. Un contador por periodo que se reinicia. Fácil de implementar, barato de almacenar, con el problema del doble en el cambio de ventana.
- Ventana deslizante. Cuenta lo ocurrido en los últimos sesenta segundos reales, no en el minuto natural. Elimina el problema anterior a costa de guardar marcas de tiempo, que ocupa más.
- Depósito de fichas. Un depósito con capacidad máxima que se rellena a ritmo constante; cada petición consume una ficha. Permite ráfagas cortas hasta la capacidad y luego impone el ritmo de relleno.
- Depósito con fugas. Las peticiones entran en una cola que se vacía a ritmo fijo. Suaviza la salida por completo, útil cuando lo que hay detrás no tolera picos.
Para la mayoría de los casos, el depósito de fichas es el que mejor equilibra: tolera el comportamiento normal de un usuario, que llega a ráfagas, y frena el abuso sostenido, que es lo que se quiere detener.
La ventana deslizante encaja cuando el límite es contractual y hay que poder justificarlo con precisión, por ejemplo en una API de pago donde el cliente reclama.
El depósito de fichas, implementado bien
La implementación ingenua lee el estado, calcula y escribe, y falla cuando dos peticiones llegan a la vez: ambas leen lo mismo y ambas pasan.
La forma correcta es que la operación sea atómica. Con un almacén en memoria, eso significa ejecutar la lógica del lado del servidor de datos, no en la aplicación.
# Redis: comprobar y consumir en una sola operación atómica
# KEYS[1] = clave del depósito   ARGV = capacidad, ritmo, ahora, coste
redis-cli --eval limite.lua usuario:412 , 20 0.5 $(date +%s) 1
-- limite.lua, ejecutado dentro de Redis: nadie se cuela entre el leer y el escribir
local capacidad = tonumber(ARGV[1])
local ritmo = tonumber(ARGV[2]) -- fichas por segundo
local ahora = tonumber(ARGV[3])
local coste = tonumber(ARGV[4])
local d = redis.call('HMGET', KEYS[1], 'fichas', 'visto')
local fichas = tonumber(d[1]) or capacidad
local visto = tonumber(d[2]) or ahora
-- rellenar segn el tiempo transcurrido, sin pasar de la capacidad
fichas = math.min(capacidad, fichas + (ahora - visto) * ritmo)
if fichas < coste then
return {0, math.ceil((coste - fichas) / ritmo)} -- denegado, segundos de espera
end
redis.call('HMSET', KEYS[1], 'fichas', fichas - coste, 'visto', ahora)
redis.call('EXPIRE', KEYS[1], math.ceil(capacidad / ritmo) * 2)
return {1, 0}Dos detalles que suelen faltar. El primero es la caducidad de la clave: sin ella, la memoria crece con cada usuario que pasa una sola vez. El segundo es devolver los segundos de espera, que es lo que permite responder correctamente.
El coste por operación, que es lo que más rinde
Un límite uniforme para toda la API trata igual una consulta trivial y una que genera un informe. Eso obliga a elegir entre ser demasiado estricto con lo barato o demasiado permisivo con lo caro.
La solución es que cada operación consuma un número distinto de fichas. Una lectura simple consume una; un informe pesado, veinte; un envío de correo, cincuenta.
Con eso, un mismo depósito por usuario protege el sistema entero de forma proporcional al daño que puede hacer cada llamada, y no hace falta mantener límites separados por endpoint.
Es además la forma natural de proteger el gasto en servicios externos: si una operación llama a un modelo de lenguaje que se cobra por uso, su coste en fichas debe reflejar ese precio.
En qué capa ponerlo
Hay tres sitios posibles y cada uno detiene el tráfico en un punto distinto del recorrido.
En la red de distribución o el proveedor. Es el más externo: el tráfico ni siquiera llega a tu infraestructura. Es lo único que sirve contra volúmenes grandes, porque frenarlos en tu servidor significa que ya pagaste por recibirlos.
En el servidor web o el proxy. Un punto intermedio muy eficiente, porque rechaza sin llegar a la aplicación. Nginx lo trae incorporado y se configura en unas líneas.
# nginx: una zona de 10 MB, 10 peticiones por segundo por dirección
limit_req_zone $binary_remote_addr zone=api:10m rate=10r/s;

server {
    location /api/ {
        limit_req zone=api burst=20 nodelay;
        limit_req_status 429;
    }
}
En la aplicación. Es el único sitio que conoce al usuario autenticado, el plan que tiene contratado y el coste de la operación. Es donde va la lógica fina, y también donde más caro resulta rechazar, porque la petición ya recorrió todo lo anterior.
La combinación sensata usa las tres: un límite amplio por dirección arriba, uno medio en el proxy, y el fino por usuario y operación en la aplicación. Cada capa protege a la siguiente.
Qué responder, exactamente
La respuesta está estandarizada y cumplirla decide si un cliente legítimo se recupera solo o entra en un bucle.
HTTP/1.1 429 Too Many Requests
Retry-After: 12
RateLimit-Limit: 100
RateLimit-Remaining: 0
RateLimit-Reset: 12
Content-Type: application/json

{"error":"rate_limited","mensaje":"Demasiadas peticiones. Reintenta en 12 segundos."}
La cabecera de espera es la importante: un cliente bien escrito la lee y reintenta después. Sin ella reintenta de inmediato y empeora la situación.
Informar del estado antes de llegar al tope, con el límite y lo que queda, permite que una integración se autorregule en lugar de descubrir el muro chocando contra él. Y conviene comprobarlo desde fuera, que es una línea:
# Lanzar 30 peticiones seguidas y ver los códigos de respuesta
for i in $(seq 1 30); do
  curl -s -o /dev/null -w '%{http_code} ' http://localhost:8080/api/pedidos
done; echo

# Ver las cabeceras de límite en una respuesta concreta
curl -sI http://localhost:8080/api/pedidos | grep -i 'ratelimit\|retry-after'
El contador compartido, que es donde falla en producción
Este punto merece énfasis porque produce una protección que parece existir y no existe.
Si el contador vive en la memoria del proceso y hay tres instancias detrás de un balanceador, cada una cuenta por su cuenta y el límite real es el triple del configurado. Con despliegues que crean y destruyen instancias, el número ni siquiera es estable.
El contador tiene que estar en un almacén común. Ese es uno de los usos más justificados de un almacén en memoria en un proyecto pequeño, por delante de la caché.
Y hay que decidir qué pasa si ese almacén no responde. Dejar pasar todo mantiene el servicio y desactiva la protección justo cuando hay problemas; rechazar todo protege y convierte una incidencia del contador en una caída. Para la mayoría de los casos, dejar pasar es la opción correcta, pero es una decisión que conviene tomar a conciencia y registrar cuando ocurra.
Límites distintos para clientes distintos
Un solo límite para todos obliga a elegir entre estorbar a los clientes grandes o dejar margen al abuso.
La forma habitual de resolverlo es asociar el límite al plan o al tipo de cliente, guardándolo con la cuenta. Un usuario anónimo tiene un límite bajo por dirección, uno autenticado uno mayor por cuenta, y una integración con contrato el que se acordó.
Conviene además poder subir el límite de un cliente concreto sin desplegar. Si el valor vive en la base de datos y no en el código, atender una petición legítima de más margen es cambiar un número.
Y conviene registrar cada rechazo con quién fue y en qué ruta. Al cabo de una semana, esos registros dicen si los que chocan son abusos reales o clientes normales con un umbral mal calibrado, que es la información que hace falta para ajustarlo.
Qué se le escapa a una IA con esto
Pedir un límite de peticiones produce, con mucha fiabilidad, un contador en memoria con ventana fija. Funciona en una máquina, deja pasar el doble en el cambio de ventana y desaparece al escalar a dos instancias.
Cuando se pide con almacén compartido, el error habitual es leer y escribir en operaciones separadas, lo que permite que dos peticiones simultáneas pasen ambas. La implementación parece correcta y falla justo bajo la carga que debía frenar.
Las frases que cambian la respuesta son pedir que el contador sea compartido entre instancias, que la comprobación y el consumo ocurran en una sola operación atómica, y que la respuesta incluya la cabecera con los segundos de espera.
Y conviene pedir siempre el comportamiento ante fallo del almacén, porque no se deduce solo y es la diferencia entre una protección que degrada con elegancia y una que convierte un problema menor en una caída completa.