Hay un síntoma que delata casi cualquier estrategia de pruebas mal planteada, y no tiene nada que ver con la cobertura: nadie ejecuta las pruebas antes de subir un cambio. Tardan veinte minutos, fallan de vez en cuando sin motivo aparente, y la gente ha aprendido a ignorarlas.
Cuando eso ocurre, las pruebas existen pero ya no protegen nada. Y la causa, casi siempre, es la misma: se escribieron muchas pruebas del tipo equivocado.
Tres tipos de prueba, tres preguntas distintas
La clasificación clásica separa las pruebas según cuánto del sistema involucran, y cada nivel responde una pregunta diferente.
Las unitarias comprueban una pieza aislada: una función, una clase, un cálculo. Responden a si esta lógica hace lo que debe con estos datos.
Las de integración comprueban varias piezas juntas, normalmente con la base de datos real o algún servicio auxiliar. Responden a si estas partes funcionan cuando se conectan.
Las de extremo a extremo recorren el sistema completo como lo haría un usuario, abriendo un navegador y pulsando botones. Responden a si el flujo entero funciona.
Ninguna sustituye a las otras. Una unitaria no detecta que la consulta a la base está mal escrita, y una de extremo a extremo que falla no dice qué función concreta tiene el problema.
La forma de pirámide
La recomendación que se repite desde hace años es mantener una proporción: muchas de las primeras, algunas de las segundas y pocas de las terceras.
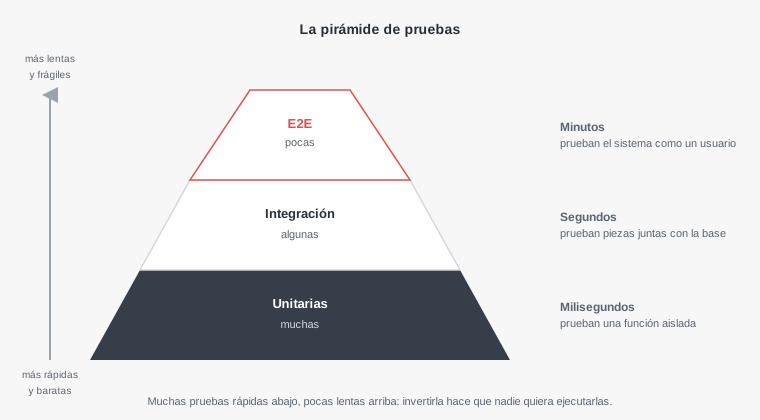
La razón de la forma no es teórica sino económica. Una prueba unitaria tarda milisegundos, falla por un motivo concreto y no depende de nada externo. Una de extremo a extremo tarda segundos o minutos, depende de que el navegador, la red, la base y los servicios estén todos en su sitio, y cuando falla no siempre es por un error real.
Con mil unitarias, la batería entera corre en unos segundos y se puede ejecutar antes de cada cambio. Con mil de extremo a extremo, tarda horas y nadie la ejecuta.
Por qué se invierte la pirámide
El problema más común no es tener pocas pruebas, es tener la proporción al revés, y ocurre por una razón comprensible.
Las pruebas de extremo a extremo son las que más se parecen a lo que uno quiere asegurar: que el usuario puede comprar, registrarse o pagar. Escribir una prueba que abre la tienda y completa una compra da una sensación de protección que una prueba sobre una función de cálculo no da.
Además, en código difícil de probar por partes, porque todo está mezclado, la única forma de probar algo es desde fuera. El código enredado empuja hacia las pruebas lentas.
El resultado es la forma de cucurucho de helado: muchas pruebas lentas arriba, casi ninguna rápida abajo, y una batería que tarda tanto y falla tan a menudo que acaba desactivada.
Las pruebas intermitentes, que destruyen la confianza
Una prueba que falla a veces sin que el código haya cambiado es peor que no tener prueba, y conviene entender por qué.
La primera vez que falla, alguien investiga. La tercera, alguien pulsa reintentar. A partir de la décima, un fallo real se trata igual que uno falso, y la prueba deja de avisar de nada.
Las causas habituales son pocas y conocidas: esperar un tiempo fijo en lugar de esperar a que algo ocurra, depender del orden en que se ejecutan las pruebas, compartir datos entre ellas, o depender de la hora o de un servicio externo.
# Detectar pruebas que dependen del orden: ejecutarlas en orden aleatorio
npx jest --randomize                      # JavaScript con Jest
pytest -p random_order --random-order     # Python con pytest-random-order
vendor/bin/phpunit --order-by=random      # PHP con PHPUnit

# Repetir una prueba sospechosa muchas veces para ver si falla a veces
for i in $(seq 1 50); do npx jest ruta/prueba.test.js --silent || echo "falló en $i"; done
La regla que funciona es tratar una prueba intermitente como un error urgente: se arregla o se elimina, pero no se deja reintentando. Mantenerla envenena la confianza en todas las demás.
Qué merece una prueba unitaria
No todo el código necesita pruebas unitarias, y escribirlas para todo produce una batería enorme que hay que mantener sin proteger mucho.
Donde más rinden es en la lógica con decisiones: cálculos de precios, impuestos y descuentos, reglas de validación, transformaciones de datos, cualquier cosa con condiciones y casos límite. Ahí una prueba documenta el comportamiento esperado y detecta regresiones al instante.
Donde rinden poco es en el código que solo pasa datos de un sitio a otro sin decidir nada: un controlador que recibe una petición y llama a un servicio, o un repositorio que ejecuta una consulta. Probarlos de forma aislada exige simular todo lo que tocan, y la prueba acaba comprobando que la simulación funciona.
Esa segunda categoría se prueba mejor con pruebas de integración, que usan las piezas reales.
Integración: la capa que más se descuida
Si hay un nivel donde la mayoría de los proyectos pequeños sale ganando al invertir más, es este.
Una prueba de integración que levanta la aplicación con una base de datos de verdad y hace una petición a un endpoint comprueba de una vez la ruta, la validación, la lógica, la consulta y la respuesta. Es mucho más barata que una de extremo a extremo y mucho más realista que una unitaria con todo simulado.
El obstáculo tradicional era preparar la base de datos, y hoy tiene solución sencilla: una base efímera en un contenedor que se crea al empezar y se descarta al terminar.
# Una base de datos desechable solo para las pruebas
docker run --rm -d --name pg-pruebas -e POSTGRES_PASSWORD=prueba \
  -p 55432:5432 postgres:16

# Ejecutar las pruebas de integración contra ella
DATABASE_URL=postgres://postgres:prueba@localhost:55432/postgres npm run test:integracion

# Descartarla al terminar
docker stop pg-pruebas
Conviene que cada prueba empiece con los datos limpios, dentro de una transacción que se deshace al acabar. Así el orden deja de importar y las pruebas no se contaminan entre sí.
Cuántas de extremo a extremo tener
La respuesta práctica es: tantas como flujos críticos tenga el negocio, y ni una más.
Un flujo crítico es aquel cuyo fallo en producción cuesta dinero o clientes de forma inmediata: registrarse, iniciar sesión, completar una compra, el proceso central que justifica que la aplicación exista. Para una tienda, eso son tres o cuatro recorridos.
Todo lo demás, como la validación de un campo concreto o el comportamiento de un filtro, se comprueba mejor en capas inferiores. Una prueba de extremo a extremo por cada detalle de la interfaz es exactamente lo que convierte la batería en algo que tarda una hora.
Y conviene que esas pocas pruebas sean robustas: que busquen los elementos por su función o su texto, no por su posición en la página, porque un cambio de diseño no debería romperlas.
Medir la batería, no solo la cobertura
Hay dos números que dicen más sobre la salud de las pruebas que el porcentaje de cobertura, y casi nadie los mira.
El primero es cuánto tarda la batería completa. Si pasa de unos pocos minutos, la gente deja de ejecutarla en local, y las pruebas solo corren en la integración continua, después de haber subido el cambio.
El segundo es cuántas veces falló sin que hubiera un error real en el último mes. Si es más de una o dos, hay pruebas intermitentes que están erosionando la confianza.
# Las diez pruebas más lentas, para saber dónde se va el tiempo
npx jest --verbose 2>&1 | grep -E '\([0-9]+ ms\)' | sort -t'(' -k2 -nr | head -10
pytest --durations=10
vendor/bin/phpunit --log-junit informe.xml   # los tiempos por prueba quedan en el informe
Casi siempre, unas pocas pruebas concentran la mayor parte del tiempo. Convertirlas en pruebas de un nivel inferior suele reducir la batería a una fracción sin perder protección.
La pirámide no es una ley
Conviene matizar, porque la proporción clásica se formuló pensando en cierto tipo de aplicación y no encaja igual en todas.
En una aplicación cuyo valor está casi entero en la interfaz, con poca lógica propia en el servidor, tiene sentido dar más peso a las pruebas de componentes y de integración que a las unitarias. En un servicio que es sobre todo cálculo, la base unitaria puede ser todavía más ancha.
Por eso algunas propuestas recientes dibujan otras formas, con la capa de integración como la más gruesa. La idea de fondo sigue siendo la misma y es lo que conviene quedarse: poner la mayor parte del esfuerzo donde la prueba es rápida, fiable y dice algo útil cuando falla.
Qué se le escapa a una IA con esto
Pedir pruebas para una aplicación produce, con frecuencia, una batería desequilibrada en una de dos direcciones.
La primera es un exceso de unitarias con todo simulado, que prueban que las funciones llaman a sus dependencias en lugar de comprobar resultados. Pasan siempre, dan una cobertura alta y no detectan casi nada, porque la simulación reproduce lo que el código ya hacía.
La segunda es un conjunto de pruebas de extremo a extremo para cada pantalla, con esperas de tiempo fijo, que funcionan en local y fallan de forma intermitente en la integración continua.
Las frases que cambian la respuesta son pedir que las pruebas comprueben resultados y no llamadas, que las de integración usen una base real, y que no haya esperas de tiempo fijo. Y conviene preguntar explícitamente qué error concreto detectaría cada prueba: si la respuesta es vaga, la prueba probablemente no protege nada.