El despliegue funcionó. La aplicación arrancó sin errores. Y durante los cuarenta segundos que tardó en propagarse, una parte de los usuarios recibió pantallas en blanco, porque el código nuevo buscaba una columna que el código viejo acababa de eliminar.
Ese tipo de incidente no viene de un error de programación. Viene de haber tratado el cambio de esquema y el cambio de código como si fueran una sola operación, cuando en realidad ocurren en momentos distintos y conviven durante un rato.
Este artículo trata de cómo se cambia la forma de los datos mientras el sistema sigue atendiendo peticiones, que es la situación normal en cualquier proyecto con usuarios reales.
Por qué el problema aparece aunque todo esté bien escrito
Durante un despliegue hay un intervalo en el que conviven dos versiones del código. Puede durar segundos o minutos, según cómo se despliegue, pero siempre existe.
Si en ese intervalo el esquema ya cambió, la versión antigua se encuentra con una base que no reconoce. Si el esquema todavía no cambió, la versión nueva se encuentra con lo contrario. Alguna de las dos va a fallar, salvo que el cambio esté diseñado para que las dos puedan convivir.
Esa es la idea central y conviene enunciarla con claridad: un cambio de esquema seguro es uno que funciona tanto con el código viejo como con el nuevo. Mientras esa condición se cumpla, no importa el orden ni el momento.
Cuando no se cumple, el único modo de evitar errores es detener el servicio durante la operación, que es exactamente lo que se busca evitar.
Los cambios que son seguros y los que no
No todos los cambios tienen el mismo riesgo, y distinguirlos ahorra mucho trabajo, porque la mayoría de las modificaciones diarias son de las inofensivas.
Son seguros los que añaden algo que nadie está obligado a usar: una tabla nueva, una columna opcional, un índice. El código viejo los ignora por completo y sigue funcionando igual.
Son peligrosos los que quitan o transforman algo que alguien podría estar usando: eliminar una columna, renombrarla, cambiar su tipo o añadirla como obligatoria. En todos esos casos hay una versión del código que deja de encontrar lo que espera.
Hay uno que engaña y merece mención aparte: renombrar. Parece un cambio menor y en la práctica equivale a eliminar y crear a la vez, que es la combinación más destructiva. Por eso la recomendación estándar es no renombrar nunca en un solo paso.
El patrón que resuelve todos los casos difíciles
La técnica se conoce como expandir y contraer, y consiste en convertir un cambio arriesgado en una secuencia de cambios seguros separados en el tiempo.
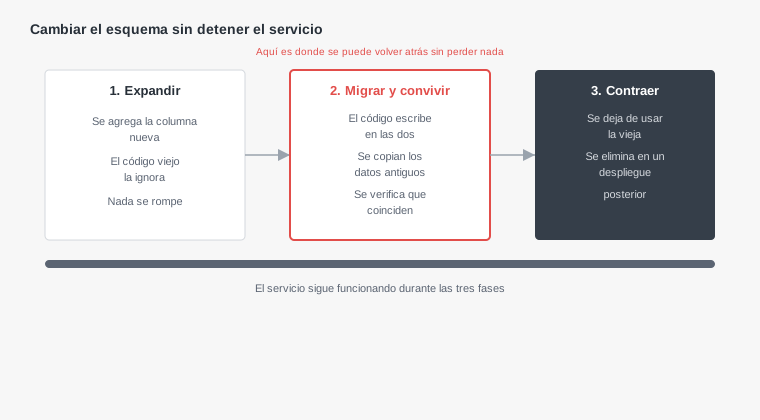
La primera fase añade lo nuevo sin tocar lo viejo. Como solo agrega, es segura por definición y puede desplegarse en cualquier momento.
La segunda es la que lleva tiempo: el código escribe en los dos sitios, se copian los datos históricos por lotes y se verifica que coinciden. Durante esta fase el sistema funciona con normalidad y, si algo sale mal, se puede volver atrás sin haber perdido nada, porque el dato original sigue intacto.
La tercera elimina lo que ya nadie usa. Y es importante que ocurra en un despliegue posterior, no en el mismo: solo cuando todas las instancias ejecuten código que no menciona la columna vieja se puede borrar con seguridad.
Se crea la columna con el nombre nuevo. Se despliega código que escribe en las dos y lee de la vieja. Se copian los datos existentes. Se despliega código que lee de la nueva. Y en un despliegue posterior se elimina la vieja.
Son cinco pasos para algo que parecía uno, y cada uno se puede revertir por separado sin consecuencias.
Las migraciones que bloquean la tabla
Hay una segunda causa de caídas que sorprende incluso a quien aplica bien el patrón anterior: la operación en sí misma detiene la tabla mientras se ejecuta.
Con pocos registros no se nota. Sobre una tabla grande, ciertas operaciones toman un bloqueo que impide leer o escribir durante todo el proceso, y desde fuera eso es indistinguible de una caída. La aplicación no da error de despliegue: simplemente se queda esperando.
Las que más problemas causan son añadir una columna con valor por defecto en motores antiguos, cambiar el tipo de una columna existente y crear un índice sobre una tabla con mucho tráfico.
Esta última tiene una solución directa que conviene conocer, porque el índice se puede construir sin bloquear la tabla, a cambio de tardar más:
-- Bloquea la tabla mientras construye el índice
CREATE INDEX idx_pedidos_cliente ON pedidos (cliente_id);

-- No bloquea: la tabla sigue aceptando lecturas y escrituras
CREATE INDEX CONCURRENTLY idx_pedidos_cliente ON pedidos (cliente_id);
Conviene además fijar un tiempo máximo de espera para el bloqueo antes de ejecutar una migración. Así, si la operación no puede obtenerlo enseguida, falla rápido en lugar de dejar la tabla bloqueada y las peticiones acumulándose detrás.
Por qué las migraciones deben vivir en el repositorio
Cuando los cambios de esquema se aplican a mano, con instrucciones sueltas copiadas de una conversación, el resultado previsible es que los entornos dejan de coincidir y nadie sabe exactamente en qué se diferencian.
La alternativa es tratarlos como código: archivos numerados, en orden, guardados junto a la aplicación que los necesita.
migraciones/
  001_crear_usuarios.sql
  002_crear_pedidos.sql
  003_agregar_indice_pedidos_cliente.sql
  004_pedidos_agregar_estado.sql
Con eso, reconstruir la base desde cero es ejecutar los archivos en orden, y la pregunta de qué diferencia hay entre desarrollo y producción tiene una respuesta exacta en vez de una conjetura.
Esta práctica importa especialmente cuando parte del código lo escribe una IA, porque los cambios de esquema llegan como instrucciones aisladas: agrega esta columna, crea esta tabla. Sin un sitio donde queden registrados en orden, se pierden en el historial de la conversación.
El caso que rompe en producción y funciona en desarrollo
Hay un error tan frecuente que merece su propia sección, porque tiene una explicación que lo hace evitable para siempre.
Añadir una columna obligatoria a una tabla que ya tiene datos falla, porque las filas existentes no tienen valor para ella. En desarrollo casi nunca falla, ya que la tabla suele estar vacía o casi.
La forma correcta son tres pasos: añadirla como opcional, rellenar los datos existentes y solo entonces hacerla obligatoria. Cada paso es seguro por separado y el conjunto no necesita detener nada.
La lección general va más allá de este caso: una migración probada solo contra una base vacía no está probada. Conviene ensayarla sobre una copia reciente de los datos reales, que además revela cuánto va a tardar.
Qué hacer antes de ejecutar una migración
Una lista corta, de las que se repasan en dos minutos y evitan la mayoría de los incidentes.
- Haz una copia y comprueba que existe. No que esté programada: que haya terminado hace un rato.
- Ensáyala sobre una copia de los datos reales. Dice si funciona y cuánto tarda, que es el dato que decide si se puede hacer en horario normal.
- Comprueba que es reversible. Si no lo es, que al menos sea de las que solo añaden, para que volver atrás signifique desplegar el código anterior.
- Revisa que el código viejo sobreviva al cambio. Es la condición de convivencia, y la que evita el fallo de los cuarenta segundos.
- Elige el momento con criterio. Una migración larga sobre una tabla grande no se lanza en el pico de tráfico, aunque no bloquee.
Ninguno de estos pasos es sofisticado, y su ausencia explica casi todos los incidentes de esquema que acaban en una restauración de urgencia.
Migrar los datos, no solo la estructura
Cambiar la forma de una tabla es la mitad del trabajo. La otra mitad, la que suele tardar más, es mover los datos que ya existen para que encajen en la forma nueva.
La tentación es hacerlo con una sola instrucción que actualice todas las filas de una vez. Sobre una tabla pequeña funciona bien. Sobre una tabla grande, esa única instrucción mantiene una transacción abierta durante minutos, bloquea filas que la aplicación necesita y puede agotar el espacio de registro del motor.
La forma que funciona es procesar por lotes: actualizar unos miles de filas, confirmar, esperar un instante y seguir. Tarda más en total y no interrumpe a nadie, que es exactamente el intercambio que se busca.
-- En vez de una sola actualización sobre millones de filas,
-- se avanza por lotes hasta que no queda ninguna pendiente
UPDATE pedidos
   SET moneda = 'EUR'
 WHERE moneda IS NULL
   AND id IN (SELECT id FROM pedidos WHERE moneda IS NULL LIMIT 5000);
Conviene además que el proceso sea repetible: si se interrumpe a la mitad, volver a lanzarlo debe continuar donde quedó en lugar de empezar de cero o duplicar trabajo. La condición del WHERE es lo que da esa propiedad, porque las filas ya migradas dejan de cumplirla.
Y hay que verificar al final, no asumir. Contar cuántas filas quedan sin migrar es una consulta de un segundo que distingue entre un proceso terminado y uno que se detuvo sin avisar.
Cuando la migración ya salió mal
Si el cambio se aplicó y algo se rompió, el orden de las decisiones importa más que la velocidad, porque varios errores habituales ocurren en los primeros minutos.
- Vuelve al código anterior antes que a los datos. Si la migración solo añadía cosas, desplegar la versión previa de la aplicación suele restaurar el servicio sin tocar la base.
- No restaures encima de la base actual. Restaura a un sitio aparte y compara. Sobrescribir destruye la evidencia y, si la copia estaba mal, no queda nada.
- Cuenta lo que se perdió antes de decidir. Saber cuántas filas están afectadas convierte una decisión angustiosa en una comparación entre opciones concretas.
- Anota la hora de cada paso. Durante el incidente parece perder tiempo, y después es lo único que permite entender qué pasó.
La conclusión práctica de todo esto es que conviene desplegar los cambios de esquema por separado de los cambios de funcionalidad. Cuando van juntos y algo falla, no hay forma de saber cuál de los dos lo causó, y volver atrás implica revertir ambos.
Qué se le escapa a una IA con esto
Pedir un cambio de esquema produce, casi siempre, la instrucción correcta para el resultado final y ninguna consideración sobre cómo llegar hasta él sin romper nada por el camino.
La razón es que el modelo no sabe si esa tabla tiene diez filas o diez millones, ni cuántas versiones del código van a convivir durante el despliegue, ni qué otras partes del sistema leen esa columna. Responde a lo que se le preguntó, que era cómo queda la tabla al final.
La frase que cambia la respuesta es pedir el plan en fases: decir que el sistema está en producción, que no puede detenerse y que hay que poder volver atrás en cada paso. Con eso, en lugar de una instrucción aparece una secuencia.
Y conviene pedir siempre la operación inversa junto con la directa. Escribir cómo se deshace un cambio en el momento de diseñarlo cuesta un minuto; averiguarlo con el sistema caído cuesta bastante más.