La pregunta suele aparecer tarde, cuando alguien de fuera la formula: un cliente que pide garantías sobre la titularidad de lo que le entregas, un inversor que revisa qué se está comprando, o un contrato que exige declarar que el código es tuyo y no infringe derechos de nadie.
La respuesta honesta es que no hay una única, porque depende de la jurisdicción, de cuánto aportó una persona y de lo que diga el contrato con el proveedor del modelo. Lo que sí se puede hacer es entender las tres piezas que componen el problema y qué parte de él está bajo tu control.
Esto no es asesoramiento legal. Es el mapa para saber qué preguntar y qué dejar registrado por si hace falta.
Tres preguntas que se confunden en una
La mayor parte de la confusión viene de mezclar cuestiones distintas bajo el mismo título.
La primera es si el código generado está protegido por derecho de autor. Es una pregunta sobre la naturaleza de la obra.
La segunda es quién es el titular de esa protección, si existe: tú, tu empresa, el proveedor del modelo.
La tercera es si ese código infringe derechos de otros, por reproducir material con el que se entrenó el modelo. Es una pregunta completamente independiente de las dos anteriores.
Se pueden dar todas las combinaciones. Un fragmento puede no estar protegido y aun así infringir. Puede estar protegido y ser tuyo y aun así infringir. Tratarlas por separado es lo que permite avanzar.
Lo que protege el derecho de autor y lo que no
La protección requiere, en los ordenamientos que tratan esto, una obra con aportación intelectual humana. Ese requisito es el eje de todo lo demás.
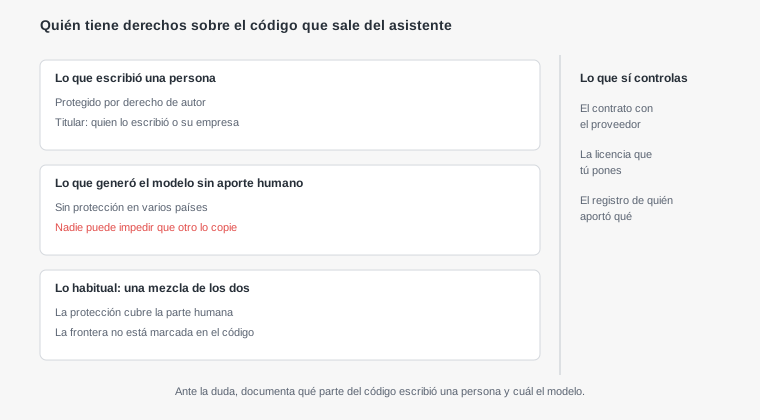
La Oficina de Derechos de Autor de Estados Unidos ha sostenido que el material generado exclusivamente por una máquina, sin aportación creativa humana, no es registrable. Cuando hay obra con partes humanas y partes generadas, la protección alcanza a la contribución humana y a la selección y disposición del conjunto.
En Europa el criterio jurisprudencial es que la obra debe ser una creación intelectual propia de su autor, lo que apunta en la misma dirección aunque no haya una doctrina cerrada específica para código generado.
Hay ordenamientos que se apartan de esto. El Reino Unido tiene desde hace décadas una figura para obras generadas por ordenador que atribuye la autoría a quien dispuso lo necesario para su creación, con un plazo de protección más corto.
La consecuencia práctica más relevante: si una parte de tu código no está protegida, no puedes impedir que alguien la copie. No es que sea de otro, es que no es de nadie.
Cuánto aporte humano hace falta
La pregunta que sigue de forma natural es dónde está el umbral, y la respuesta es que depende de cómo se trabajó.
Escribir un encargo breve y aceptar lo que salga es el extremo donde el aporte es más discutible, porque describir lo que quieres no es lo mismo que expresarlo.
En el otro extremo está el trabajo real de la mayoría: decides la arquitectura, defines las estructuras de datos, encargas piezas, las revisas, las corriges, las integras y las ajustas. Ahí hay selección, disposición y modificación humana en abundancia.
Ese segundo caso es el habitual, y es la razón por la que la preocupación suele ser menor de lo que la pregunta sugiere. La discusión afecta a fragmentos concretos generados de un tirón, no al producto entero.
Lo que sí conviene es no encontrarte sin forma de demostrarlo. El historial del trabajo, con commits pequeños que muestran las decisiones y las correcciones, es la evidencia más natural de aporte humano, y ya la estás produciendo si trabajas con commits pequeños.
Lo que dicen los contratos de los proveedores
Aquí sí hay respuestas concretas, y conviene leerlas porque son la parte del problema que está escrita.
Los proveedores principales de asistentes de código ceden al usuario los derechos que puedan tener sobre la salida, y no reclaman titularidad. Es decir, por el lado del proveedor no hay reclamación: lo que salga es tuyo en la medida en que algo pueda serlo.
Varios ofrecen además una indemnización por reclamaciones de terceros por derechos de autor sobre la salida, condicionada a que uses ciertos ajustes, como los filtros que bloquean sugerencias que coinciden con código público conocido.
Esas condiciones son lo que hay que comprobar, porque la protección se pierde si no se cumplen. Y varían entre el plan gratuito y el de empresa del mismo producto.
Lo que ningún contrato resuelve es la primera pregunta: si la salida es protegible. Un proveedor puede cederte todos sus derechos y aun así no haber ningún derecho que ceder.
El riesgo que sí es concreto: reproducir código ajeno
De las tres preguntas, esta es la que tiene consecuencias más inmediatas y la que se puede reducir con medidas técnicas.
Un modelo puede reproducir fragmentos que vio durante el entrenamiento, y la probabilidad sube con lo específico y conocido que sea el fragmento. Una implementación canónica de un algoritmo con nombre propio es el caso típico.
Si ese fragmento venía de un proyecto con licencia copyleft y acaba en tu producto, la obligación de esa licencia te alcanza, con independencia de cómo llegó. La ignorancia del origen no es una defensa.
Las medidas que reducen esto son pocas y baratas. Activar el filtro de coincidencia con código público donde exista. Revisar con atención el código que tenga aspecto de implementación conocida. Y mantener el inventario de licencias al día.
# Buscar si un fragmento distintivo aparece en repositorios publicos
gh search code "linea muy caracteristica del fragmento" --limit 10

# Detectar bloques largos identicos dentro del propio proyecto
npx jscpd src/ --min-lines 20 --reporters console
Para el grueso del código generado, que es específico de tu dominio, el riesgo es bajo. Conviene concentrar el esfuerzo en lo que parezca sacado de un libro de texto.
Lo que declaras cuando firmas un contrato
El punto donde esto deja de ser teórico es el contrato de desarrollo, y es útil leer con atención una cláusula que aparece siempre.
Los contratos suelen incluir una declaración de que el proveedor es titular de lo que entrega y de que no infringe derechos de terceros. Firmar eso cuando una parte del código salió de un asistente merece una conversación previa, no una firma automática.
Hay dos salidas habituales. Una es acotar la declaración a lo que razonablemente puedes saber, con las comprobaciones que efectivamente haces. La otra es declarar el uso de herramientas asistidas y las medidas que aplicas.
La tendencia en los contratos recientes es incluir cláusulas específicas sobre el uso de asistentes, a veces prohibiéndolo para determinados componentes. Conviene leerlas antes y no después de haber desarrollado.
Y hay un caso que merece atención especial: si el cliente exige exclusividad sobre el código, la parte no protegible es exactamente la que no puedes garantizarle en exclusiva.
Qué registrar por si acaso
La mayor parte de las preguntas incómodas se responden bien si hay rastro, y el rastro se produce casi solo si el trabajo está organizado.
Los commits pequeños y frecuentes muestran la secuencia de decisiones humanas mejor que cualquier declaración posterior. Un único commit de cuatro mil líneas no muestra nada.
Las especificaciones y las notas de diseño en el repositorio documentan el aporte intelectual que precede al código, que es justamente lo que está en discusión.
Y para los componentes donde la titularidad importe de verdad, dejar constancia explícita en el propio repositorio de cómo se desarrollaron.
# Dejar constancia en el historial cuando importe
git commit -m "importador de facturas: diseno y validaciones propias,
implementacion del parser asistida y revisada" --trailer "Assisted-by: herramienta"

# Ver la evolucion real de un componente concreto
git log --follow --stat src/importador/
Nada de esto es obligatorio hoy, y es barato si el equipo ya trabaja así. La alternativa es reconstruirlo dos años después desde la memoria de quien siga en la empresa.
Lo que está por decidirse
Conviene tener presente que este terreno se está moviendo, para no tomar decisiones definitivas sobre algo provisional.
Hay litigios abiertos sobre si el entrenamiento con material protegido constituye infracción, con resoluciones parciales y sin criterio unificado. El resultado afectará más a los proveedores que a quien usa las herramientas, pero puede cambiar las condiciones de uso.
En Europa, el reglamento de inteligencia artificial introduce obligaciones de transparencia sobre los datos de entrenamiento, con calendario escalonado. Eso no resuelve la titularidad, pero da información que hoy no existe.
Y las oficinas de registro van publicando criterios sobre qué aceptan registrar y con qué requisitos de declaración de la parte generada.
La postura sensata mientras tanto es no construir el modelo de negocio sobre la exclusividad de código generado sin revisar, y mantener el rastro de lo que aportó cada quién.
El resumen práctico
Para un equipo que trabaja con asistentes y quiere estar razonablemente tranquilo:
Asume que el producto en conjunto, con tu arquitectura, tus decisiones y tus correcciones, tiene aporte humano suficiente. Asume que fragmentos aislados generados de un tirón pueden no estar protegidos, y no construyas nada crítico sobre su exclusividad. Comprueba el contrato de tu proveedor y activa los filtros que condicionan su indemnización. Trata el riesgo de reproducción como lo que es, un problema de licencias que ya sabes gestionar. Y deja rastro del trabajo, que es gratis si ya haces commits pequeños.
Con eso cubierto, lo que queda es lo que ningún equipo puede resolver por su cuenta, y para eso está el especialista el día que haya un contrato importante encima de la mesa.
Qué se le escapa a una IA con esto
Preguntarle a un asistente de quién es el código que él mismo escribió tiene un problema evidente y varios menos visibles.
Responde con seguridad sobre un terreno que no está cerrado. Produce una respuesta redonda donde los tribunales y las oficinas de registro todavía están fijando criterio, y esa seguridad es lo más engañoso de la respuesta.
Mezcla jurisdicciones sin avisar. El criterio de la oficina estadounidense, la doctrina europea y la figura británica de obra generada por ordenador son distintos, y una respuesta genérica los funde en uno inexistente.
Su información sobre los términos de servicio de los proveedores puede estar desfasada, y son precisamente documentos que cambian a menudo. La cláusula de indemnización de hace un año puede no ser la vigente.
Y no puede saber cuánto aportaste tú, que es la variable que decide. Esa parte la tiene que responder el rastro de tu trabajo, no el modelo.
Donde sí ayuda es en lo concreto y verificable: explicarte qué dice una cláusula que tienes delante, prepararte la lista de preguntas para un abogado, o escribir los comandos que comprueban si un fragmento aparece en repositorios públicos.