La frase más cara de un incidente es no sé por qué falló. No porque el fallo sea grave, sino porque cada hora que pasa sin entenderlo es una hora de caída, de clientes afectados y de gente probando cambios a ciegas con la esperanza de que alguno funcione.
Esa frase aparece casi siempre en sistemas que tienen registros y no tienen nada más. Los registros explican bien un evento concreto, y responden mal a las dos preguntas que se hacen primero en un incidente: cuánto está pasando y dónde se está yendo el tiempo.
Tres herramientas, tres preguntas
Lo que se suele llamar observabilidad se apoya en tres tipos de señal, y cada una responde una pregunta distinta. Confundirlas lleva a usar una para lo que hace mal otra.
Las métricas son números medidos de forma continua: peticiones por segundo, porcentaje de errores, tiempo de respuesta, uso de memoria. Responden a cuánto y a desde cuándo, y son baratas de guardar aunque haya mucho tráfico.
Los registros describen eventos concretos con detalle. Responden a qué pasó exactamente en un caso, y son caros cuando se usan para contar.
Las trazas siguen una petición a través de todas las piezas que toca. Responden a dónde se fue el tiempo o dónde falló, cuando una petición pasa por varios servicios.
El flujo típico de un diagnóstico las usa en orden: una métrica avisa de que algo va mal, una traza señala en qué pieza, y los registros de esa pieza explican por qué.
Las cuatro métricas que conviene tener siempre
Hay un conjunto pequeño que cubre la mayor parte de lo que importa en un servicio que atiende peticiones, y conviene empezar por ahí antes de medir cualquier otra cosa.
- Tráfico: cuántas peticiones llegan por segundo. Sin esta cifra no se puede saber si un pico de errores es un problema o simplemente más volumen.
- Errores: qué porcentaje de las peticiones falla. El porcentaje importa más que el número absoluto, por la misma razón.
- Latencia: cuánto tardan las respuestas, medido por percentiles y no por media.
- Saturación: cuán cerca del límite está el recurso más escaso, sea la memoria, las conexiones a la base o la cola de tareas.
Con estas cuatro, un panel responde de un vistazo a la pregunta que todo el mundo hace al empezar un incidente: está pasando algo, y desde cuándo.
Por qué la media miente
Este punto merece sección propia porque es el error de medición más extendido, y lleva a conclusiones equivocadas con total confianza.
Si noventa y nueve peticiones tardan cien milisegundos y una tarda diez segundos, la media es doscientos milisegundos. Parece un servicio rápido, y hay un usuario de cada cien esperando diez segundos.
Los percentiles resuelven eso. El percentil 50 es el tiempo que no supera la mitad de las peticiones. El 95 es el que no supera el 95 por ciento. El 99 muestra lo que viven los usuarios peor atendidos.
En la práctica, conviene vigilar el 95 o el 99, porque es donde aparecen los problemas reales: una consulta que a veces no usa índice, un servicio externo que de vez en cuando tarda, una recolección de memoria que pausa. En la media, todo eso desaparece.
# Percentiles de tiempo de respuesta a partir de registros estructurados
jq -r 'select(.duracion_ms) | .duracion_ms' app.log | sort -n \
  | awk '{a[NR]=$1} END {print "p50:",a[int(NR*0.5)],"p95:",a[int(NR*0.95)],"p99:",a[int(NR*0.99)]}'
Exponer métricas sin montar una plataforma
El formato más extendido para exponer métricas es un texto plano que el propio servicio publica en una dirección, y que un recolector lee cada pocos segundos.
# Lo que devuelve un servicio instrumentado en su endpoint de métricas
curl -s http://localhost:8080/metrics | grep -E '^http_'

# http_requests_total{ruta="/pedidos",codigo="200"} 18423
# http_requests_total{ruta="/pedidos",codigo="500"} 12
# http_request_duration_seconds_bucket{ruta="/pedidos",le="0.1"} 17960
# http_request_duration_seconds_bucket{ruta="/pedidos",le="0.5"} 18390
Casi todos los lenguajes tienen librerías que generan eso con pocas líneas, y hay un sistema de monitoreo de código abierto que lo recoge, lo guarda y permite consultarlo. Para un proyecto pequeño, un recolector y un panel en la misma máquina bastan.
Hay un detalle que evita el problema más común de este formato: las etiquetas no pueden tener valores ilimitados. Poner el identificador de usuario o la dirección completa con parámetros como etiqueta crea una serie distinta por cada valor, y con miles de usuarios la base de métricas se colapsa. Las etiquetas son para categorías pequeñas: la ruta sin parámetros, el código de estado, el método.
Dónde se va el tiempo de una petición
Las métricas dicen que las respuestas se volvieron lentas. No dicen por qué, y en un sistema con varias piezas esa es la pregunta difícil.
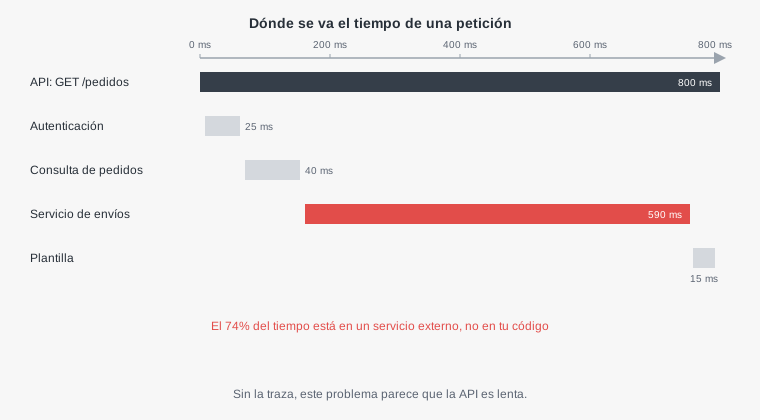
Una traza es exactamente eso: el desglose de una petición en tramos, cada uno con su inicio, su duración y la pieza que lo ejecutó. Al dibujarla en cascada, el cuello de botella se ve sin necesidad de interpretar nada.
En el ejemplo, sin traza, el diagnóstico natural sería que la API es lenta, y se optimizaría el código propio, que representa una fracción mínima del tiempo. Con la traza, el problema es un servicio externo, y la solución es otra: cachear su respuesta, llamarlo en paralelo o llamarlo fuera de la petición.
Cómo funciona el trazado distribuido
El mecanismo es sencillo y se apoya en algo que ya vimos con los registros: un identificador que viaja con la petición.
Cuando entra una petición, se crea un identificador de traza. Cada tramo de trabajo, una consulta, una llamada a otro servicio, un cálculo, registra su inicio, su fin y ese identificador. Al llamar a otro servicio, el identificador viaja en una cabecera estándar, y el servicio llamado continúa la misma traza.
# La cabecera estándar que propaga la traza entre servicios
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
#            ^  ^ identificador de la traza          ^ tramo padre    ^ muestreada
Hay un estándar abierto que define tanto esa cabecera como la forma de instrumentar el código y exportar los datos, y tiene librerías para prácticamente todos los lenguajes. Adoptarlo tiene una ventaja que conviene no pasar por alto: no ata a ningún proveedor, porque el mismo código puede enviar las trazas a cualquier sistema compatible.
Instrumentar sin tocar todo el código
La objeción habitual es que añadir trazas exige modificar cada función. Para empezar no hace falta.
Las librerías del estándar incluyen instrumentación automática para los componentes más comunes: el servidor web, los clientes de base de datos, las llamadas HTTP salientes. Activarla produce trazas útiles sin escribir un solo tramo a mano.
# Node: instrumentación automática sin modificar el código de la aplicación
npm install @opentelemetry/auto-instrumentations-node
OTEL_SERVICE_NAME=pedidos \
OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4318 \
node --require @opentelemetry/auto-instrumentations-node/register servidor.js

# Un recolector y visor de trazas local, para empezar a mirarlas
docker run --rm -p 16686:16686 -p 4318:4318 jaegertracing/all-in-one
Con eso, cada petición aparece desglosada en su paso por el servidor, las consultas y las llamadas externas. Los tramos manuales se añaden después, solo en las partes de lógica propia donde haga falta más detalle.
Muestrear para no pagar de más
Guardar la traza completa de cada petición es caro con tráfico real, y casi nunca necesario.
La práctica habitual es el muestreo: se conserva una fracción de las trazas de peticiones normales, por ejemplo una de cada cien, porque para entender el comportamiento típico basta con una muestra.
El matiz importante es que las trazas interesantes son las raras, las lentas y las fallidas, y un muestreo uniforme puede descartarlas justo a ellas. Por eso conviene muestrear de forma que se conserven siempre las peticiones con error y las que superan cierto tiempo, y solo se reduzcan las normales.
Objetivos, no solo gráficos
Un panel lleno de gráficas no dice si el servicio está bien. Para eso hace falta decidir qué significa bien.
Un objetivo de nivel de servicio es esa decisión escrita: el 99,5 por ciento de las peticiones responde correctamente en menos de 300 milisegundos, medido a lo largo de un mes. Con eso, la pregunta de si hay un problema tiene una respuesta objetiva.
El objetivo tiene una consecuencia práctica muy útil: el margen de error que deja. Si el objetivo es 99,5 por ciento, hay un 0,5 por ciento de fallos tolerables al mes. Mientras quede margen, se puede desplegar con tranquilidad; cuando se agota, conviene frenar y estabilizar antes de añadir nada nuevo.
Y las alertas deberían dispararse según ese margen, no según umbrales arbitrarios. Una alerta que salta porque el margen se está consumiendo rápido es una alerta que merece despertar a alguien.
Cuánto de esto necesita un proyecto pequeño
Todo lo anterior puede sonar a infraestructura de empresa grande, y conviene poner la escala en su sitio.
Un proyecto con una sola aplicación y una base de datos no necesita trazado distribuido: con registros estructurados y el identificador de petición se ve casi todo. Lo que sí necesita desde pronto son las cuatro métricas básicas y alertas sobre ellas, que es lo que el artículo sobre monitoreo describe con más detalle.
El trazado empieza a compensar el día que una petición atraviesa varios servicios o depende de proveedores externos lentos. Ahí la diferencia entre tenerlo y no tenerlo es la diferencia entre ver el cuello de botella en un minuto y buscarlo durante una tarde.
Qué se le escapa a una IA con esto
Pedir que se añada monitoreo produce con frecuencia métricas con etiquetas de cardinalidad ilimitada: el identificador de usuario o la dirección completa con parámetros como etiqueta. Funciona en desarrollo y colapsa la base de métricas en producción.
También es habitual que se mida el tiempo de respuesta con una media, que oculta justo los casos lentos que interesan, y que las llamadas a otros servicios no propaguen la cabecera de traza, lo que parte cada petición en trazas sueltas que no se pueden unir.
Las frases que cambian la respuesta son pedir que las etiquetas tengan valores acotados, que la latencia se mida con histogramas o percentiles, y que las llamadas salientes propaguen el contexto de traza.
Y conviene hacer siempre la prueba que valida todo lo anterior: provocar una petición lenta a propósito y comprobar que se puede encontrar su traza y ver en qué tramo se fue el tiempo. Si no se puede, la instrumentación todavía no sirve para el día que haga falta.