Hay decisiones que un modelo toma bien casi siempre: nombres de variables, la estructura de una función, cómo formatear una respuesta JSON.
Son decisiones locales. No dependen de nada fuera del código mismo, así que no importa si la IA conoce o no el contexto de tu negocio.
Hay otras decisiones que sí dependen de ese contexto, y la IA no lo tiene, aunque responda con total seguridad cuando se las pides. Este artículo recorre seis categorías donde eso pasa todo el tiempo.
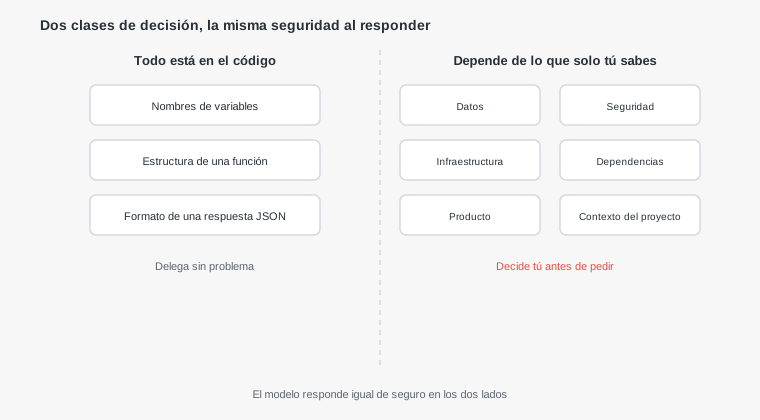
Las seis categorías, en una vista
Antes del detalle conviene tener el mapa completo. La columna de la derecha es la que importa: es el dato que la IA no puede deducir leyendo tu código.
| Categoría | Lo que la IA decide sola | Lo que solo tú sabes |
|---|---|---|
| Datos | Tipos de campo, índices, nombres de tabla | Qué dato es sensible y qué ley te aplica |
| Seguridad | Que exista validación y autenticación | Qué pasa si ese dato se filtra |
| Infraestructura | Una arquitectura que escala | Cuánto cuesta estar caído diez minutos |
| Dependencias | La librería más usada para el caso | Cuántas puedes mantener tú solo |
| Producto | Todo lo técnicamente posible | Qué hace falta para lanzar esta semana |
| Contexto | Nada: no recuerda sesiones anteriores | Qué ya decidiste y por qué |
1. Datos
Qué campos son sensibles y necesitan cifrado o anonimización no es una pregunta técnica. Es una pregunta de negocio y de regulación que cambia según el país donde operas y el tipo de dato que manejas.
Un correo electrónico no pesa igual que un número de tarjeta o un dato de salud. La IA no puede saber en qué categoría cae tu caso a menos que se lo digas explícitamente.
Lo mismo pasa con cuánto tiempo retienes la información de un usuario. Hay leyes, como el GDPR europeo, que obligan a borrar ciertos datos después de un plazo específico, o a eliminarlos por completo si el usuario lo solicita. La IA no sabe cuál regulación te aplica si tú no se lo dices primero.
Hay también una diferencia legal importante entre anonimizar un dato (quitarle toda posibilidad de identificar a la persona) y solo ofuscarlo, por ejemplo mostrando los últimos 4 dígitos de una tarjeta. Distintas regulaciones tratan estos dos casos de forma distinta, y la IA no distingue cuál aplica a menos que se lo especifiques.
Hay una tercera pregunta que casi nadie se hace a tiempo: si el modelo de datos que estás usando hoy va a soportar el volumen que vas a tener en un año, no el que tienes hoy. Cambiar de modelo de datos con usuarios reales ya en producción es de las migraciones más caras y riesgosas que existen.
2. Seguridad
Esta categoría suele reducirse, en la cabeza de mucha gente, a poner contraseña o usar HTTPS. La superficie real es mucho más grande, y buena parte de ella aparece justo en las funciones que se sienten más inofensivas.
Tomemos un caso común: dejar que un usuario suba un archivo. Parece una función simple, un formulario con un botón. Pero abre varias preguntas que la IA no responde por defecto: ¿qué tipos de archivo aceptas? ¿validas el contenido real del archivo, o solo confías en la extensión que declara? ¿dónde se guarda, en un lugar accesible públicamente por accidente?
Un formulario de sube tu foto de perfil sin validar el tipo real de archivo (no solo la extensión) puede terminar aceptando un script disfrazado de imagen. Si ese archivo se guarda en una carpeta servida públicamente, cualquiera con la URL puede ejecutarlo.
La diferencia entre las dos formas de validar se ve mejor en código que en prosa:
// Confía en lo que declara el navegador: se falsifica en un segundo
if (str_ends_with($nombre, '.jpg')) {
    mover($archivo, '/public/uploads/' . $nombre);
}

// Lee los bytes reales del archivo y renombra a algo que tú controlas
$mime = finfo_file(finfo_open(FILEINFO_MIME_TYPE), $archivo['tmp_name']);
if (!in_array($mime, ['image/jpeg', 'image/png', 'image/webp'], true)) {
    return rechazar('Tipo de archivo no permitido');
}
// Fuera del directorio público, con un nombre generado, sin la extensión
// que venía del usuario
$destino = STORAGE_PRIVADO . '/' . bin2hex(random_bytes(16)) . '.jpg';
Tres decisiones distintas en cinco líneas: de dónde sale el tipo, quién elige el nombre y en qué carpeta aterriza. Ninguna de las tres la puede resolver la IA sin saber cómo sirve los archivos tu servidor.
Los formularios en general son otra superficie que se subestima. Cualquier campo de texto libre que termine insertándose en una consulta a base de datos sin sanitizar es una puerta abierta a inyección SQL: alguien escribe, en el campo de nombre, algo que la base de datos interpreta como un comando en lugar de como texto, y de ahí puede leer o borrar datos que no debería poder tocar.
Los ataques de tipo cross-site scripting (XSS) siguen la misma lógica: cualquier dato que un usuario ingresa y que después se muestra sin sanitizar en el navegador de otro usuario es una vía para ejecutar código ajeno dentro de tu sitio. Es exactamente el motivo por el que este proyecto sanitiza todo el contenido enriquecido antes de publicarlo, no porque sea buena práctica en abstracto, sino porque confiar en que nunca va a pasar nada es, en sí mismo, la vulnerabilidad.
Qué endpoints necesitan autenticación y cuáles pueden quedar públicos parece obvio hasta que no lo es. Un endpoint de solo lectura que expone, sin querer, datos de otro usuario distinto al que hizo la petición es uno de los errores más comunes en proyectos hechos rápido.
Las credenciales merecen su propia categoría completa: qué va en variables de entorno, qué va en un gestor de secretos dedicado, y qué directamente no debería existir en ese servidor porque el servicio que lo necesita ni siquiera debería tener acceso a él.
Este tema da para mucho más de lo que cabe aquí. Si quieres profundizar en headers de seguridad, autenticación, RBAC y auditoría, tenemos un eje completo dedicado a seguridad en esta guía.
3. Infraestructura y escalabilidad
Si necesitas alta disponibilidad o si un solo servidor es más que suficiente depende de qué tan grave es que tu proyecto esté caído diez minutos, y esa respuesta la tienes tú, no un modelo entrenado con ejemplos de sistemas a gran escala.
La escalabilidad no es una pregunta. Son dos.
La primera es cuántos usuarios más vas a soportar. Es la que todo el mundo piensa cuando escucha la palabra escalabilidad.
La segunda, menos obvia, es cuántas funciones nuevas vas a poder agregar sin que el sistema se vuelva imposible de mantener. Un sistema puede soportar mil usuarios perfectamente y aun así volverse inmanejable con la quinta funcionalidad nueva, si desde el inicio no se pensó en cómo iba a crecer en complejidad, no solo en tráfico.
Y qué proveedor eliges importa menos por el proveedor en sí que por qué tan fácil es salir de ahí después. Algunos servicios te dan todo gratis al inicio y hacen carísimo migrarte una vez que ya construiste todo sobre sus servicios propietarios, un patrón conocido como vendor lock-in.
4. Dependencias: frameworks y librerías
Cada framework que adoptas trae consigo una forma de pensar el problema, no solo un conjunto de funciones. Elegir uno no es una decisión menor de qué herramienta uso, es una decisión de cuánto tiempo vas a invertir aprendiendo sus convenciones, y cuánto te vas a atar a su forma particular de resolver las cosas.
Las librerías más pequeñas tienen un cálculo distinto pero igual de importante: cada una es código que no escribiste tú, que puede tener errores que no conoces, y que depende de que alguien más la siga manteniendo. Antes de aceptar una nueva, vale la pena preguntarse si de verdad resuelve algo complejo, o si solo añade una función que podrías escribir tú mismo en diez líneas.
Un ataque donde alguien compromete una librería popular, no tu código directamente, para que el código malicioso se distribuya automáticamente a todos los proyectos que la usan en su próxima actualización. Cuantas más dependencias tiene un proyecto, más grande es esta superficie de riesgo.
Esto no significa evitar frameworks y librerías por completo. Significa tratar cada dependencia nueva como una decisión con costo, no como algo gratis solo porque el comando de instalación tomó cinco segundos.
5. Producto
Qué funcionalidad es indispensable para lanzar y qué puede esperar es, al final, la decisión más importante de todas, porque de ahí se derivan casi todas las demás.
Cuando le pides a una IA que agregue funcionalidades, tiende a proponer todo lo que técnicamente sería posible, no lo que tu negocio necesita en esta etapa. Un sistema de notificaciones puede crecer hasta incluir preferencias granulares por canal, resumen semanal, y configuración por tipo de evento, cuando lo único que necesitabas era avisar por correo cuando algo importante pasa.
La IA puede ayudarte a evaluar el costo y la complejidad técnica de cada opción sobre la mesa. Pero cuál es la prioridad real para tu negocio, con tus usuarios y tu momento específico, es algo que solo tú puedes responder.
6. El contexto del proyecto como decisión en sí misma
Hay una decisión más que casi nadie toma a tiempo: cómo le vas a dar continuidad a la IA entre una sesión y la siguiente.
Sin eso, cada conversación nueva empieza de cero, y es común que el modelo proponga algo que contradice, o incluso rompe, una decisión que ya habías tomado semanas atrás.
Una práctica que resuelve esto es mantener un archivo tipo AGENTS.md con las decisiones de arquitectura ya tomadas, y otro tipo TASKS.md con el estado real del proyecto: qué está hecho, qué está en progreso, qué falta.
Pegarle estos archivos a la IA al inicio de cada sesión reduce drásticamente las veces que alucina una arquitectura que no existe, o rompe algo que ya funcionaba porque no sabía que ya estaba resuelto de otra forma.
Cómo usar esto en la práctica
Seis categorías son demasiadas para repasar en cada prompt. La forma realista de aplicarlas es preguntarse una sola cosa antes de aceptar una propuesta: ¿esta decisión cae en alguna de las seis?
Si la respuesta es no, acepta y sigue. La mayoría de las decisiones de un día de trabajo son locales y no ameritan este repaso.
Si la respuesta es sí, hay un paso intermedio barato que evita casi todo el daño: pedirle a la IA que exponga el supuesto en vez de la solución.
“Antes de implementar esto, dime qué asumiste sobre mis datos, mi escala y mi presupuesto. Si algún supuesto te falta, pregúntamelo en vez de elegir por mí.”
Esa última frase es la que cambia el comportamiento. Sin ella el modelo rellena los huecos en silencio, porque no puede devolver una respuesta vacía. Con ella, los huecos se vuelven preguntas, que es exactamente donde tú puedes intervenir.
Y cuando la decisión sea costosa de revertir, conviene dejarla escrita antes de escribir el código. Una línea en AGENTS.md que diga qué se decidió y por qué vale más que reconstruir el razonamiento tres meses después, cuando ya nadie recuerde si fue una decisión o un accidente.
Ninguna de estas seis categorías necesita que seas un experto para decidir bien. Necesitan que te detengas a pensarlas antes de aceptar la primera respuesta que te da el modelo, porque esa primera respuesta va a sonar segura de sí misma, la tenga clara o no.