El servicio de clientes cambió el nombre de un campo, de nombre a nombre_completo. Todas sus pruebas pasaban, porque se actualizaron junto con el cambio. El despliegue salió sin problemas. Y a los cinco minutos, el servicio de pedidos empezó a fallar en producción, porque seguía leyendo el campo antiguo.
Ninguna prueba de ninguno de los dos servicios podía detectarlo, porque cada uno se probaba solo. Ese hueco, el que queda entre dos piezas que se desarrollan por separado, es el que cubren las pruebas de contrato.
El problema que resuelven
Cuando un sistema está repartido en varios servicios, cada uno tiene sus propias pruebas y cada una comprueba que ese servicio funciona según lo entiende su equipo. Lo que ninguna comprueba es que lo que un servicio envía coincida con lo que el otro espera recibir.
La respuesta tradicional es la prueba de extremo a extremo: levantar todos los servicios a la vez y recorrer un flujo completo. Funciona, y tiene los problemas de siempre multiplicados: es lenta, frágil, exige que todos los servicios estén disponibles y en la versión correcta, y cuando falla no dice qué servicio rompió qué.
Con tres servicios es tolerable. Con quince, levantar todo el entorno para probar cualquier cambio se convierte en el cuello de botella de todos los equipos.
Un contrato entre dos servicios
La idea consiste en poner por escrito lo que un servicio espera del otro, y verificar ese documento por separado en cada lado.
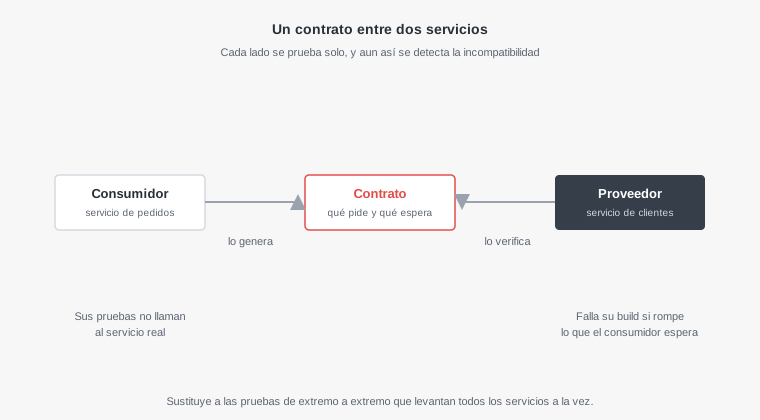
El consumidor, el servicio que llama, escribe sus pruebas contra una simulación del proveedor. Mientras lo hace, esa simulación registra qué peticiones hizo y qué respuestas necesitaba. Ese registro es el contrato.
El proveedor, el servicio llamado, toma ese contrato y lo reproduce contra su código real. Si alguna respuesta ya no coincide con lo que el consumidor espera, su proceso de construcción falla antes de desplegar.
En el ejemplo del principio, el servicio de clientes habría visto fallar su propia batería al renombrar el campo, porque el contrato del servicio de pedidos seguía pidiendo nombre.
Por qué lo escribe el consumidor
La variante más extendida pone el contrato en manos de quien consume, y el motivo es práctico.
Un proveedor puede tener cincuenta campos en una respuesta, y cada consumidor usa unos pocos. Si el contrato describiera todo lo que el proveedor ofrece, cualquier cambio en cualquier campo rompería todos los contratos, aunque nadie usara ese campo.
Cuando cada consumidor declara solo lo que realmente usa, el proveedor sabe exactamente qué puede cambiar sin romper a nadie. Un campo que ningún contrato menciona se puede eliminar con tranquilidad; uno que aparece en tres contratos, no.
Esa información, qué partes de una API usa realmente cada consumidor, es valiosa por sí misma y casi nunca existe por escrito.
Qué comprueba y qué no
Conviene precisarlo, porque se confunde con otros tipos de prueba y se le piden cosas que no hace.
Un contrato comprueba la forma de la conversación: qué dirección se llama, con qué método, qué cabeceras, qué estructura tiene la respuesta, qué tipos tienen los campos y qué códigos de estado se devuelven.
No comprueba la lógica del proveedor. Si el servicio de clientes devuelve un nombre con el formato correcto pero el dato es de otra persona, el contrato no lo detecta. Eso sigue siendo trabajo de las pruebas propias del proveedor.
Por eso los contratos conviene escribirlos con valores flexibles: que el campo sea un texto, no que sea exactamente cierto texto. Un contrato que exige valores concretos se rompe con cada cambio de datos y deja de ser útil.
Cómo se ve en la práctica
La herramienta de código abierto más extendida para esto se llama Pact, y tiene implementaciones para la mayoría de los lenguajes. El consumidor declara la interacción en su prueba:
// Prueba del consumidor (servicio de pedidos)
await provider.addInteraction({
  state: 'existe el cliente 412',
  uponReceiving: 'una petición del cliente 412',
  withRequest: { method: 'GET', path: '/clientes/412' },
  willRespondWith: {
    status: 200,
    body: {
      id: like(412),                 // cualquier número
      nombre: like('Ana Pérez'),     // cualquier texto
      email: like('ana@ejemplo.com'),
    },
  },
});

// La prueba llama a la simulación, no al servicio real
const cliente = await clienteApi.obtener(412);
expect(cliente.nombre).toBeDefined();
Al ejecutarse, se genera un archivo con el contrato. El proveedor lo verifica contra su servicio levantado en local:
# Lado del consumidor: ejecutar las pruebas genera pacts/pedidos-clientes.json
npm test

# Lado del proveedor: verificar ese contrato contra el servicio real
npx pact-provider-verifier http://localhost:8080 \
  --pact-urls ./pacts/pedidos-clientes.json \
  --provider-states-setup-url http://localhost:8080/_pact/estados
Los estados del proveedor
Hay un detalle que decide si esto funciona y que suele descubrirse tarde: el contrato dice que existe el cliente 412, y el proveedor tiene que poder preparar ese escenario.
Por eso cada interacción lleva un estado con nombre, como existe el cliente 412 o el cliente no tiene pedidos, y el proveedor expone una forma de preparar cada estado antes de verificar. Normalmente es un endpoint solo disponible en pruebas que inserta los datos necesarios.
Conviene que los nombres de los estados sean descriptivos del negocio y no técnicos, y que ambos equipos los acuerden. Son la parte del contrato que exige más conversación entre ellos, y precisamente por eso es la más valiosa.
Y ese endpoint de preparación no debe existir nunca fuera del entorno de pruebas. Un punto que inserta datos arbitrarios, desplegado en producción por descuido, es una puerta abierta.
Compartir los contratos entre equipos
Cuando consumidor y proveedor viven en repositorios distintos, el contrato tiene que viajar de uno a otro de alguna forma.
La opción simple es copiarlo al repositorio del proveedor, que sirve con pocos servicios y se vuelve inmanejable con muchos.
La opción habitual es un servidor intermedio donde los consumidores publican sus contratos y los proveedores los descargan para verificar. Existe una implementación de código abierto que se puede alojar uno mismo, y que además responde a la pregunta más útil antes de desplegar: si esta versión es compatible con las versiones de los demás que están en producción.
# Antes de desplegar: ¿esta versión es compatible con lo que hay en producción?
npx pact-broker can-i-deploy \
  --pacticipant servicio-clientes --version $(git rev-parse --short HEAD) \
  --to-environment produccion \
  --broker-base-url https://contratos.ejemplo.interno
Cuando un contrato falla, quién decide
La herramienta detecta la incompatibilidad; lo que no resuelve es la conversación que viene después, y conviene tenerla acordada antes de que ocurra.
Un contrato roto tiene dos lecturas posibles. O el proveedor introdujo un cambio que rompe a alguien sin querer, y lo que toca es revertirlo o hacerlo compatible. O el consumidor dependía de algo que el proveedor nunca prometió, y lo que toca es actualizar el contrato del consumidor.
La regla que evita discusiones es que el proveedor no despliega mientras exista un contrato roto de un consumidor en producción. Si el cambio es necesario, se hace en dos pasos: primero se añade lo nuevo manteniendo lo antiguo, los consumidores migran y actualizan sus contratos, y solo entonces se retira lo que ya nadie pide.
Es la misma técnica de expandir y contraer que se usa con los cambios de esquema de base de datos, aplicada a la frontera entre servicios, y por la misma razón: permite que dos piezas que cambian a ritmos distintos no se rompan mutuamente durante la transición.
Conviene además que el fallo llegue a quien puede actuar. Un contrato roto que solo aparece en el registro del proceso de construcción del proveedor, sin avisar al equipo consumidor, suele resolverse desactivando la verificación, que es la peor salida posible.
Cuándo compensa y cuándo no
Las pruebas de contrato resuelven un problema concreto, y conviene no adoptarlas donde ese problema no existe.
- Compensan cuando hay varios servicios desarrollados por equipos distintos que despliegan por separado. Es exactamente el caso donde el cambio de un campo rompe a otro sin que nadie lo vea.
- Compensan cuando se consume una API interna de otro equipo cuyo calendario de cambios no controlas.
- No compensan en un monolito, donde el compilador o una prueba de integración normal ya detectan el campo renombrado.
- No compensan cuando consumidor y proveedor los desarrolla la misma persona y despliegan juntos.
- Tienen poco sentido frente a APIs públicas de terceros, que no van a verificar tu contrato. Ahí sirven más las pruebas contra una respuesta grabada y un aviso cuando cambia.
Para la mayoría de los proyectos pequeños la conclusión es que no hacen falta todavía. Pasan a ser importantes el día que un segundo equipo empieza a consumir una API y ambos despliegan por su cuenta.
La alternativa ligera que casi siempre basta
Antes de adoptar la herramienta completa hay un escalón intermedio que cubre buena parte del riesgo con muy poco esfuerzo: validar las respuestas contra un esquema compartido.
Si el proveedor publica la descripción formal de su API, el consumidor puede comprobar en sus pruebas que las respuestas reales o grabadas cumplen ese esquema, y el proveedor puede comprobar que su implementación sigue cumpliendo su propia descripción.
# Detectar cambios incompatibles entre dos versiones de la descripción de una API
npx @openapitools/openapi-diff api-v1.yaml api-v2.yaml

# Comprobar que el servidor real sigue cumpliendo su propia especificación
npx dredd api.yaml http://localhost:8080
No ofrece la precisión de saber qué campos usa cada consumidor, pero detecta la mayoría de los cambios incompatibles y solo exige mantener un archivo.
Qué se le escapa a una IA con esto
Pedir pruebas para un servicio que llama a otro produce, casi siempre, pruebas con una simulación escrita a mano del servicio remoto. Pasan perfectamente y no detectan nada cuando el servicio real cambia, porque la simulación no se entera.
Esa simulación es, en la práctica, un contrato que solo conoce una de las partes. El día que el proveedor cambia algo, la prueba sigue en verde y producción falla.
La frase que cambia la respuesta es preguntar cómo se enteraría el proveedor si rompe lo que esta simulación asume. Si la respuesta es que no se enteraría, hay un hueco.
Y cuando sí se generan pruebas de contrato, conviene revisar dos cosas: que los valores sean flexibles en lugar de exactos, para que el contrato no se rompa con cada cambio de datos, y que el endpoint de preparación de estados esté protegido para que nunca llegue a producción.