Conviene empezar por el dato que casi nunca acompaña a esta pregunta: las caídas completas de una región de un proveedor grande ocurren, como mucho, un puñado de veces al año, y suelen durar horas.
Mientras tanto, la mayoría de los sistemas que se caen lo hacen por un despliegue que salió mal, una migración que borró lo que no debía o una clave que venció sin que nadie lo anotara. Ninguna de esas tres cosas mejora teniendo el sistema en dos sitios.
Esa desproporción es el centro del asunto. Multi-región es una respuesta cara y compleja a un riesgo poco frecuente, mientras los riesgos frecuentes siguen sin cubrir.
Qué cubre realmente tener dos regiones
Antes de decidir, conviene ver con precisión qué entra y qué no entra en la protección que se está comprando.
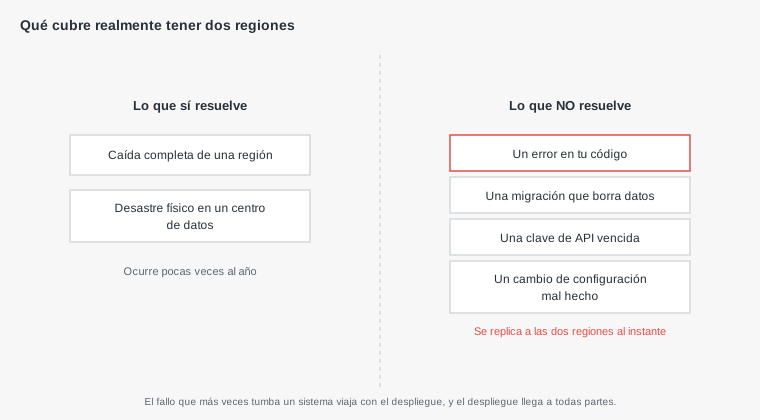
La columna de la derecha es la que decide. Un error de código desplegado se replica a las dos regiones en el mismo minuto. Una migración que borra una tabla la borra en las dos. Una credencial vencida vence en las dos. Duplicar la infraestructura duplica también el alcance de esos fallos, no lo reduce.
Y hay un efecto de segundo orden que se subestima: un sistema repartido en dos regiones es más complejo, y la complejidad es en sí misma una causa de caídas. Se añaden réplicas que pueden desincronizarse, enrutamiento que puede fallar y procedimientos que nadie practica. No es raro que la propia arquitectura de alta disponibilidad acabe provocando más incidentes de los que evita.
Cinco preguntas para responderlo con fundamento
Ninguna es técnica. Varias pueden cerrar la decisión por sí solas, y conviene responderlas con lo que es cierto hoy, no con el escenario optimista.
1. ¿Qué cuesta una hora caído, en dinero o en confianza?
Es la pregunta que ordena todas las demás, y la que casi nunca se hace antes de elegir arquitectura.
Para una tienda con ventas constantes, una hora tiene un precio que se puede calcular con el histórico. Para una herramienta interna, el costo es incomodidad. Para un proyecto que aún busca usuarios, una caída de tres horas un domingo no la nota nadie.
Si ese número es pequeño o difuso, la conversación sobre multi-región termina aquí, y lo que corresponde es asegurarse de recuperar bien, que es mucho más barato.
2. ¿Tienes cubiertos los fallos frecuentes?
Antes de protegerse de lo que pasa una vez al año, conviene estar protegido de lo que pasa todos los meses.
Eso significa copias de seguridad probadas con una restauración real, una forma de revertir un despliegue en minutos, alertas que avisen de una caída y un procedimiento escrito para los primeros minutos de un incidente. Las cuatro cosas cuestan una tarde entre todas.
Montar multi-región sin tener esto resuelto es reforzar la puerta blindada mientras la ventana sigue abierta.
3. ¿Hay un requisito externo que lo exija?
A veces la respuesta no depende del riesgo sino de un contrato. Un cliente grande, un pliego público o una norma sectorial pueden exigir continuidad con condiciones concretas.
Cuando existe ese requisito, la decisión ya está tomada y lo que queda es cumplirlo de la forma más simple posible. Conviene leer la exigencia literal: muchas veces pide un objetivo de recuperación alcanzable con copias en otra región, no un sistema activo en dos sitios a la vez.
4. ¿Quién va a operar esto, y ha practicado el cambio?
Una arquitectura en dos regiones solo sirve si alguien sabe pasar el tráfico de una a otra bajo presión, de madrugada, con el sistema caído.
Si ese cambio nunca se ha ensayado, lo que hay no es alta disponibilidad: es una segunda región apagada que factura todos los meses. Y el día del incidente, la decisión de activarla llega tarde porque nadie está seguro de qué va a pasar.
La pregunta práctica es cuándo fue la última vez que se probó. Si la respuesta es nunca, el dinero ya se está gastando sin recibir la protección.
5. ¿Está presupuestado sostenerlo, no solo montarlo?
El costo no es el doble, es más que el doble. Se duplica el cómputo y el almacenamiento, se suma la transferencia entre regiones, que se factura, y se añade el tiempo de mantener dos entornos sincronizados.
Ese último costo es el que se olvida y el que no baja nunca. Cada cambio de configuración hay que aplicarlo dos veces y verificarlo dos veces.
Las cuatro respuestas posibles
Con esas preguntas respondidas, casi todos los proyectos caen en uno de estos cuatro sitios.
- Una sola región, con copias en otra. Cubre el desastre irreversible por poco dinero: si la región cae, se restaura en otra con unas horas de trabajo. Es la respuesta correcta para la gran mayoría de los proyectos pequeños y medianos.
- Una región, con la infraestructura descrita en archivos. El paso siguiente. Si todo el entorno se puede recrear ejecutando una definición, levantar en otra región deja de ser una odisea y pasa a ser un procedimiento de una hora.
- Segunda región en espera. La infraestructura existe pero no atiende tráfico, con los datos replicándose. Reduce el tiempo de recuperación a minutos y cuesta bastante menos que tenerla activa. Tiene sentido cuando una hora caído duele de verdad.
- Dos regiones activas. Ambas atienden usuarios en todo momento. Es la única que sobrevive a una caída sin interrupción, y también la más cara y la más difícil de operar. Se justifica con requisitos contractuales o con un costo por minuto que lo pague solo.
La mayoría de los proyectos que creen necesitar la cuarta se cubren de sobra con la primera o la segunda. Y el salto entre ellas no es irreversible: describir la infraestructura en archivos es útil por sí mismo y deja preparado el camino si algún día hace falta más.
El caso que sí es distinto: usuarios lejos
Hay un motivo para repartir geográficamente que no tiene que ver con las caídas y que se confunde con ellas: la distancia.
Si tus usuarios están en otro continente, cada petición viaja ida y vuelta y esa demora se nota, sobre todo en aplicaciones con muchas llamadas pequeñas. Ahí sí hay una razón para acercar algo a donde está la gente.
Pero la solución suele ser más barata que duplicar el sistema. Una red de distribución de contenido acerca las imágenes, los archivos y las páginas que no cambian, que es la mayor parte del peso de un sitio, sin tocar la arquitectura. Solo cuando lo que pesa es la parte dinámica tiene sentido plantearse mover cómputo.
Conviene además medirlo antes de actuar. La sensación de lentitud se atribuye a la distancia con facilidad, y bastantes veces resulta ser una consulta mal indexada que tardaría lo mismo estando al lado.
El problema de los datos, que es el que decide de verdad
Hasta aquí todo suena a duplicar servidores, que es la parte fácil. La dificultad real de repartir un sistema en dos regiones está en los datos, y es la que convierte una idea razonable en un proyecto largo.
La razón es física y no se puede negociar: entre dos regiones lejanas hay una demora de ida y vuelta que no baja de decenas de milisegundos. Eso obliga a elegir entre dos comportamientos, y no hay una tercera opción.
Si se exige que un dato escrito en una región esté disponible en la otra antes de confirmar la operación, cada escritura paga ese viaje y el sistema se vuelve notablemente más lento para todos, todo el tiempo, a cambio de un suceso que ocurre una vez al año.
Si en cambio la réplica viaja por detrás, las escrituras siguen siendo rápidas, pero aparece una ventana en la que las dos regiones no coinciden. Un usuario puede guardar algo y no verlo al recargar, si la segunda petición la atendió la otra región. Y si la región principal cae justo en esa ventana, lo que no alcanzó a replicarse se pierde.
Por eso la pregunta que cierra la decisión no es cuántas regiones quieres, sino qué pasa si dos usuarios modifican lo mismo en regiones distintas durante esos segundos. Si no hay una respuesta escrita para eso, el sistema no está listo para estar activo en dos sitios, por mucha infraestructura que se haya montado.
La alternativa que casi nadie considera
Entre no tener nada y duplicarlo todo hay un punto intermedio que resuelve la mayor parte del problema por una fracción del costo, y es el que conviene evaluar antes de descartarlo.
Consiste en separar qué partes del sistema necesitan seguir funcionando y cuáles pueden esperar. Casi ningún proyecto necesita que todo esté disponible siempre: necesita que ciertas cosas no se detengan.
Una tienda que puede seguir mostrando el catálogo y aceptando pedidos, aunque el panel de administración esté caído y los informes no se generen, ha resuelto lo que importaba. Eso se consigue con una parte estática servida desde una red de distribución y una función pequeña que recoja pedidos, no con una réplica completa de la infraestructura.
Esa versión reducida suele costar poco al mes y se puede probar de verdad, que es su mayor ventaja frente a la segunda región apagada que nadie ensaya. Y cuando el proyecto crezca hasta justificar algo mayor, el trabajo hecho no se tira: la separación entre lo crítico y lo prescindible es exactamente la que hace falta después.
Cómo plantearlo al pedir ayuda
Si le preguntas a un modelo si necesitas alta disponibilidad, la respuesta tenderá al sí, con un diagrama de dos regiones y replicación. No porque se equivoque, sino porque es la respuesta que más abunda en la literatura técnica y porque nadie mencionó el presupuesto ni el tamaño del equipo.
La pregunta que cambia la conversación es otra: cuánto costaría al mes cada una de las cuatro opciones anteriores, y qué tiempo de recuperación ofrece cada una. Con esa tabla delante, la decisión deja de ser entre estar protegido o no estarlo, y pasa a ser cuánto se paga por cuántos minutos.
Y conviene cerrar con la pregunta incómoda: de los últimos incidentes reales que ha tenido este proyecto, ¿cuántos habría evitado esta arquitectura? Casi siempre la respuesta honesta es ninguno, y eso reordena las prioridades mejor que cualquier argumento.