Hay una frase muy citada entre programadores que dice que solo quedan dos problemas difíciles en informática: invalidar cachés y nombrar cosas. Se repite como chiste, pero la primera mitad describe con precisión por qué este tema da más problemas de los que parece.
Guardar una copia de algo para no volver a calcularlo es trivial. Saber cuándo esa copia dejó de ser cierta, y quién se encarga de tirarla, es donde aparecen los errores raros: el usuario que cambia su foto y sigue viendo la anterior, el precio actualizado que unos ven y otros no, el descuento que caducó y sigue aplicándose.
Este artículo trata de las tres capas donde se guardan esas copias, de cuándo conviene cada una y, sobre todo, de cómo decidir cuánto tiempo vive lo guardado.
Por dónde pasa una petición
Antes de elegir dónde guardar conviene ver el recorrido completo, porque cada capa puede responder antes y ahorrar todo lo que viene después.
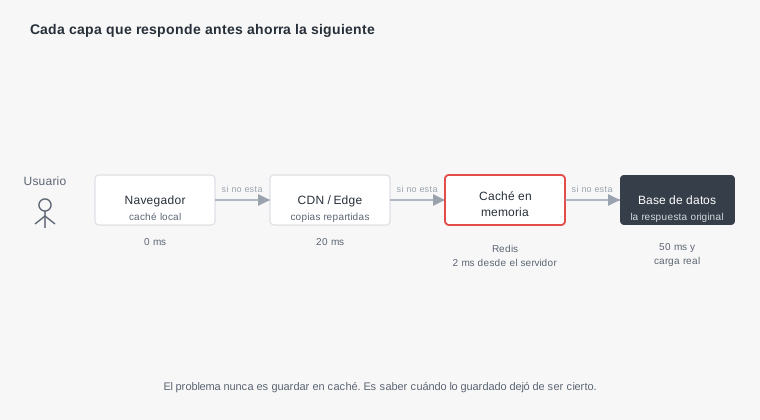
La lectura importante del recorrido es que las capas no son alternativas: se suman. Una petición que se resuelve en el navegador no llega a la red, una que se resuelve en la CDN no llega a tu servidor, y una que se resuelve en memoria no llega a la base de datos.
Por eso la pregunta no es cuál de las tres usar, sino cuál es la capa más cercana al usuario que puede responder correctamente a cada cosa. Cuanto más cerca, más barato y más rápido, y también más difícil de corregir cuando el dato cambia.
La caché del navegador, la que ya estás usando
Es la más antigua, la que menos atención recibe y la que más tráfico ahorra sin hacer nada especial. El navegador guarda archivos localmente y, mientras sigan vigentes, ni siquiera pregunta.
Funciona bien para lo que no cambia: hojas de estilo, scripts, tipografías, imágenes. El problema clásico aparece cuando sí cambian: publicas una corrección y una parte de los usuarios sigue viendo la versión anterior durante días, porque su navegador tiene guardada la vieja y no tiene motivo para volver a pedirla.
La solución que resolvió esto de forma definitiva consiste en cambiar el nombre del archivo cada vez que cambia su contenido, añadiéndole una huella. Si el archivo se llama distinto, el navegador lo pide de nuevo sin dudar, y como el nombre solo cambia cuando cambia el contenido, se puede guardar durante un año sin riesgo.
Esa es la configuración que conviene: guardado prácticamente eterno para lo que lleva huella, y nada de guardado para el documento HTML principal, que es el que apunta a los demás. Casi todas las herramientas modernas de construcción generan esos nombres solas.
La CDN, para lo que es igual para todos
Una red de distribución de contenido es un conjunto de servidores repartidos geográficamente que guardan copias de tu contenido y responden desde el más cercano a cada visitante.
Su beneficio evidente es la distancia, pero el importante suele ser otro: la mayor parte del tráfico deja de llegar a tu servidor. Un sitio con imágenes pesadas puede reducir de forma drástica tanto la carga como la factura de transferencia, que es uno de los cargos que más sorprenden.
La condición para que funcione es que el contenido sea igual para todos. Una imagen de producto, un archivo descargable o una página pública encajan perfectamente. Un panel que muestra el nombre del usuario, no: si se guarda por error, hay riesgo de servirle a alguien la versión de otro, que es el fallo más grave de todo este tema.
Ese riesgo merece una regla explícita, porque no es teórico y ha ocurrido en sitios importantes: nada que dependa de quién está mirando puede guardarse en una capa compartida, salvo que la clave de guardado incluya al usuario. En la práctica, la forma segura es marcar como privado todo lo que se sirve tras un inicio de sesión.
Redis, para lo que cuesta calcular
La tercera capa vive en tu propia infraestructura y guarda resultados en memoria, con acceso casi instantáneo. Es la que más control ofrece y la que más disciplina exige.
Los casos donde más rinde son tres, y ninguno tiene que ver con guardar páginas enteras. El primero es una consulta costosa cuyo resultado sirve para muchos usuarios, como un listado de los productos más vendidos. El segundo es una respuesta de un servicio externo que tarda o se cobra por llamada. El tercero es un dato que se pide constantemente y cambia poco, como la configuración del sitio.
Hay además un uso que no es exactamente caché y que suele ser el primero que se justifica: guardar sesiones y contadores para limitar peticiones. Son datos de vida corta, que no pasa nada si se pierden, y que encajan mejor en memoria que en la base de datos.
Todo lo que guardes debe tener una caducidad. Sin excepciones, aunque creas que vas a borrarlo manualmente cuando cambie.
Una entrada sin caducidad que no se borra bien se convierte en un dato incorrecto que se sirve para siempre, y ese es el fallo más difícil de diagnosticar, porque el código está bien y la base de datos también.
Cuánto tiempo debe vivir cada cosa
Esta es la decisión que de verdad importa, y casi siempre se toma sin pensarla, copiando un número de un ejemplo.
La forma correcta de decidirla es preguntarse cuánto tiempo puede estar desactualizado ese dato sin causar un problema real. No cuánto tarda en cambiar: cuánto tolera estar viejo.
El precio de un producto tolera muy poco, porque mostrar uno incorrecto tiene consecuencias. Un listado de artículos del blog tolera minutos sin que nadie lo note. El número de visitas de una página tolera horas. Y una imagen con huella en el nombre tolera un año, porque si cambia, cambia su nombre.
Cuando la respuesta honesta es que no tolera nada, la conclusión no es usar un tiempo muy corto: es no guardarlo. Una caché de cinco segundos añade complejidad y riesgo a cambio de un ahorro mínimo.
Hay un matiz que ahorra sustos cuando el tráfico crece: si muchas entradas caducan a la vez, todas las peticiones caen sobre la base de datos en el mismo instante. Añadir una variación aleatoria pequeña a cada caducidad reparte esa avalancha, y es un detalle que solo se descubre cuando ya ocurrió.
Las dos estrategias para mantenerlo al día
Hay dos formas de que lo guardado deje de ser mentira, y conviene elegir a conciencia en lugar de mezclarlas sin darse cuenta.
La primera es dejar que caduque. Se fija un tiempo, se acepta que durante ese rato el dato puede estar viejo, y no hay nada más que hacer. Es simple, predecible y suficiente para la mayoría de los casos.
La segunda es borrar la entrada en el momento en que el dato cambia. Es más precisa y bastante más frágil, porque exige acordarse de hacerlo en todos los sitios donde ese dato se modifica, incluidos los que se escriban dentro de seis meses.
La combinación que funciona en proyectos pequeños es usar caducidad como base, siempre, y añadir borrado explícito solo para lo que no puede esperar. Así, si alguien olvida borrar, el sistema se corrige solo al cabo de unos minutos en vez de quedarse mal indefinidamente.
El primer paso es medir, no guardar
Antes de añadir cualquier capa conviene saber qué se está intentando arreglar, porque la caché es una de esas soluciones que se aplican por costumbre y no por diagnóstico.
La medición útil no es el tiempo total de carga, que mezcla demasiadas cosas. Es saber, para la pantalla que preocupa, cuánto tiempo se va en consultas a la base de datos, cuánto en llamadas a servicios externos y cuánto en enviar archivos al navegador. Esos tres números apuntan a tres soluciones distintas, y solo la tercera se resuelve con una red de distribución.
Ese reparto además suele sorprender. En sitios pequeños, la mayor parte del tiempo de carga se va con frecuencia en el peso de las imágenes y los scripts, no en la base de datos. Cuando es así, comprimir bien las imágenes rinde más que cualquier caché, y no añade ninguna complejidad al sistema.
Solo cuando el tiempo se concentra en trabajo repetido del servidor tiene sentido guardar resultados. Y ahí conviene empezar por la operación concreta que domina la medición, no por montar una capa general que cubra todo.
Guardar lo que no cambia casi nunca
Hay una categoría de contenido donde la caché deja de tener casi todos sus riesgos, y es la que conviene atacar primero porque el beneficio es alto y el peligro bajo.
- Páginas públicas que no dependen del visitante. Un artículo, una página de producto, la portada. Se pueden servir desde la CDN y reducir el tráfico a tu servidor casi a cero.
- Respuestas de servicios externos que cambian poco. Un tipo de cambio, una lista de países, la información de un proveedor. Guardarlas evita llamadas que tardan y a veces se cobran.
- Cálculos sobre datos históricos. Un informe del mes pasado no va a cambiar. Recalcularlo en cada visita es trabajo tirado.
- Archivos con huella en el nombre. Ya mencionados, y el caso más seguro de todos: como el nombre cambia con el contenido, se pueden guardar indefinidamente.
Estos cuatro casos cubren buena parte del ahorro posible en un proyecto pequeño, y ninguno exige resolver el problema difícil de la invalidación, porque el dato o no cambia o tolera de sobra estar viejo un rato.
Lo que queda fuera, el contenido personalizado y los datos que cambian a cada momento, es donde conviene ser conservador. Ahí el beneficio es menor y el riesgo de servir algo incorrecto es real.
Cuándo la caché está tapando otro problema
Conviene una advertencia, porque es un patrón frecuente: la caché se usa a menudo para esconder una consulta mal escrita en lugar de arreglarla.
Si una consulta tarda dos segundos y se guarda el resultado, el sitio va rápido casi siempre y va lento justo cuando la entrada caduca, de forma impredecible. Y el problema sigue ahí, esperando al día en que el volumen crezca o la caché se vacíe.
La comprobación es directa: mira qué tarda la operación sin caché. Si el número es malo, lo que hay es un problema de consulta o de índice, y la caché solo está retrasando el momento de enfrentarlo. Cuando el número es razonable y aun así conviene ahorrar trabajo, entonces la caché es la herramienta correcta.
Qué se le escapa a una IA con esto
Pedir ayuda para añadir caché produce código que funciona a la primera y que suele traer tres omisiones, siempre las mismas.
La primera es la caducidad, que se deja abierta o muy larga porque nadie dijo cuánto tolera ese dato estar viejo. La segunda es la invalidación: se escribe la parte que guarda y no la que borra cuando el dato cambia. La tercera, la más delicada, es que la clave no distingue al usuario, lo que en un contenido personalizado significa servirle a alguien los datos de otro.
Las tres se evitan con la misma frase añadida a la petición: decir qué dato es, cuánto tiempo tolera estar desactualizado y si depende de quién lo mira. Con eso, la respuesta cambia de una caché genérica a una que encaja con el caso.
Y conviene revisar siempre qué pasa cuando la caché no está disponible. Un sistema que deja de funcionar porque el servicio de caché se cayó convirtió una optimización en una dependencia crítica, que es justo lo contrario de lo que se buscaba.