Una de las confusiones más caras de los últimos años viene de tratar estas tres cosas como si compitieran por el mismo puesto. Se las compara en tablas, se pregunta cuál es mejor, y se elige una como si las otras quedaran descartadas.
No compiten. Responden a preguntas distintas, y la mayoría de los proyectos que se meten en problemas lo hacen por usar una para responder la pregunta de otra.
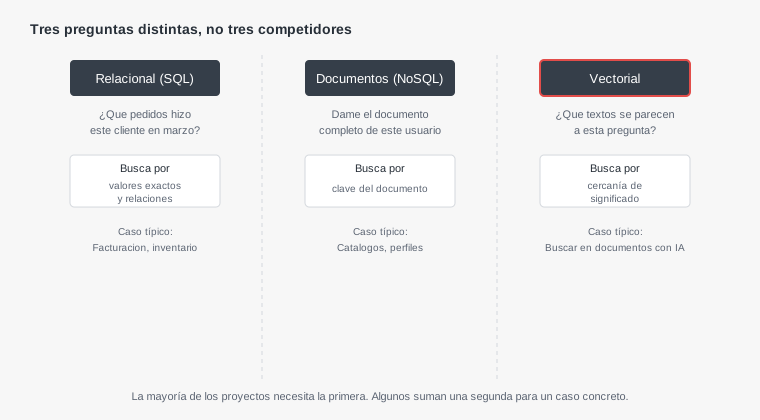
Qué pregunta responde cada una
La forma útil de distinguirlas no es por su tecnología sino por el tipo de búsqueda para la que están construidas.
Una base relacional está hecha para cruzar datos que viven en sitios distintos y responder con exactitud. Qué pedidos hizo un cliente, cuánto suman, cuáles siguen pendientes. La pregunta tiene una respuesta correcta y la base la calcula combinando tablas.
Una base de documentos está hecha para guardar y devolver una cosa completa de una vez. El perfil de un usuario con todos sus datos anidados, la ficha de un producto con sus variantes. La pregunta habitual es dame esto, y la respuesta llega sin combinar nada.
Una base vectorial está hecha para encontrar lo que se parece. No busca un valor exacto: busca proximidad de significado. Qué párrafos de mi documentación se parecen a esta pregunta, qué productos son similares a este.
Puestas así, la elección deja de ser una cuestión de gustos. Si tu pregunta es cuánto facturamos el mes pasado, la vectorial no puede responderla, y si tu pregunta es qué dice mi manual sobre devoluciones, la relacional tampoco.
Por qué la relacional sigue siendo la respuesta por defecto
Conviene decirlo claro porque va contra la corriente de los últimos años: para la inmensa mayoría de los proyectos, una base relacional es la elección correcta y las otras dos son añadidos posteriores, si acaso.
La razón no es tradición. Es que los datos de un negocio casi siempre tienen relaciones, y esas relaciones hay que mantenerlas coherentes. Un pedido pertenece a un cliente y contiene productos que existen en un catálogo. Si el cliente se borra, sus pedidos no pueden quedar apuntando al vacío. Una base relacional garantiza eso por diseño; en las otras, esa garantía la tiene que escribir alguien.
La segunda razón es que las preguntas cambian. Al empezar nadie sabe qué informes va a necesitar dentro de un año, y una base relacional permite hacer preguntas que no se previeron al diseñarla. Los modelos pensados para un patrón de acceso concreto son rapidísimos para ese patrón y muy incómodos para el resto.
Y la tercera, práctica: PostgreSQL incorpora hoy tipos para documentos y una extensión para búsqueda vectorial. Un proyecto pequeño puede cubrir los tres casos con un solo motor, un solo respaldo y una sola cosa que aprender a operar.
Empieza con una relacional. Cuando aparezca un caso que de verdad no encaje, evalúa si la extensión del mismo motor lo resuelve. Solo si tampoco alcanza, añade una base especializada.
Añadir un motor nuevo no es sumar una herramienta: es sumar copias de seguridad, monitoreo, credenciales y un sitio más donde los datos pueden desincronizarse.
Cuándo una base de documentos sí encaja
Hay casos donde el modelo de documentos es claramente mejor, y conviene reconocerlos para no descartarla por principio.
El más claro es cuando cada registro tiene una forma distinta y esa variedad es parte del problema, no un defecto del diseño. Un catálogo donde cada categoría de producto tiene atributos propios, o un sistema de formularios donde el usuario define los campos, encajan mal en una tabla con columnas fijas.
El segundo es cuando el patrón de acceso es siempre el mismo y siempre completo: se guarda un documento entero y se lee entero, sin cruzarlo con nada. Registros de eventos, configuraciones, sesiones.
Lo que casi nunca justifica el cambio es el rendimiento. La creencia de que las bases de documentos son más rápidas viene de comparaciones donde la relacional estaba sin índices o mal consultada. Con el mismo trabajo de afinado, la diferencia en proyectos normales es menor de lo que sugiere su reputación.
Las bases vectoriales y lo que realmente resuelven
Esta es la categoría que más ha crecido y también la peor entendida, porque llegó junto con el interés por la IA y quedó asociada a ella de una forma confusa.
Una base vectorial no entiende tus datos ni razona sobre ellos. Guarda representaciones numéricas de textos, imágenes o audio, generadas por un modelo, y sabe encontrar cuáles están cerca de otra representación. Eso es todo, y es bastante.
El uso habitual es responder preguntas sobre documentos propios: se parte el material en fragmentos, se convierten en vectores y se guardan. Cuando llega una pregunta, se convierte igual y se buscan los fragmentos más cercanos.
Esos fragmentos se le pasan al modelo de lenguaje como contexto, para que responda con material real en lugar de inventar. La base vectorial es el buscador, no el que responde.
La consecuencia práctica más importante es esta: si tu proyecto no necesita buscar por significado, no necesita una base vectorial, por mucho que use IA. Una aplicación que llama a un modelo para redactar textos o clasificar mensajes no requiere nada de esto.
Y cuando sí hace falta, conviene empezar por la extensión del motor que ya tienes. Para volúmenes de miles o decenas de miles de fragmentos, que es donde está la mayoría de los casos reales, funciona sin añadir un servicio aparte.
Las tres, comparadas donde importa
| Relacional | Documentos | Vectorial | |
|---|---|---|---|
| Busca por | Valores exactos y relaciones | Clave del documento | Cercanía de significado |
| La respuesta es | Exacta | Exacta | Aproximada y ordenada |
| Cruzar datos | Su especialidad | Incómodo, se hace en código | No aplica |
| Forma de los datos | Fija, definida por el esquema | Libre, distinta por registro | Vectores generados por un modelo |
| Preguntas no previstas | Se pueden hacer | Cuestan trabajo | No aplica |
| Coherencia entre datos | La garantiza el motor | La escribe el equipo | No aplica |
| Caso típico | Facturación, inventario | Catálogos, perfiles, eventos | Buscar en documentos propios |
La fila de la coherencia es la que más consecuencias tiene a largo plazo. Cuando el motor no la garantiza, aparecen con el tiempo registros huérfanos y contradicciones que nadie sabe cuándo se produjeron, y arreglarlos exige escribir procesos de limpieza que no estaban previstos.
Lo que de verdad decide el rendimiento
Hay una idea muy extendida y bastante equivocada: que la elección de motor determina lo rápido que irá el sistema. En proyectos normales, el motor casi nunca es el factor decisivo.
Lo que decide es si las consultas usan índices, cuántas veces se consulta por operación y cuánta información se pide de más. Una consulta sin índice sobre un millón de filas tarda segundos en cualquier motor, relacional o no. Y una pantalla que hace doscientas consultas pequeñas será lenta aunque cada una tarde un milisegundo.
Ese segundo caso es el más frecuente cuando el código lo escribe una herramienta que no ve el conjunto. Se pide una lista, y después, dentro de un bucle, se piden los datos de cada elemento uno por uno. El resultado funciona perfectamente con veinte registros de prueba y se cae con dos mil reales.
Detectarlo no requiere herramientas especiales: basta con contar cuántas consultas genera una sola carga de página. Si el número crece con la cantidad de elementos mostrados, ahí está el problema, y cambiar de motor no lo va a arreglar.
Cómo saber cuándo un dato necesita otro sitio
Antes de añadir un almacén nuevo conviene una comprobación honesta, porque la tentación de repartir llega casi siempre antes que la necesidad.
- Mide la consulta que te preocupa. Si tarda demasiado, mira primero si usa índice. Un porcentaje alto de los casos que motivan un cambio de motor se resuelven con un índice bien puesto.
- Comprueba el volumen real, no el imaginado. Las decisiones sobre escala se toman con cifras hipotéticas que rara vez llegan. Cien mil filas no son muchas para ninguna base moderna.
- Separa lo que es lento de lo que es frecuente. Un informe pesado que se ejecuta una vez al día no justifica rediseñar nada: justifica ejecutarlo fuera de hora.
- Pregúntate si el dato cabe en el motor actual. Guardar una estructura variable en una columna de tipo documento dentro de una base relacional resuelve la mayoría de los casos sin añadir nada.
Cuando después de todo eso sigue habiendo un problema real y medido, la decisión de sumar un almacén tiene fundamento y se puede defender. Antes, es una preferencia disfrazada de arquitectura.
El costo de operar cada uno
La comparación técnica suele terminar en las funciones, y el gasto que más pesa a lo largo del tiempo es otro: lo que cuesta mantener cada motor en marcha.
Cada base añadida trae su propia copia de seguridad, que hay que probar restaurando; su monitoreo, para enterarse cuando falla; sus credenciales, que hay que rotar y guardar; sus actualizaciones de versión, que a veces rompen cosas; y su forma particular de fallar, que alguien tiene que aprender.
En un equipo con personal dedicado a datos, esa carga se reparte. En un proyecto de una o dos personas, cada motor adicional compite directamente con el tiempo de construir el producto, y esa cuenta rara vez aparece en la comparativa que llevó a elegirlo.
Por eso la pregunta final no es cuál es mejor para este caso, sino cuántos motores puede sostener este equipo sin descuidarlos. Para la mayoría, la respuesta honesta es uno.
El error de combinar tres motores desde el principio
Una arquitectura con una relacional para las transacciones, una de documentos para el catálogo y una vectorial para la búsqueda suena completa y bien pensada. En un proyecto pequeño es casi siempre un error.
El costo no está en montarlo, que hoy es rápido. Está en que el mismo dato acaba viviendo en dos sitios y hay que mantenerlos sincronizados. Cuando se actualiza un producto, hay que actualizar también su copia y su vector, y cada uno de esos pasos puede fallar por separado.
Ese es exactamente el problema de la doble escritura: la operación principal funciona, la secundaria falla, y nadie se entera hasta que alguien nota que la búsqueda devuelve información vieja.
Por eso la recomendación práctica es tener un solo lugar donde vive la verdad, y tratar cualquier otro almacén como una copia derivada que se puede reconstruir desde cero. Si la búsqueda se estropea, se regenera; si la verdad se estropea, se perdió algo.
Qué preguntar cuando la propone una IA
Pedirle a un modelo una arquitectura de datos tiende a producir una respuesta más ambiciosa de lo necesario, con varios almacenes especializados, porque es el patrón que más aparece en la documentación reciente.
La pregunta que corrige eso es directa: qué problema concreto de los míos no resuelve una sola base relacional. Si la respuesta es vaga o se apoya en escalar en el futuro, la respuesta honesta es que todavía no hace falta.
La segunda pregunta es sobre la sincronización. Si la propuesta guarda el mismo dato en dos sitios, hay que saber quién lo actualiza, en qué orden y qué pasa si el segundo paso falla. Si esa respuesta no existe, el diseño tiene un fallo que aparecerá en producción.
Y una tercera que ahorra dinero: si la propuesta incluye una base vectorial, conviene preguntar cuántos documentos se esperan realmente. Por debajo de cierto volumen, la extensión del motor que ya tienes hace lo mismo sin sumar un servicio, sus credenciales y su factura.