La conversación típica con un asistente para una funcionalidad mediana dura once o doce vueltas. La primera respuesta se acerca, la segunda arregla una cosa y rompe otra, la sexta reescribe algo que ya estaba bien, y en la novena nadie recuerda cuál era exactamente el comportamiento esperado.
Escribir la especificación antes es la respuesta que se propone para eso. A veces resuelve el problema de raíz y a veces se convierte en un documento de dos mil palabras que nadie vuelve a abrir. Conviene saber distinguir los dos casos antes de empezar.
Qué es una especificación en este contexto
No hablamos de un documento formal de requisitos ni de un diagrama UML. En la práctica, una especificación útil para trabajar con un asistente es un texto corto que fija tres cosas.
Primero, el comportamiento esperado, en términos de entradas y salidas: qué recibe, qué devuelve, qué hace en los casos límite. No cómo se implementa, sino qué se observa desde fuera.
Segundo, las restricciones que el código no puede inventar: qué tabla se toca, qué formato tiene la respuesta, qué pasa con los permisos, qué no se debe cambiar.
Tercero, el criterio de aceptación: la lista concreta de casos que deben cumplirse para dar la tarea por terminada.
Con eso suele bastar entre veinte y sesenta líneas. Si el documento crece mucho más, normalmente es que está describiendo implementación en lugar de comportamiento, y entonces empieza a envejecer al primer cambio.
Por qué cambia la dinámica de la conversación
La diferencia no está en la primera respuesta, que suele ser parecida con o sin especificación. Está en lo que ocurre cuando el resultado no sirve.
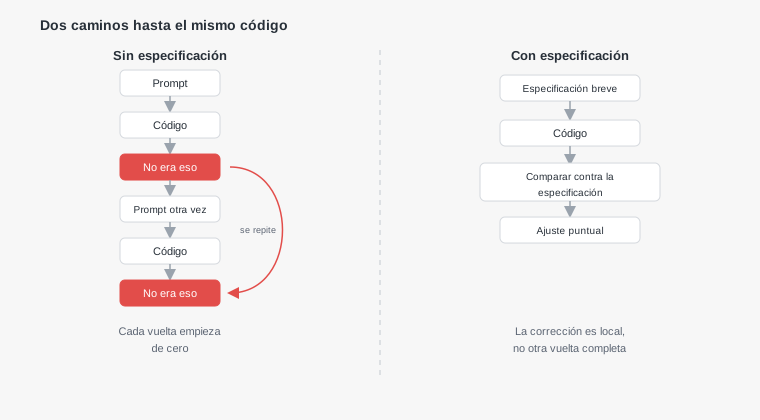
Sin especificación, la corrección se formula como una impresión: "no, no era eso", "hazlo más simple", "te olvidaste de un caso". El modelo no tiene contra qué contrastar, así que reinterpreta el encargo entero y devuelve una solución nueva. Es habitual que en esa reescritura se pierda algo que ya funcionaba.
Con especificación, la corrección se formula señalando un punto: "el caso tres de la lista devuelve el error equivocado". El cambio necesario es local, y el resto no se toca.
El efecto acumulado es el que importa: pasas de una conversación que diverge a una que converge. No porque el modelo sea mejor, sino porque hay un punto fijo contra el que comparar.
La especificación te obliga a decidir antes
Hay un beneficio que aparece antes de escribir una sola línea de código, y para muchos es el principal.
Al escribir qué debe pasar cuando llega una petición con un identificador que no existe, tienes que decidirlo. Sin ese paso, la decisión la toma el modelo, casi siempre por omisión y casi siempre con la opción más común, que puede no ser la tuya.
Las preguntas que la especificación fuerza a responder son casi siempre las mismas: qué pasa si el recurso no existe, qué pasa si el usuario no tiene permiso, qué pasa con los valores vacíos o nulos, qué ocurre si la operación se repite, y qué se devuelve exactamente cuando algo falla.
Ese conjunto de decisiones es el diseño real de la funcionalidad. Escribirlo cuesta diez minutos y ahorra la mayoría de las vueltas posteriores.
Cuándo compensa escribirla
Hay un patrón bastante claro en los casos donde el esfuerzo se recupera con creces.
Compensa cuando hay reglas de negocio con casos límite: cálculos de precios, descuentos, prorrateos, estados que transicionan. Son cosas donde el error no es visible y la especificación es exactamente la lista de casos.
Compensa cuando el resultado tiene que encajar con algo que ya existe: una API que otros consumen, un formato de archivo, un contrato con un servicio externo. La especificación es la forma de decirle al modelo lo que no puede inventar.
Compensa cuando la tarea la va a continuar otra persona, o tú mismo dentro de tres semanas. El documento sobrevive a la conversación, que no se guarda.
Y compensa mucho cuando ya has dado tres vueltas sin acertar. En ese punto, parar y escribir qué debe hacer exactamente suele resolver en un intento lo que llevaba media hora sin salir.
Cuándo es teatro
El reverso es igual de reconocible, y conviene admitirlo porque el exceso de proceso también tiene coste.
Es teatro cuando la tarea es más corta que su especificación. Describir en quince líneas una función de treinta que además es obvia no aporta nada; el código es la especificación.
Es teatro cuando el documento describe implementación. Si dice qué clases crear y qué métodos tendrán, no estás especificando, estás programando en prosa, con la desventaja de que la prosa no compila ni se ejecuta.
Es teatro cuando nadie la va a leer después. Una especificación que se escribe, se usa para generar el código y se abandona sin actualizar se convierte en un documento que miente, y un documento que miente es peor que ninguno.
Y es teatro cuando todavía no sabes qué quieres. En exploración, escribir una especificación detallada fija decisiones que aún no tienes información para tomar. Ahí es mejor hacer un prototipo, tirarlo, y escribir la especificación después con lo aprendido.
La forma que mejor funciona: casos, no prosa
De todos los formatos posibles, el que menos envejece y más directamente se traduce en verificación es una lista de casos concretos.
En lugar de escribir que el sistema debe validar correctamente las fechas del periodo, se escriben los casos: fecha de inicio posterior a la de fin, error concreto; periodo de más de un año, error concreto; fecha de inicio en el pasado, permitido.
# Reserva de sala: crear

## Entrada
POST /reservas  { sala_id, inicio, fin, usuario_id }

## Casos
1. Sala libre en ese rango           -> 201, devuelve la reserva creada
2. Sala ocupada, solape parcial      -> 409, codigo "sala_ocupada"
3. inicio >= fin                     -> 422, codigo "rango_invalido"
4. Duracion mayor de 4 horas         -> 422, codigo "duracion_excedida"
5. sala_id inexistente               -> 404
6. Usuario sin permiso sobre la sala -> 403
7. Misma peticion repetida           -> 201 con la reserva ya existente, sin duplicar

## Restricciones
- No modificar la tabla salas
- Las horas se guardan en UTC
- El solape se calcula en la base, no en memoria
Esa lista tiene dos propiedades útiles. Es corta, así que se lee entera. Y se convierte en pruebas casi de forma mecánica: cada caso es un test con su nombre ya escrito.
La restricción final, sobre dónde se calcula el solape, es el tipo de detalle que un modelo no puede adivinar y que determina si la solución aguanta con datos reales.
De la especificación a las pruebas, en un paso
Cuando los casos están numerados, el camino más eficiente no es pedir el código sino pedir primero las pruebas que reflejan esos casos.
Las revisas, que es rápido porque son afirmaciones cortas y directas, y una vez aceptadas se convierten en el criterio. A partir de ahí, la implementación tiene una condición objetiva de éxito.
# 1. generar las pruebas desde la lista de casos y comprobar que fallan
npm test -- reservas.test.js
# esperado: 7 fallos, uno por caso

# 2. pedir la implementacion

# 3. el mismo comando decide si la tarea esta hecha
npm test -- reservas.test.js
El paso uno no es una formalidad. Una prueba que pasa antes de existir la implementación está mal escrita, y es un error frecuente cuando las pruebas se generan automáticamente.
Guardar la especificación junto a las pruebas, en el mismo directorio, ayuda a que las dos se actualicen a la vez.
Dónde vive la especificación
Un detalle práctico que decide si el documento sobrevive o no: dónde se guarda.
Si vive en un chat, muere con el chat. Si vive en una herramienta aparte, se desincroniza del código en la primera semana. Lo que funciona es guardarla en el repositorio, junto al código que describe, de forma que un cambio en el comportamiento y un cambio en la especificación entren en el mismo commit.
# Un archivo por funcionalidad, junto a su codigo
docs/specs/reservas-crear.md

# Entra en el mismo commit que el cambio de comportamiento
git add docs/specs/reservas-crear.md src/reservas/ tests/reservas.test.js
git commit -m "reservas: rechazar duraciones de mas de 4 horas"

# Ver como evoluciono una regla concreta a lo largo del tiempo
git log -p --follow docs/specs/reservas-crear.md
Ese último comando es la razón de fondo para tenerla versionada. Dentro de un año, la pregunta que aparece no es qué hace el código, que se lee, sino por qué se decidió así, y el historial de la especificación lo responde.
El error de especificar la implementación
Es el fallo más común cuando alguien empieza a escribir especificaciones, y tiene una causa entendible.
Al escribir, uno ya está pensando en cómo lo haría, y se cuela: "crear un servicio ReservaService con un método validarSolape que consulte el repositorio". Eso no es comportamiento observable, es una decisión de estructura.
El problema práctico aparece al mantenerla. Si la implementación cambia, y cambiará, la especificación queda desfasada aunque el comportamiento sea idéntico. A la tercera vez que ocurre, deja de actualizarse.
La prueba para detectarlo es sencilla: si al leer una línea no sabrías cómo comprobarla desde fuera del sistema, no es especificación.
Especificaciones para modificar, no solo para crear
Casi todo lo que se escribe sobre esto asume que se parte de cero, y la mayor parte del trabajo real es modificar algo existente. El formato cambia.
Para un cambio, la especificación útil tiene tres partes: qué hace hoy, qué debe hacer después, y qué no debe cambiar. La tercera es la más importante y la que casi nunca se escribe.
## Hoy
Al cancelar una reserva se borra la fila.

## Despues
Al cancelar se marca estado = "cancelada" y se guarda cancelada_en.

## No debe cambiar
- El endpoint sigue devolviendo 204
- Las reservas canceladas no aparecen en GET /reservas
- El calculo de disponibilidad las ignora igual que antes
Ese apartado de lo que no debe cambiar es lo que evita el efecto lateral típico: el cambio pedido se hace bien y de paso se altera algo que nadie mencionó porque parecía mejorable.
Cuánto detalle es suficiente
La pregunta práctica no es si escribir especificación sino cuánta, y hay una regla que funciona razonablemente.
Escribe hasta el punto en que otra persona con tu mismo contexto técnico llegaría a la misma solución. Ni más ni menos. Si dos personas competentes pueden leer el documento y construir cosas incompatibles, falta detalle. Si el documento describe decisiones que no importan, sobra.
En la práctica, para una funcionalidad de un día de trabajo, eso suele caer entre treinta y sesenta líneas. Para un cambio pequeño, cinco líneas y tres casos.
Y hay un límite superior útil: si escribir la especificación va a costar más que escribir el código, escribe el código.
Qué se le escapa a una IA con esto
Pedirle a un asistente que genere la especificación produce un documento de aspecto profesional con un problema de fondo.
Rellena los huecos en lugar de señalarlos. Donde tú no has decidido qué pasa si el usuario no tiene permiso, escribe la opción más común y la presenta con el mismo tono que las decisiones que sí tomaste tú. El documento queda completo y una parte es inventada.
Tiende también a la exhaustividad decorativa: apartados de objetivos, alcance y consideraciones de rendimiento que no dicen nada específico y que hacen que nadie lea el documento entero.
Y no distingue lo negociable de lo que no. Para él, que la respuesta sea 409 o 422 y que las horas se guarden en UTC tienen el mismo peso, cuando la segunda es una restricción dura y la primera es una convención.
La forma productiva de usarlo aquí es al revés: escribe tú los casos, pásaselos y pídele que enumere los casos límite que faltan y las ambigüedades que encuentra, sin resolverlas. Esa lista de preguntas es más valiosa que cualquier documento que genere solo.