Existe una creencia muy extendida sobre las redes internas: que lo que ocurre dentro está a salvo. Es la idea de que hay un perímetro, que el peligro está fuera y que, una vez dentro, los servicios pueden hablar entre sí sin ceremonia.
Esa idea dejó de sostenerse hace tiempo, y no por una moda de la industria. Se cayó porque los incidentes reales siguen un patrón que la contradice: el atacante rara vez ataca el servicio importante de frente. Entra por algo menor, un componente olvidado, una credencial filtrada, una dependencia comprometida, y desde ahí se mueve tranquilamente hacia lo que le interesa, porque dentro nadie le pide identificación.
Qué significa que la red no sea de confianza
El principio que sustituyó al perímetro se resume en una frase incómoda: la ubicación de quien llama no dice nada sobre si debería poder llamar.
Que una petición venga de la red interna no significa que la haya hecho un servicio legítimo. Puede venir de un contenedor comprometido, de una máquina de desarrollo mal configurada o de un componente que alguien levantó para una prueba y olvidó apagar.
La consecuencia práctica es que cada servicio debe verificar quién le habla, igual que verifica a un usuario, y no dar nada por supuesto por el hecho de estar dentro. Es más trabajo, y es lo que impide que un fallo pequeño se convierta en un incidente completo.
Conviene decir también lo contrario, porque este terreno se presta a la sobreingeniería: un proyecto con una sola aplicación y una base de datos no necesita nada de esto. Lo que necesita es que la base de datos no esté expuesta a internet, que es una medida mucho más simple y la que de verdad falta en la mayoría de los casos.
Cifrar y demostrar quién eres
Cuando sí hay varios servicios hablando entre sí, hay dos problemas distintos que suelen confundirse en uno solo.
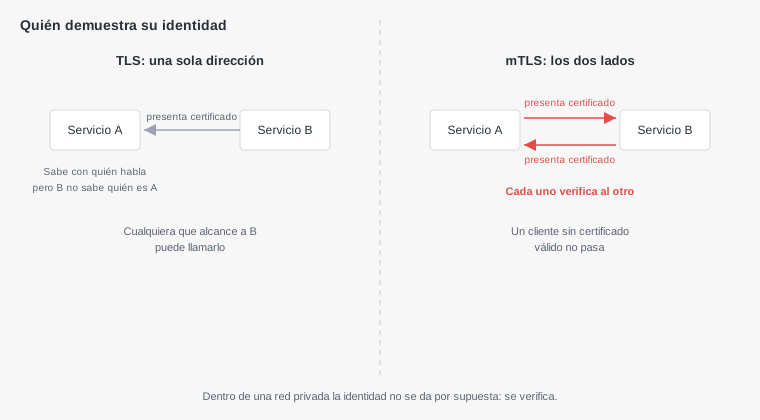
El cifrado resuelve que nadie pueda leer ni alterar lo que viaja. Es lo que hace el protocolo seguro habitual, el mismo del navegador, y hoy no hay excusa para no usarlo también en las comunicaciones internas: la idea de que dentro de la red privada se puede ir en claro asume que nadie más está en esa red.
La identidad es el otro problema, y el cifrado por sí solo no lo resuelve. En la forma habitual, solo el servidor demuestra quién es. El cliente permanece anónimo, así que cualquiera que alcance al servicio puede llamarlo.
El mecanismo que cierra ese hueco es la verificación mutua: cada lado presenta su propio certificado y verifica el del otro. Un servicio sin certificado válido no llega ni a plantear su petición, lo que elimina categorías enteras de movimiento lateral.
Lo que hay que sostener para que funcione
La verificación mutua tiene un costo que rara vez se menciona y que conviene conocer antes de adoptarla, porque no está en montarla sino en mantenerla.
Cada servicio necesita su propio certificado, y esos certificados caducan. Si caducan sin que nadie lo note, la comunicación se corta de golpe, y es de esas caídas que desconciertan porque no hubo ningún despliegue ni ningún cambio.
Hace falta además una autoridad propia que los emita, un procedimiento para distribuirlos a cada servicio y una forma de revocar el de un servicio comprometido. Todo eso es trabajo de operación continuo.
Por eso la recomendación honesta para un equipo pequeño es no montarlo a mano. Si la plataforma donde se ejecuta lo ofrece de forma automática, activarlo es razonable; si hay que construir la infraestructura de certificados desde cero para tres servicios, el esfuerzo casi nunca compensa frente a alternativas más simples.
La alternativa razonable para proyectos pequeños
Antes de llegar a certificados por servicio, hay medidas que cubren buena parte del riesgo con mucho menos mantenimiento, y son las que faltan en la mayoría de los sistemas reales.
- Que nada interno esté accesible desde internet. Es la medida más básica y la más incumplida: bases de datos, paneles de administración y servicios internos expuestos por una configuración por defecto que nadie revisó.
- Un secreto compartido por cada par de servicios. Que quien llama se identifique con una credencial propia, distinta para cada origen, y que el receptor la verifique. Es simple y ya distingue quién llama.
- Tokens firmados de vida corta. Cuando hay varios servicios, un token emitido por un componente central y verificado por los demás evita repartir secretos por pares.
- Reglas de red explícitas. Que el servicio de facturación solo acepte conexiones del servicio que debe llamarlo, y de ningún otro.
Esa última medida es la que mejor relación tiene entre esfuerzo y protección, porque no depende de que la aplicación haga nada bien: si la conexión no está permitida, ni siquiera se establece.
La puerta de entrada y lo que no resuelve
Cuando hay varios servicios, es común poner una pieza delante que recibe todo el tráfico externo y lo reparte. Concentra ahí la autenticación, el límite de peticiones y el registro, lo que evita repetirlos en cada servicio.
Es una buena idea y tiene un efecto secundario que produce incidentes: como esa pieza ya verificó al usuario, los servicios de detrás tienden a asumir que cualquier petición que les llega viene de ahí y está verificada.
El problema es que casi nunca se comprueba. Si alguien alcanza directamente a un servicio interno, se salta toda la verificación de una sola vez, y lo hace sin dejar rastro en los registros de la puerta de entrada.
La corrección es doble: que los servicios internos no sean alcanzables salvo desde la puerta, y que aun así verifiquen la identidad de quien les llama. La primera es una regla de red y la segunda una comprobación en el código, y hacen falta las dos porque cada una cubre el fallo de la otra.
Desde dentro de la red, llama directamente a un servicio interno saltándote la puerta de entrada, sin credencial ninguna.
Si responde con datos, acabas de encontrar el camino que usaría cualquiera que consiga entrar por el componente más débil del sistema.
Las credenciales entre servicios también caducan
Hay un detalle operativo que decide si todo lo anterior sobrevive al primer año: las credenciales que usan los servicios para hablar entre sí no suelen rotarse nunca.
Se generan al montar el sistema, se copian en la configuración de cada servicio y se quedan ahí. Al cabo de dos años nadie recuerda cuántas copias existen, ni quién tuvo acceso a ellas, ni si alguna acabó en un repositorio o en un mensaje de chat.
La forma de que la rotación sea posible es que cada servicio lea su credencial en tiempo de ejecución de un sitio central, en lugar de tenerla escrita en su configuración. Así cambiarla es una operación en un solo lugar.
La prueba de si eso está bien montado es directa: preguntarse cuánto costaría cambiar hoy la credencial que usa un servicio para hablar con otro. Si la respuesta implica tocar varios sitios y reiniciar cosas con cuidado, la rotación no va a ocurrir nunca, y una credencial que nunca cambia es una credencial que acaba filtrándose.
Los permisos entre servicios también se reparten de más
Hay un descuido que convierte un incidente pequeño en uno grande, y no tiene que ver con la identidad sino con lo que se permite hacer una vez identificado.
Lo habitual, cuando se monta la comunicación entre dos servicios, es dar al que llama una credencial con acceso amplio, porque es lo rápido y porque en ese momento no está claro qué va a necesitar. Esa credencial se queda así para siempre.
El resultado es que un servicio de notificaciones, cuya única función es enviar correos, tiene permiso para leer la tabla de clientes y escribir en la de pedidos. Si ese servicio, que suele ser el menos vigilado, se compromete, el atacante hereda todo ese alcance.
La corrección es dar a cada servicio exactamente lo que usa y nada más. Conviene revisarlo una vez, con la lista de operaciones que realmente ejecuta delante, y recortar el resto. Es un ejercicio de media hora que reduce mucho el daño posible.
La pregunta que ordena esta revisión es concreta: si este servicio quedara en manos de alguien más, ¿qué podría hacer con sus credenciales? Cuando la respuesta incluye cosas que ese servicio nunca hace, ahí está el exceso que hay que quitar.
Cuando algo falla, saber por dónde pasó
Verificar la identidad entre servicios tiene un beneficio que no es de seguridad y que suele ser el que convence a quien duda: hace posible el diagnóstico.
En un sistema donde cualquiera puede llamar a cualquiera sin identificarse, reconstruir qué ocurrió durante un incidente consiste en cruzar marcas de tiempo y hacer conjeturas. No hay forma de saber qué servicio originó una operación concreta.
Cuando cada llamada lleva la identidad de quien la hace, esa pregunta tiene respuesta directa. Y si además se arrastra un identificador común por toda la cadena, se puede seguir una operación completa desde que entró hasta donde se rompió.
Ese identificador es probablemente lo más rentable de todo este artículo para un equipo pequeño: cuesta muy poco añadirlo, no requiere ninguna infraestructura y transforma la depuración de un sistema con varias piezas.
Qué se le escapa a una IA con esto
Pedir que se comuniquen dos servicios produce, con mucha fiabilidad, código que funciona y que no verifica nada: una llamada directa, sin credencial, sin cifrado interno y con la suposición implícita de que la red es segura.
No es un descuido del modelo. Es que la petición era conectar dos servicios, y eso es exactamente lo que devuelve. La identidad de quien llama no se mencionó, así que no aparece.
La frase que cambia la respuesta es pedir que el servicio receptor verifique quién le está llamando y rechace lo que no reconozca. Con eso aparecen la credencial, la comprobación y el manejo del caso en que falta.
Y conviene pedir siempre qué ocurre cuando la verificación falla. Un sistema que ante una credencial inválida deja pasar la petición igualmente, porque el error no se maneja, es indistinguible de uno sin ninguna protección, con el agravante de que nadie lo va a revisar porque parece resuelto.