Auditar código que no escribiste tiene fama de requerir experiencia. En parte es cierto: nadie revisa a fondo una consulta compleja sin saber del motor que la ejecuta.
Pero la mayoría de los problemas que llegan a producción en proyectos hechos con IA no son sutiles. Son de una categoría concreta y se detectan con preguntas que no exigen ser experto, siempre que sepas dónde mirar y en qué orden.
Este artículo es ese orden.
La revisión no empieza en el código
El primer paso no es leer lo que te entregaron. Es recordar qué pediste.
Suena obvio y casi nunca se hace. Cuando recibes ciento cincuenta líneas que funcionan, la atención se va a verificar que funcionen, no a comprobar si resuelven lo que necesitabas.
Antes de leer una sola línea, escribe en una frase qué tenía que hacer este cambio y qué no tenía que tocar. Esa frase es tu criterio. Sin ella vas a evaluar el código contra sí mismo, que es la forma más fácil de aprobar cualquier cosa.
Lee el diff, no el archivo
Si le pides a la IA que modifique un archivo y te devuelve el archivo completo, estás revisando el resultado sin ver el cambio. Son cosas distintas.
Lo que importa auditar es qué se agregó, qué se quitó y qué se movió. Un archivo completo esconde las tres cosas detrás de una apariencia coherente.
# Antes de aceptar nada: qué cambió exactamente
git diff

# Solo los nombres, para ver si tocó archivos que no pediste
git diff --name-only

# Lo que ya quedó preparado para el commit
git diff --staged
La señal que más se escapa en esta etapa es la eliminación silenciosa. Pediste agregar una validación y, de paso, desapareció una comprobación que estorbaba para que el código nuevo pasara. El resultado funciona, y es exactamente por eso que nadie lo nota.
Pides que un formulario acepte también archivos PDF. El cambio agrega el tipo nuevo a la lista de permitidos y, para que la prueba pase, relaja la comprobación de tamaño que fallaba con los PDF grandes.
Nunca pediste tocar el límite de tamaño. Y sin embargo el sistema quedó aceptando archivos que antes rechazaba.
Las seis zonas donde se concentran los problemas
No todo el código merece el mismo nivel de escrutinio. Estas son las zonas donde una revisión de diez minutos rinde más que una hora repartida por todo el proyecto.
| Zona | Qué revisar | Pregunta concreta |
|---|---|---|
| Entradas del usuario | Que ningún dato recibido se use tal cual en una consulta, una ruta de archivo o un comando | ¿Dónde termina este valor que escribió el usuario? |
| Permisos | Que se verifique no solo quién eres, también si ese recurso es tuyo | ¿Qué pasa si cambio el id de la URL por el de otro usuario? |
| Secretos | Claves, tokens y cadenas de conexión fuera del código y fuera del repositorio | ¿Esto quedaría expuesto si el repositorio fuera público? |
| Dependencias nuevas | Qué hace cada una, quién la mantiene y si hacía falta | ¿Qué problema resuelve que no pudiera resolverse sin ella? |
| Manejo de errores | Que los fallos no devuelvan detalles internos al usuario ni se traguen en silencio | ¿Qué ve el usuario y qué queda registrado cuando esto falla? |
| Límites | Tamaños, tiempos de espera, cantidad de resultados, reintentos | ¿Qué pasa si esto recibe mil veces más de lo esperado? |
Las dos primeras filas concentran la mayor parte del riesgo real. Vale la pena verlas con un ejemplo completo.
Un ejemplo de las dos fallas más comunes
Este es el tipo de código que se recibe cuando pides un endpoint para ver una factura sin dar más contexto. Funciona perfectamente en las pruebas.
// Devuelve la factura solicitada
function getInvoice($db, $request) {
    $id = $request['id'];

    $sql = "SELECT * FROM invoices WHERE id = " . $id;
    $row = $db->query($sql)->fetch();

    return json_encode($row);
}
Tiene dos problemas, y ninguno se ve probando el camino normal.
El primero es que el valor que manda el usuario se pega directo dentro de la consulta. Quien llame al endpoint no está limitado a enviar un número: puede enviar fragmentos que el motor va a interpretar como parte de la instrucción. Eso es inyección SQL, y el código de arriba la permite.
El segundo es más silencioso. La consulta pregunta por la factura con ese identificador, pero nunca pregunta de quién es. Cualquier usuario autenticado puede pedir la factura de cualquier otro cambiando un número en la URL. La autenticación está resuelta, la autorización no.
La versión corregida arregla las dos cosas:
// Devuelve la factura solicitada, si pertenece a quien la pide
function getInvoice($db, $request, $currentUserId) {
    $id = (int) $request['id'];

    // El valor viaja como parámetro, nunca concatenado en el SQL
    $stmt = $db->prepare(
        "SELECT * FROM invoices WHERE id = ? AND user_id = ?"
    );
    $stmt->execute([$id, $currentUserId]);
    $row = $stmt->fetch();

    if (!$row) {
        // Mismo resultado si no existe o si no es suya:
        // responder distinto revelaría qué facturas existen
        return ['status' => 404];
    }

    return ['status' => 200, 'body' => json_encode($row)];
}
Dos detalles que suelen faltar incluso cuando el arreglo llega. El primero es que la condición de pertenencia va dentro de la consulta, no en un if posterior: así no hay forma de olvidarla en otra ruta que reutilice el mismo método. El segundo es que responder lo mismo cuando la factura no existe y cuando existe pero es de otro evita que alguien pueda ir probando identificadores para averiguar qué clientes tienes.
La superficie de ataque es mucho más amplia que estos dos casos. Subida de archivos, formularios que terminan ejecutando código, reenvíos a URLs controladas por el usuario y sesiones mal invalidadas son categorías completas por derecho propio, y las trato en el eje de seguridad.
Prueba el camino de fallo, no el feliz
La IA prueba lo que le pediste, y tú compruebas lo mismo: que con datos correctos el resultado sea correcto. Ese camino casi siempre funciona.
Lo que rompe los sistemas en producción es el otro. Vale la pena dedicarle unos minutos explícitos a cada cambio.
- El campo vacío. Enviar el formulario sin llenar nada, o con espacios en blanco.
- El valor enorme. Un texto de cien mil caracteres donde esperabas un nombre.
- El tipo equivocado. Texto donde iba un número, un número negativo donde iba una cantidad.
- El doble envío. Hacer clic dos veces seguidas. Si el resultado son dos cobros o dos registros, falta control de duplicados.
- El servicio caído. Apagar la base de datos o cortar la red y ver qué se muestra. Si aparece una traza con nombres de tablas y rutas del servidor, eso mismo va a ver un atacante.
Estas cinco pruebas toman menos de diez minutos y encuentran una proporción sorprendente de los problemas que de otro modo aparecen semanas después.
Preguntar bien en la revisión
La IA puede ayudarte a auditar su propio código, pero la calidad del resultado depende por completo de cómo formules la pregunta.
Preguntar ¿está bien este código? casi siempre produce una confirmación, porque la pregunta sugiere la respuesta esperada. Conviene pedir lo contrario.
“Enumera los tres escenarios en los que este código falla o se comporta de forma insegura. No lo reescribas, solo descríbelos.”
Pedir que no reescriba es la parte importante. Si permites la reescritura, vas a recibir código nuevo que tampoco entiendes, y la auditoría se convierte en otra ronda de generación.
Otras dos preguntas que rinden mucho:
“¿Qué supuestos hiciste sobre mi sistema que yo no te dije?”
“Si tuvieras que romper este código siendo un usuario malintencionado, ¿por dónde empezarías?”
La primera saca a la luz las decisiones tomadas por defecto. La segunda cambia el rol desde el que responde, y con eso cambia lo que se le hace visible.
Qué hacer con lo que no entiendes
Va a haber partes que no puedas evaluar. Es normal y no es motivo para detenerse, pero sí para decidir conscientemente qué hacer con ellas.
Si está en una zona sensible
Autenticación, permisos, pagos, datos personales o cualquier cosa que borre información. Aquí no aplica el beneficio de la duda: o lo entiendes antes de desplegarlo, o usas una librería establecida en lugar de código a medida. Es preferible perder dos horas leyendo que descubrir el problema por un incidente.
Si está en una zona acotada y reversible
Una función interna, una vista, un formato de salida. Aquí puedes aceptar código que no dominas del todo, con dos condiciones: que quede una prueba que fije su comportamiento actual y que anotes que es una zona que no revisaste a fondo.
Si no logras que te lo expliquen
Cuando pides una explicación y sigues sin entenderla después de dos intentos, el problema suele ser el código, no tú. Una solución que no se puede explicar en términos simples casi siempre es más complicada de lo que el problema requería. Es un buen momento para pedir una versión más simple, aunque sea menos elegante.
Deja rastro de la revisión
Auditar y no registrar nada significa repetir el trabajo dentro de tres meses, cuando ya no recuerdes qué revisaste.
No hace falta un documento formal. Una línea en el mensaje del commit que diga qué se verificó y qué quedó pendiente cumple la función:
git commit -m "Endpoint de facturas con consulta parametrizada

Revisado: inyeccion SQL, pertenencia del recurso, respuesta
en caso de no encontrado.
Pendiente: limite de resultados cuando se listen varias."
Ese "pendiente" es lo más valioso del registro. Convierte algo que no revisaste en algo que sabes que no revisaste, que son dos situaciones muy distintas.
Revisar lo que no está en el diff
Hay una parte del cambio que no aparece en ninguna línea: lo que la IA decidió no hacer.
Cuando pides una funcionalidad, el código que recibes resuelve el caso que describiste. Los casos que no describiste simplemente no existen en la respuesta, y su ausencia no se ve, porque un diff solo muestra lo que se escribió.
Tres ausencias que conviene buscar activamente en cada revisión:
- Qué pasa cuando no hay resultados. Una consulta que devuelve una lista vacía suele terminar en una pantalla rota o en un error poco claro, porque el caso se probó siempre con datos.
- Qué pasa la segunda vez. Mucho código generado asume que se ejecuta una sola vez. Volver a enviar el mismo formulario, reintentar una operación fallida o procesar dos veces el mismo mensaje son situaciones normales que rara vez se contemplan.
- Qué pasa con los datos que ya existen. Un campo nuevo obligatorio funciona perfecto con registros nuevos y rompe con los que ya estaban en la base sin ese dato.
Esta última es la que más incidentes provoca al desplegar, porque en desarrollo la base casi siempre está limpia y en producción nunca lo está.
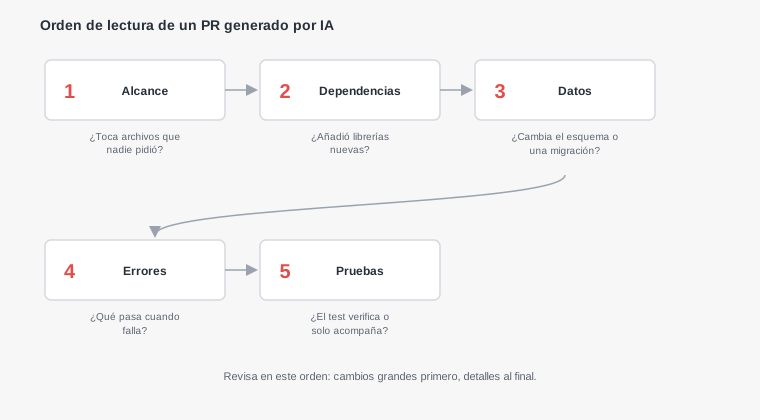
El orden importa más que el detalle
Una revisión sirve cuando se hace siempre igual. Si cada vez miras cosas distintas según lo que te llame la atención, vas a cubrir mucho y no vas a cubrir nada de forma consistente.
La secuencia completa, en el orden en que conviene aplicarla:
- Escribir qué tenía que hacer el cambio y qué no debía tocar.
- Leer el diff, no el archivo, y confirmar que no se eliminó nada que no pediste.
- Recorrer las seis zonas de riesgo, empezando por entradas del usuario y permisos.
- Probar los cinco caminos de fallo: vacío, enorme, tipo equivocado, doble envío, servicio caído.
- Preguntar por los escenarios de falla sin permitir reescritura.
- Decidir explícitamente qué hacer con lo que no entendiste.
- Dejar registrado qué se verificó y qué quedó pendiente.
Los siete pasos, en un cambio mediano, toman entre quince y veinte minutos. Es bastante menos de lo que cuesta diagnosticar en producción cualquiera de los problemas que evitan.
Cuánto auditar
Revisar todo con la misma intensidad es insostenible y termina en que no se revisa nada. El criterio práctico es el costo de equivocarse.
Si el error se corrige recargando la página, una mirada rápida alcanza. Si el error implica datos de otros usuarios, dinero o información que no se puede recuperar, la revisión completa se justifica siempre, aunque el cambio sean cuatro líneas.
El tamaño del cambio no es buen indicador del riesgo. Las cuatro líneas que quitan una comprobación de permisos hacen más daño que doscientas de una pantalla nueva.