Un formulario de contacto sin protección, un script sencillo y unas horas bastan para enviar decenas de miles de correos desde tu dominio. No hace falta vulnerar nada: el sistema hace exactamente lo que fue diseñado para hacer, muchas veces seguidas.
Ese es el tipo de problema que resuelve limitar el ritmo de peticiones, y es una de las pocas medidas de seguridad que además protege el bolsillo, porque buena parte de los abusos acaban en una factura antes que en una filtración.
Qué se está protegiendo en realidad
Conviene separar los tres daños distintos que evita, porque cada uno justifica un límite diferente.
El primero es la disponibilidad. Un cliente que hace mil peticiones por minuto, sea por malicia o por un bucle mal escrito, consume los recursos que necesitan los demás usuarios.
El segundo es el costo. En arquitecturas que cobran por ejecución o por operación, y en cualquier funcionalidad que llame a un servicio externo de pago, el abuso se traduce en dinero de forma inmediata y sin tope.
El tercero es el abuso funcional: probar contraseñas, enumerar usuarios, extraer el catálogo completo o usar tu formulario para enviar correo a terceros. Aquí el volumen no es un efecto secundario, es el método.
Esa tercera categoría es la que más se olvida y la que hace que esto sea un artículo de seguridad y no de rendimiento.
Tres límites distintos, tres abusos distintos
La forma en que se cuenta determina qué abuso se detiene, y aplicar un solo criterio deja huecos evidentes.
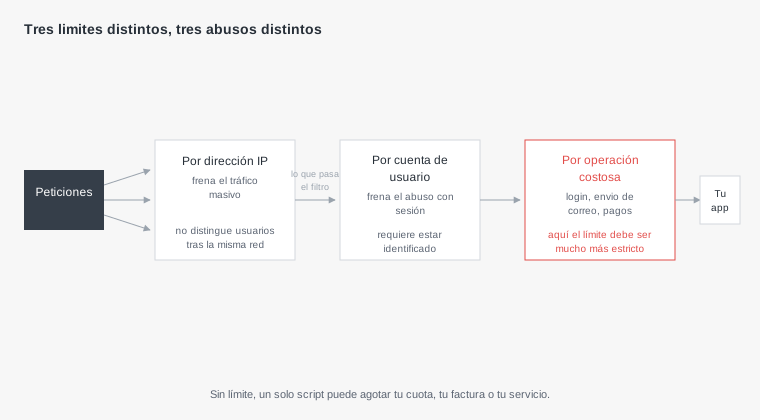
El límite por dirección de origen es el más fácil de aplicar y el más fácil de esquivar, porque cambiar de dirección es barato. Además castiga de más: una oficina entera o una red móvil comparten dirección, así que un límite estricto afecta a usuarios legítimos.
El límite por cuenta es más justo y más preciso, y tiene la limitación obvia de que solo funciona una vez identificado. No sirve para proteger el propio inicio de sesión.
Y el límite por operación es el que de verdad importa: no todas las rutas valen lo mismo. Consultar un listado es barato; intentar iniciar sesión, enviar un correo o generar un informe, no.
Dónde poner el esfuerzo primero
Aplicar un límite general a toda la API es lo más común y lo menos útil. Las rutas que justifican un tratamiento propio son pocas y siempre las mismas.
- El inicio de sesión. Aquí el límite debe contar por cuenta y no solo por origen, porque el ataque habitual prueba muchas contraseñas contra un usuario, o una contraseña filtrada contra muchos usuarios.
- Recuperación de contraseña y reenvío de verificación. Cada intento envía un correo, así que el abuso convierte tu servicio en una herramienta de hostigamiento y quema tu reputación de envío.
- Cualquier cosa que llame a un servicio de pago. Consultas a modelos de lenguaje, envío de mensajes, procesamiento de imágenes. Aquí el límite es lo único entre un script y tu factura.
- El registro de cuentas. Sin freno, alguien crea diez mil cuentas y el problema deja de ser técnico para volverse de limpieza de datos.
- Las búsquedas y los listados amplios. Son la vía habitual para extraer el contenido completo de un sitio.
Con esas cinco cubiertas se resuelve la mayor parte del abuso real en un proyecto pequeño, y ninguna exige infraestructura especial.
Cómo se cuenta, y por qué la ventana importa
La forma ingenua de contar produce un fallo curioso que conviene conocer antes de implementarlo a mano.
Si se cuentan las peticiones por minuto natural y el límite es cien, alguien puede hacer cien en el último segundo de un minuto y cien más en el primero del siguiente. Doscientas peticiones en dos segundos, respetando el límite.
Las soluciones establecidas resuelven esto de dos maneras. Una es una ventana que se desplaza continuamente en lugar de reiniciarse. La otra, más común en la práctica, es un depósito que se rellena a ritmo constante: cada petición consume una unidad, y cuando el depósito está vacío hay que esperar. Esa segunda forma tiene la ventaja de permitir ráfagas cortas sin castigar al usuario normal, que es justo el comportamiento deseable.
La recomendación práctica es no implementarlo a mano. Casi todos los marcos de trabajo, servidores web y redes de distribución lo traen resuelto, y una implementación propia suele tener el fallo de la ventana o el de no funcionar cuando hay varias instancias de la aplicación.
Si el contador vive en la memoria de cada instancia y hay tres instancias, el límite real es el triple del configurado.
Para que funcione de verdad, el contador tiene que ser compartido, y ahí es donde un almacén en memoria como Redis encuentra uno de sus usos más justificados.
Qué responder cuando se alcanza el límite
La respuesta correcta está estandarizada y aporta más de lo que parece, porque decide si un cliente legítimo se recupera solo o entra en un bucle.
El código de estado adecuado es el que indica demasiadas peticiones, acompañado de una cabecera que diga cuántos segundos hay que esperar. Un cliente bien escrito la lee y reintenta después; sin ella, reintenta de inmediato y empeora la situación.
Conviene además informar del estado antes de llegar al tope, con cabeceras que indiquen el límite, cuánto queda y cuándo se reinicia. Eso permite que una integración se autorregule en lugar de descubrir el límite chocando contra él.
Y hay una decisión de diseño con consecuencias de seguridad: en el inicio de sesión, la respuesta ante el límite no debe revelar si la cuenta existe. Un mensaje distinto para una cuenta real y una inventada convierte el propio mecanismo de protección en una forma de enumerar usuarios.
Cuando limitar no alcanza
Hay dos situaciones donde este mecanismo, por sí solo, no resuelve el problema, y conviene reconocerlas para no insistir en la herramienta equivocada.
La primera es un ataque distribuido con muchas direcciones distintas. Cada una hace pocas peticiones y ninguna cruza el límite, pero el volumen agregado tumba el servicio. Eso se mitiga por delante, en la red de distribución o el proveedor, no en la aplicación.
La segunda es el abuso lento y paciente: un script que extrae el catálogo entero a un ritmo por debajo del límite, durante semanas. Ahí lo que detecta el problema no es el contador sino el patrón, y la respuesta pasa por vigilar comportamientos raros más que por bajar el umbral.
En ambos casos, combinar el límite con otras medidas funciona mejor que endurecerlo: una verificación de humanidad en los puntos críticos, exigir cuenta para ciertas operaciones o introducir un retraso creciente ante intentos repetidos.
Distinguir al que abusa del que se equivocó
Un límite bien puesto va a golpear tarde o temprano a alguien que no hacía nada malo, y cómo se maneje ese caso decide si la medida es sostenible o acaba desactivada.
Los falsos positivos habituales son conocidos: una integración de un cliente que reintenta demasiado rápido tras un fallo, una oficina entera compartiendo dirección de salida, un usuario con la pestaña duplicada varias veces, o un rastreador legítimo de un buscador.
Lo que evita que esos casos se conviertan en quejas es tener visibilidad antes que dureza. Registrar cada vez que alguien alcanza el tope, con quién fue y qué ruta, permite revisar al cabo de una semana si los que chocan son abusos reales o clientes normales con un umbral mal calibrado.
Por eso conviene empezar con límites holgados y medir, en lugar de ajustarlos al mínimo desde el principio. Un límite que nadie alcanza no protege menos: protege exactamente contra el caso extremo, que es para lo que existe.
Y conviene poder hacer excepciones. Una lista de clientes o integraciones con un límite propio evita la situación incómoda de tener que elegir entre bajar la protección para todos o romperle el servicio a alguien que paga.
La medida que cuesta menos de todas
Antes de cerrar conviene mencionar algo que no es exactamente limitar el ritmo y que resuelve una parte enorme del abuso automatizado en formularios públicos.
Los envíos automáticos masivos casi nunca vienen de alguien interesado en tu sitio en particular: vienen de programas que recorren internet rellenando cualquier formulario que encuentran. Y esos programas se comportan de formas muy reconocibles.
Un campo oculto que un humano nunca rellenaría, y que si llega con contenido delata al programa. Un control del tiempo transcurrido entre cargar el formulario y enviarlo, porque nadie escribe un mensaje en menos de dos segundos. Ambas cosas cuestan unas líneas, no molestan a ningún usuario y filtran la mayor parte de ese ruido.
No sustituyen al límite de peticiones, que sigue haciendo falta para todo lo demás. Pero combinadas con él cubren los dos extremos: el abuso tonto y masivo por un lado, y el dirigido por otro.
El error de proteger solo la puerta principal
Un patrón frecuente es configurar el límite en la capa que recibe el tráfico web y dar el asunto por resuelto, sin notar que varias vías de entrada no pasan por ahí.
Los webhooks que llegan de servicios externos, los endpoints internos accesibles desde la red, las tareas programadas que alguien puede disparar y las funciones sin servidor invocadas directamente suelen quedar fuera de esa configuración.
La comprobación es la misma que sirve para tantas cosas de seguridad: enumerar todas las formas de llegar al código, no solo la que usa el navegador, y verificar cuáles pasan por el filtro.
Y conviene revisar qué ocurre cuando el mecanismo de conteo falla. Si el almacén compartido deja de responder y el código decide dejar pasar todo para no romper el servicio, la protección desaparece justo en el momento de mayor estrés, que es cuando más falta hace.
Qué se le escapa a una IA con esto
Pedir una API produce endpoints funcionales sin ningún límite, porque limitar no forma parte de lo que se entiende por hacer que funcione. Es una omisión sistemática y silenciosa.
Cuando sí se pide explícitamente, la implementación habitual es un contador en memoria, que funciona perfectamente en una máquina y deja de funcionar en cuanto hay más de una instancia. El código es correcto y la protección es ilusoria.
Las frases que cambian la respuesta son pedir que el contador sea compartido entre instancias y que se apliquen límites distintos por operación, nombrando las rutas caras. Con eso aparece el almacén común y la distinción entre una consulta barata y un envío de correo.
Y conviene pedir siempre el comportamiento ante fallo del contador y la respuesta con la cabecera de espera. Son los dos detalles que separan una protección que funciona bajo presión de una que existe solo mientras nada va mal.