Segunda semana de un proyecto nuevo. Todavía no hay usuarios, el equipo son dos personas, y en la pizarra ya hay seis cajas con flechas entre ellas: pedidos, usuarios, notificaciones, pagos, catálogo y un bus de eventos en el centro.
Nadie decidió eso. Salió de preguntar cómo estructurar el proyecto y aceptar la primera respuesta, que casi siempre son microservicios, porque es lo que más abunda en la literatura técnica de los últimos años.
Los microservicios no son el error. El error es adoptar por moda algo que existe para resolver un problema de equipos, en un proyecto que todavía no tiene equipos.
Qué se está decidiendo en realidad
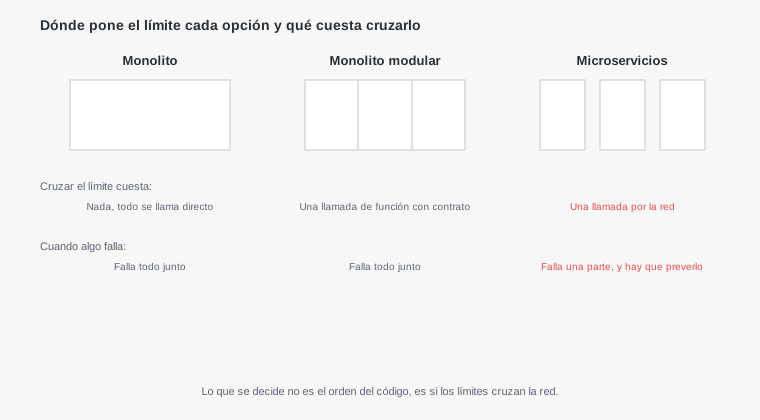
Las tres opciones son formas de responder a una sola pregunta: dónde pones los límites entre las partes de tu sistema, y qué tan caro es cruzarlos.
En un monolito, dos módulos se hablan con una llamada a función: microsegundos, y si falla, falla todo junto de forma predecible.
Entre dos microservicios, esa misma conversación es una petición de red: milisegundos, y puede fallar sola, llegar dos veces o no llegar nunca.
Dividir no elimina la complejidad, la mueve. Sale del código y entra en la red, en el despliegue y en la observabilidad. Esa mudanza se justifica cuando ganas algo a cambio, y no se justifica cuando el problema que resolvía no lo tenías.
Dónde pone cada opción los límites, y qué cuesta cruzarlos
| Monolito | Monolito modular | Microservicios | |
|---|---|---|---|
| Despliegue | Una unidad | Una unidad | Uno por servicio |
| Comunicación interna | Llamada a función | Llamada a función, por interfaz | Red |
| Base de datos | Una, compartida | Una, con esquemas separados | Una por servicio |
| Transacciones | Nativas | Nativas | Distribuidas, a mano |
| Equipos que soporta | 1 a 8 personas | 1 a 20 personas | Varios equipos autónomos |
| Depurar un fallo | Una traza | Una traza | Trazas correlacionadas |
| Escalar una parte sola | No | No | Sí |
| Costo de revertir | Bajo | Bajo | Alto |
La pregunta que ordena la decisión
No es cuántos usuarios tienes ni cuánto tráfico esperas. Es cuántas personas tocan el código a la vez.
Los microservicios resuelven un problema organizativo: varios equipos que se pisan al desplegar, que dependen unos de otros para sacar una funcionalidad, que no pueden moverse a ritmos distintos. Separar los servicios les devuelve autonomía.
Si trabajas solo, o son dos o tres personas, ese problema no existe. Lo que obtienes al dividir es toda la complejidad operativa del reparto sin ninguna de las ventajas organizativas.
Los microservicios son una solución a un problema de equipos, no de código.
El costo que no aparece en la propuesta
Cuando la IA propone una arquitectura de servicios, propone las cajas y las flechas. Lo que rara vez incluye es lo que hay que construir para que esas flechas funcionen.
La diferencia se ve mejor en código. Esta es una operación cualquiera dentro de un proceso:
// Monolito: si algo falla, la transacción entera se revierte sola
$db->beginTransaction();
$pedido = $pedidos->crear($carrito);
$inventario->descontar($carrito->items);   // misma base, mismo proceso
$db->commit();
Y esta es la misma operación cuando pedidos e inventario son servicios separados:
$pedido = $pedidos->crear($carrito);

try {
    // Otro proceso, otra base, otra red
    $inventario->descontar($carrito->items, $pedido->id);
} catch (TimeoutException $e) {
    // ¿Se descontó y se perdió la respuesta, o no se descontó?
    // No hay forma de saberlo desde aquí: hay que preguntar o reintentar
    // con una clave que evite descontar dos veces.
    $compensacion->encolar($pedido->id);
    throw new PedidoIncompletoException();
}
Ese catch es la arquitectura real. Un tiempo de espera agotado no te dice si la operación ocurrió: solo dice que no llegó la respuesta. Para resolverlo necesitas reintentos con una clave de idempotencia, una cola de compensación, y un lugar donde el pedido quede marcado como incompleto hasta que se resuelva.
Multiplica eso por cada par de servicios que se hablan. Es trabajo que en un monolito hace la base de datos con una línea.
El monolito modular: la opción que casi nunca proponen
Hay una tercera vía que rara vez aparece cuando le pides una arquitectura a un modelo, y que para la mayoría de los proyectos es la respuesta correcta: un solo desplegable, con límites internos tratados en serio.
src/
  Pedidos/
    Dominio/          # la lógica, sin saber de HTTP ni de base de datos
    Infraestructura/  # el acceso a datos de este módulo y nada más
    API.php           # lo único que otros módulos pueden llamar
  Inventario/
    Dominio/
    Infraestructura/
    API.php
  Facturacion/
    ...
La regla que lo sostiene es una sola: un módulo se comunica con otro únicamente a través de su archivo público, nunca accediendo a sus tablas ni a sus clases internas. Si Facturación necesita un dato de Pedidos, se lo pide a Pedidos.
Eso conserva lo barato del monolito (una transacción, una traza, un despliegue) y a la vez deja el sistema listo para dividirse si algún día hace falta, porque los límites ya están donde tendrían que estar.
Lo que hace difícil el monolito modular no es técnico, es de disciplina: nada impide saltarse la regla, y una consulta directa a la tabla de otro módulo funciona perfectamente hoy y borra el límite para siempre.
Qué pasa con los datos cuando divides
Es la consecuencia que menos se anticipa y la que más duele. Si cada servicio tiene su propia base, como manda el patrón, entonces las consultas que cruzan áreas dejan de existir.
Un informe tan simple como ventas del mes por categoría de producto es un JOIN entre dos tablas cuando todo vive junto. Con pedidos e inventario separados, ese informe pasa a ser dos llamadas de red y un cruce hecho a mano en memoria, con paginación propia y sin poder ordenar por un campo del otro servicio.
Ante ese problema, la salida rápida es dejar que el servicio de informes lea directamente las tablas de los demás. Funciona, y es exactamente lo que convierte la arquitectura en un monolito distribuido: varios despliegues acoplados por la base de datos, con toda la latencia de la red y ninguna de las ventajas del aislamiento.
La señal de que pasó esto es concreta: un cambio de esquema en un servicio rompe otro servicio distinto.
Las salidas legítimas son tres, y ninguna es gratis: duplicar los datos que el otro servicio necesita y mantenerlos sincronizados por eventos, construir una vista de solo lectura alimentada por esos eventos, o aceptar que ese informe se arma con varias llamadas y va más lento.
Conviene decidirlo antes de dividir, porque es trabajo que aparece entero el día que alguien pide el primer informe que cruza dos áreas.
El camino intermedio que sí funciona
Casi ningún proyecto pasa de monolito a microservicios de una vez, y los que lo intentan suelen quedarse a mitad. Lo que funciona es sacar un solo servicio, el que tenga un motivo claro para salir.
Ese motivo suele ser uno de tres: consume recursos muy distintos al resto, tiene requisitos de cumplimiento propios, o cambia a un ritmo mucho mayor que el resto del sistema.
El orden que reduce el riesgo es este:
- Traza el límite dentro del monolito primero. Que ese módulo ya se comunique solo por su interfaz pública y no comparta tablas con nadie.
- Déjalo funcionando así un tiempo. Si aparecen atajos hacia sus tablas, el límite estaba mal puesto y todavía es barato corregirlo.
- Recién entonces sácalo. La interfaz ya existe; lo que cambia es que detrás hay una llamada de red y hay que resolver los fallos que eso introduce.
Hacerlo en este orden tiene una ventaja que se nota al final: si en el paso dos descubres que el límite no se sostiene, no desplegaste nada, no montaste infraestructura nueva y no hay nada que revertir.
Tres señales de que dividir sí se justifica
No son de código, y las tres tienen que ver con personas o con dinero.
- Los despliegues se bloquean entre sí. Varias personas esperan para sacar cambios porque todo sale junto y un fallo en cualquier parte detiene el resto.
- Una parte tiene necesidades de escala muy distintas. El procesamiento de imágenes necesita diez veces más memoria que el resto, y estás pagando esa memoria para todo el sistema.
- Una parte tiene requisitos de cumplimiento propios. El módulo que toca datos de pago necesita aislamiento, auditoría separada y acceso restringido.
Si ninguna de las tres aplica, dividir es adelantar un costo cierto a cambio de un beneficio hipotético.
Lo que dividir no arregla
Hay una creencia extendida de que los microservicios ordenan un código desordenado. No lo hacen.
Si los límites entre las partes están mal trazados, separarlas en servicios convierte un acoplamiento incómodo en un acoplamiento distribuido, que es peor: ahora cada llamada entre piezas mal separadas cruza la red, puede fallar sola y hay que versionarla.
El orden viene de definir bien los límites, y eso se puede hacer dentro de un monolito, gratis. Si no eres capaz de trazarlos ahí, tampoco los vas a trazar bien repartidos en servicios.