$ php artisan migrate
PHP Fatal error: Uncaught Error: Call to undefined function
str_contains() in /var/www/app/Support/Text.php:42
Ese error es de un despliegue que funcionaba perfectamente en la máquina de quien lo escribió. La función existe desde PHP 8.0; el servidor corría 7.4.
No es un error de programación. Es que el código se escribió en un entorno y se ejecutó en otro distinto, y nadie lo notó hasta que el segundo entorno era producción.
Los contenedores existen para eliminar esa categoría entera de problemas, y conviene entenderlos antes de hablar de orquestarlos.
Qué es un contenedor, sin metáforas
Un contenedor es un proceso normal del sistema operativo, corriendo con una vista restringida de la máquina: ve su propio sistema de archivos, su propia red y sus propios procesos, pero usa el mismo núcleo que todo lo demás.
Esa última parte es la que lo diferencia de una máquina virtual, y explica casi todas sus propiedades.
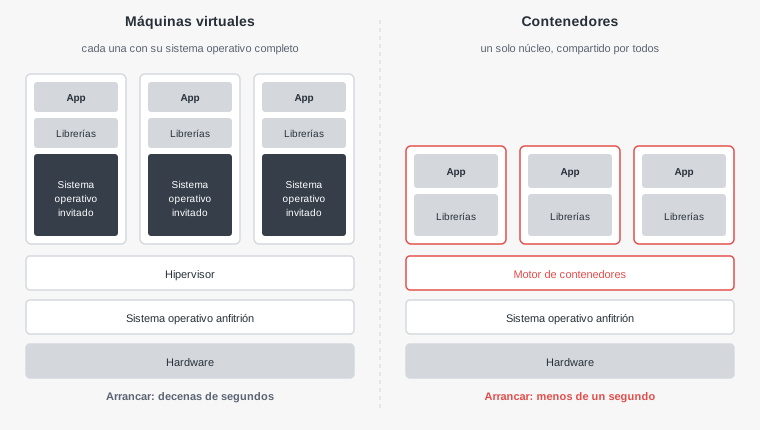
De ahí salen las tres diferencias prácticas: un contenedor arranca en menos de un segundo porque no hay sistema operativo que iniciar, ocupa megabytes en vez de gigabytes, y el aislamiento es más débil, porque comparte núcleo con todo lo demás de la máquina.
Esa tercera consecuencia importa más de lo que suele decirse: un contenedor no es una frontera de seguridad tan fuerte como una máquina virtual. Aísla lo suficiente para separar aplicaciones que confían entre sí; no lo suficiente para ejecutar código de terceros que no controlas.
La imagen es la plantilla: el sistema de archivos con tu código, sus dependencias y la versión exacta del lenguaje. Se construye una vez y no cambia.
El contenedor es una ejecución de esa imagen. De una misma imagen se levantan diez contenedores idénticos, y cuando uno muere, lo que escribió dentro se pierde.
Qué resuelve de verdad
Tres cosas concretas, y conviene nombrarlas porque el resto de lo que se le atribuye no es cierto.
El entorno deja de ser una variable. La versión del lenguaje, las extensiones instaladas y las librerías del sistema viajan dentro de la imagen. Lo que probaste es literalmente lo que corre.
Dos proyectos dejan de estorbarse. Uno puede necesitar PHP 8.1 y otro 8.4 en la misma máquina, sin conflictos y sin gestores de versiones.
Volver atrás se vuelve trivial. Si la versión 1.4.2 falla, se levanta la 1.4.1, que sigue existiendo como imagen. No hay que deshacer nada ni recordar qué se cambió.
Qué no resuelve, aunque se diga
Esta parte importa porque los contenedores se venden a veces como una mejora general, y no lo son.
- No hacen tu aplicación más segura. Una inyección SQL dentro de un contenedor sigue siendo una inyección SQL. Lo que acotan es el daño posterior, y solo si están bien configurados.
- No la hacen escalable. Si el cuello de botella es una consulta lenta, replicar contenedores multiplica las consultas lentas.
- No arreglan el estado. Al contrario: lo vuelven un problema explícito, porque lo que el contenedor escribe dentro desaparece al reiniciarse.
- No reducen la complejidad. Añaden una capa. Lo que dan a cambio es que esa capa sea predecible.
El Dockerfile que te va a proponer la IA
Cuando pides un contenedor para tu aplicación, lo habitual es recibir algo así:
FROM php:latest
COPY . /var/www
RUN composer install
CMD ["php", "-S", "0.0.0.0:80", "-t", "/var/www/public"]
Funciona. Y tiene cuatro problemas que solo se manifiestan más tarde.
La etiqueta latest. Hoy construye con una versión y dentro de tres meses con otra, sin que hayas cambiado nada. Es la forma más silenciosa de romper un despliegue.
Copiar todo antes de instalar dependencias. Cada cambio en cualquier archivo invalida la caché y obliga a reinstalar todo, convirtiendo una construcción de segundos en uno de minutos.
Corre como administrador. Por defecto el proceso es root dentro del contenedor, y eso amplía bastante lo que un atacante puede hacer si logra ejecutar algo.
Copia el directorio completo, incluidos el historial de git, el archivo de variables de entorno si existe y cualquier credencial que ande suelta.
La versión corregida no es mucho más larga:
# Versión exacta, no "latest"
FROM php:8.4-fpm-alpine

# Primero las dependencias: esta capa se reutiliza mientras no cambien
COPY composer.json composer.lock ./
RUN composer install --no-dev --optimize-autoloader

# Después el código, que sí cambia en cada commit
COPY src/ ./src/
COPY public/ ./public/

# Un usuario sin privilegios para ejecutar la aplicación
RUN adduser -D app
USER app
El orden de las dos secciones es lo que más impacto tiene en el día a día: las dependencias se instalan solo cuando cambian los archivos que las declaran, no cada vez que tocas una línea de código.
Y hace falta un .dockerignore, que casi nunca aparece en la propuesta, para que no acabe dentro de la imagen lo que no debe:
.git
.env
node_modules
tests
*.md
Las credenciales no van dentro
Hay un error específico que conviene señalar aparte, porque es difícil de deshacer.
Si una clave se copia dentro de la imagen durante la construcción, queda grabada en una de sus capas. Borrarla en una instrucción posterior no la elimina: sigue ahí, recuperable por cualquiera que tenga la imagen, igual que un archivo borrado en un commit sigue en el historial de git.
Las credenciales se pasan al arrancar el contenedor, como variables de entorno o montadas desde el gestor de secretos, nunca en la construcción. Y si alguna llegó a entrar, hay que rotarla, no solo reconstruir la imagen.
Por qué una imagen pesa 900 MB y cómo baja a 80
El tamaño no es vanidad: una imagen grande tarda más en subirse al registro, más en descargarse en cada máquina y más en arrancar cuando hay que reponer un servicio con urgencia.
Una imagen se construye por capas, una por cada instrucción del archivo. Cada capa guarda la diferencia respecto de la anterior, y todas quedan dentro de la imagen final.
De ahí sale el malentendido más común. Esto no libera nada:
RUN apt-get install -y build-essential   # capa 1: +300 MB
RUN ./compilar.sh                        # capa 2
RUN apt-get remove -y build-essential    # capa 3: la imagen NO adelgaza
La capa 1 sigue ahí con sus 300 MB. La capa 3 solo anota que esos archivos ya no se ven, pero siguen ocupando espacio y siguen siendo recuperables.
Las dos formas de arreglarlo son conocidas. La primera es hacer el trabajo y la limpieza en una sola instrucción, para que nunca lleguen a ser una capa propia. La segunda, más limpia, es construir en una imagen y copiar solo el resultado a otra:
# Etapa de construcción: aquí sí hacen falta las herramientas
FROM node:22 AS build
WORKDIR /app
COPY package*.json ./
RUN npm ci
COPY . .
RUN npm run build

# Imagen final: solo el resultado, sin compiladores ni dependencias de desarrollo
FROM nginx:1.27-alpine
COPY --from=build /app/dist /usr/share/nginx/html
La imagen final no contiene Node, ni node_modules, ni el código fuente. Solo los archivos que se sirven. Es la diferencia entre cientos de megabytes y unas decenas.
La elección de la imagen base tiene un efecto parecido y más inmediato: las variantes ligeras de las imágenes oficiales suelen ocupar una fracción de las completas, a cambio de traer menos herramientas dentro, que es justo lo que quieres en producción.
Cuando el contenedor no arranca
Es la primera pared con la que se choca, y tiene una particularidad: el contenedor muere tan rápido que parece que no hubiera pasado nada.
Los comandos que resuelven la mayoría de los casos son tres, y conviene conocerlos antes de necesitarlos:
# Qué contenedores hay, incluidos los que ya murieron
docker ps -a

# Por qué murió: casi siempre la respuesta está aquí
docker logs mi-app

# Entrar a uno que sí está corriendo, para mirar desde dentro
docker exec -it mi-app sh
Dos causas concentran buena parte de los fallos de arranque. La primera es que el proceso principal termina: un contenedor vive mientras viva el comando que lo arrancó, así que si ese comando hace su trabajo y sale, el contenedor se detiene y parece que falló.
La segunda son los permisos. Al ejecutar como usuario sin privilegios, cosa recomendable, el proceso puede no tener permiso de escritura en un directorio que la aplicación necesita. El síntoma es un error de permiso denegado que en la máquina de desarrollo nunca aparecía, porque ahí todo corría como administrador.
Puertos y redes, la otra fricción del principio
Un contenedor no expone nada hacia fuera por defecto. Que la aplicación escuche en el puerto 8080 dentro no significa que puedas abrirla en el navegador.
Hay dos conceptos que se confunden todo el tiempo y que producen el clásico no conecta y no entiendo por qué.
Publicar un puerto conecta un puerto de la máquina con uno del contenedor. Sin eso, el servicio es inalcanzable desde el exterior por más que esté funcionando.
Entre contenedores no se usa localhost, porque cada uno tiene su propia red y localhost apunta a sí mismo. Se usa el nombre del otro servicio, que el motor resuelve solo.
De ahí viene el error más frecuente al empezar: la aplicación busca la base de datos en 127.0.0.1 y no la encuentra, aunque el contenedor de al lado la esté sirviendo sin problema.
Hay además un detalle que rompe despliegues y cuesta ver: si la aplicación escucha solo en 127.0.0.1 dentro del contenedor, publicar el puerto no sirve de nada, porque esa dirección es privada del contenedor. Tiene que escuchar en 0.0.0.0 para aceptar conexiones desde fuera.
Cuándo no te hacen falta
No todo proyecto los necesita, y adoptarlos por defecto también es una decisión no tomada.
En un hosting compartido no hay forma de ejecutarlos: no tienes control del sistema operativo. En un sitio estático no hay nada que contener, porque no corre código en el servidor. Y en un proyecto personal en una sola máquina que ya funciona, el beneficio es real pero pequeño, y la curva de aprendizaje se paga entera.
La señal de que sí compensan es concreta: cuando el entorno ya te ha roto un despliegue al menos una vez, o cuando hay más de una persona ejecutando el proyecto en máquinas distintas.
Y si llegas a ese punto, empaquetar es el paso que aporta valor por sí solo. Coordinar varios contenedores entre varias máquinas es un problema distinto, que trato en orquestación: Kubernetes, Docker Swarm o ninguno todavía.