Mira la dirección de una API que creció sirviendo a dos clientes distintos:
GET /api/pedidos/8841?expand=cliente,items&fields=id,estado,total&mobile=1&v=2Cada parámetro de esa URL es una capa de sedimento. El expand llegó cuando la web necesitó más datos; el fields, cuando el móvil quiso menos; el mobile=1 cuando hubo que cambiar el formato de una fecha solo para el teléfono, y el v=2 cuando ya nadie se atrevió a tocar la versión anterior.
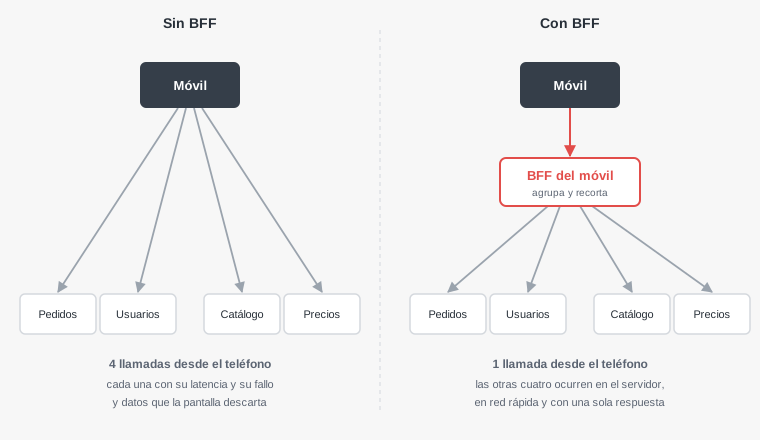
Eso pasa cuando una sola API intenta servir a clientes con necesidades distintas. Un Backend for Frontend es la alternativa: una capa por cada tipo de cliente, cuyo único trabajo es hablar con los servicios de atrás y devolver exactamente lo que esa pantalla necesita.
El problema concreto que resuelve
Son dos problemas, y conviene distinguirlos porque no siempre aparecen juntos.
El primero es la cantidad de llamadas. Una pantalla que muestra un pedido con el nombre del cliente, las fotos de los productos y el precio actual necesita datos de cuatro sitios distintos. Desde un servidor eso son cuatro llamadas en red local, cuestión de milisegundos. Desde un teléfono con señal irregular, son cuatro viajes de ida y vuelta que el usuario espera.
El segundo es la forma de los datos. Una API genérica devuelve el objeto completo porque no sabe quién pregunta. La pantalla usa tres campos y descarta el resto, después de haberlos descargado.
Traer de más es recibir campos que nadie va a mostrar. Cuesta ancho de banda y batería, y en conexiones malas se nota.
Traer de menos es peor: la respuesta no alcanza para pintar la pantalla, así que el cliente hace otra llamada, y a veces otra más, encadenadas una tras otra.
El encadenamiento es lo que más daña la experiencia, porque las llamadas no ocurren en paralelo: cada una necesita el resultado de la anterior para saber qué pedir.
Cómo se ve la diferencia
Esto es lo que devuelve una API genérica cuando la pantalla solo necesita pintar una tarjeta de pedido:
{
  "id": 8841,
  "usuario_id": 231,
  "estado": "enviado",
  "creado_en": "2026-08-02T14:22:10Z",
  "actualizado_en": "2026-08-03T09:01:44Z",
  "direccion_facturacion": { "...": "18 campos" },
  "direccion_envio": { "...": "18 campos" },
  "items": [ { "producto_id": 55, "cantidad": 2, "precio_unitario": 1200 } ],
  "notas_internas": "cliente pidió llamar antes",
  "metodo_pago_id": 12
}
Faltan el nombre del cliente y la foto del producto, así que el teléfono tiene que pedirlos aparte. Y sobran las notas internas, que además no deberían salir nunca hacia una aplicación de cliente.
El mismo pedido, moldeado por un BFF para esa pantalla concreta:
{
  "id": 8841,
  "estado": "enviado",
  "cliente": "María Ruiz",
  "total": "24,00 €",
  "items": [
    { "titulo": "Taza cerámica", "cantidad": 2, "foto": "/img/55/thumb.webp" }
  ]
}
Una sola llamada, sin campos sobrantes, con el total ya formateado y las notas internas fuera. Ese formateo importa: si cada cliente calcula el total por su cuenta, tarde o temprano dos de ellos muestran cifras distintas.
La identidad del usuario a través de la capa
Es donde este patrón se rompe con más frecuencia, y el fallo no se ve probando: todo funciona, y sin embargo el sistema quedó abierto.
El BFF recibe la petición del usuario y luego llama a cuatro servicios. La pregunta es con qué identidad hace esas cuatro llamadas.
La salida cómoda es que el BFF tenga sus propias credenciales de servicio, con permisos amplios, y las use para todo. Así cualquier llamada funciona siempre, y por eso es la que suele aparecer cuando nadie definió el tema.
Si el BFF pide los datos del pedido con sus propias credenciales, el servicio de pedidos ya no sabe quién pregunta: ve un cliente de confianza y responde.
Entonces la única comprobación de que ese pedido pertenece a quien lo pide está en el BFF. Si alguien la olvida en una ruta, el servicio de atrás no la va a atrapar, porque desde su punto de vista todo venía autorizado.
Lo correcto es que el BFF propague la identidad del usuario hacia atrás, de modo que cada servicio siga aplicando sus propias reglas. El BFF adapta formatos; no se convierte en la única frontera de seguridad del sistema.
Hay además una decisión previa que conviene tomar a conciencia: dónde vive la sesión. Un BFF web puede guardar el token en una cookie con marca de solo servidor, de forma que el navegador nunca lo vea. Esa es una de las ventajas reales del patrón y se pierde si el token se devuelve al cliente para que lo guarde por su cuenta.
Qué pasa cuando uno de los servicios falla
Al agrupar cuatro llamadas en una, el BFF hereda los fallos de las cuatro. Si no se decide qué hacer con cada uno, el resultado por defecto es el peor posible: la pantalla entera falla porque un servicio secundario tardó.
La decisión que hay que tomar, y que es de producto más que técnica, es cuáles de esos datos son imprescindibles y cuáles no.
// Lo esencial se espera; lo accesorio se degrada si falla
const [pedido, cliente] = await Promise.all([
    pedidos.obtener(id),        // sin esto no hay pantalla
    usuarios.obtener(userId),
]);

// Las fotos son un adorno: si el catálogo tarda, seguimos sin ellas
const fotos = await catalogo.fotos(pedido.items)
    .catch(() => []);

return componer(pedido, cliente, fotos);
Ese catch que devuelve una lista vacía es una decisión de negocio escrita en código: preferimos mostrar el pedido sin fotos que no mostrar nada. Sin esa decisión explícita, un fallo del catálogo tumba una pantalla que no depende de él.
Conviene además poner un tiempo de espera a cada llamada de atrás, más corto que el que tolera el cliente. Sin eso, el BFF se queda esperando a un servicio caído y acumula peticiones abiertas hasta que él mismo deja de responder.
De quién es el BFF
La parte organizativa decide si el patrón funciona, y casi nunca se menciona.
Un BFF pertenece al equipo que construye ese cliente, no al equipo de plataforma. Esa es la premisa: existe para que quien hace la aplicación móvil pueda cambiar la forma de una respuesta sin pedirle permiso a nadie ni esperar el ciclo de otro equipo.
Cuando la propiedad se invierte y el BFF lo mantiene un equipo central, el patrón pierde su razón de ser y conserva todos sus costos. Cada cambio de pantalla vuelve a requerir coordinación, que es exactamente lo que se buscaba evitar, solo que ahora con una capa más que desplegar.
De ahí se sigue una consecuencia práctica: si tu proyecto lo lleva una sola persona, no hay equipos entre los que repartir nada, y el BFF no tiene un problema organizativo que resolver. Lo que quede es una capa de adaptación, que puede estar bien, pero conviene llamarla por su nombre y no montarla esperando los beneficios del patrón.
Hay una última pregunta que ordena la decisión: ¿quién se bloquea hoy esperando a otro para cambiar una pantalla? Si la respuesta es nadie, el patrón está resolviendo un problema que todavía no tienes.
La caché, que es donde más se gana
Hay un beneficio del patrón que suele quedar sin usar: al componer la respuesta en el servidor, el BFF puede guardarla y reutilizarla, cosa que el cliente por su cuenta no puede hacer con la misma eficacia.
La distinción que ordena todo es si la respuesta depende o no de quién pregunta.
Lo que es igual para todos se cachea una vez y sirve a todo el mundo: el catálogo, los precios públicos, las fotos de los productos. Aquí el ahorro es grande, porque una sola consulta a los servicios de atrás atiende a miles de visitas.
Lo que depende del usuario no puede compartirse jamás. Un pedido, un carrito o un saldo cacheados sin distinguir quién pregunta significan que un usuario ve los datos de otro, y es un fallo que aparece solo bajo carga, cuando dos peticiones coinciden.
Por eso conviene que el BFF separe la composición en dos partes: la común, que se cachea con generosidad, y la personal, que se pide siempre. Mezclarlas en una sola respuesta obliga a tratar todo el conjunto como personal y desperdicia el beneficio.
Y una advertencia sobre las cabeceras: si el BFF devuelve una respuesta con datos del usuario, tiene que decir explícitamente que no se guarde en caches intermedias. Un proxy o un CDN que la almacene por error convierte un descuido en una fuga de datos que ni siquiera ocurre en tu servidor.
Qué no es un BFF
Se confunde con dos cosas parecidas, y elegir la equivocada cuesta caro.
| BFF | API gateway | GraphQL | |
|---|---|---|---|
| Cuántos hay | Uno por tipo de cliente | Uno para todos | Uno para todos |
| Quién decide la forma | El servidor, por pantalla | Nadie, solo enruta | El cliente, en la consulta |
| Agrupa varias llamadas | Sí, esa es su función | A veces | Sí |
| Quién lo mantiene | El equipo del cliente | Plataforma | Equipo de API |
| Complejidad que añade | Un desplegable por cliente | Configuración | Esquema y control de consultas |
La diferencia de fondo con un gateway es la intención: el gateway resuelve preocupaciones transversales, como autenticación o límites de uso, y no debería conocer las pantallas. El BFF existe precisamente para conocerlas.
Con GraphQL la diferencia es quién decide la forma de la respuesta. Le da esa potestad al cliente, lo que resuelve el mismo problema sin una capa por cliente, a cambio de tener que controlar consultas demasiado costosas y de un esquema que hay que gobernar.
Si tienes un solo cliente, tu API ya es tu BFF.
Cuándo no lo necesitas
Esta es la parte que conviene tener clara antes de montar nada, porque es la situación más común.
Con un solo tipo de cliente, añadir un BFF es añadir un salto de red, un desplegable y un punto de fallo para resolver un problema que no tienes. Si la forma de la respuesta no encaja con la pantalla, cambia la respuesta: es tu API y tu único consumidor.
Tampoco hace falta cuando hay dos clientes que muestran prácticamente lo mismo. Una web y una aplicación móvil que enseñan las mismas pantallas pueden compartir API sin problema; el patrón se justifica cuando las necesidades divergen de verdad, no cuando los clientes son dos.
El costo, que es real
Un BFF es un servicio más: se despliega, se monitorea, se versiona y puede caerse. Y tiene dos riesgos propios que aparecen con el tiempo.
Se convierte en el nuevo monolito. Como está en medio y conoce todos los servicios, es el lugar cómodo para meter cualquier lógica que no encaje limpio en otro sitio. Al año, el BFF contiene reglas de negocio que nadie sabe que están ahí, y ya no es una capa de adaptación sino el centro del sistema.
Se duplica el trabajo entre BFFs. Con tres clientes hay tres capas resolviendo cosas parecidas. Cuando cambia un servicio de atrás, hay que actualizar las tres, y es habitual que una se olvide.
La regla que evita el primer problema es simple de enunciar y difícil de sostener: el BFF traduce y agrupa, no decide. Si una regla determina qué es válido, cuánto se cobra o quién puede hacer algo, va en el servicio que manda sobre ese dominio, no en la capa de adaptación.
Hay una prueba práctica para detectar cuándo se cruzó la línea: si borras el BFF y el sistema pierde una regla de negocio, esa regla estaba en el lugar equivocado.