Todos los equipos conocen la conversación. Alguien propone parar dos semanas para limpiar el código, porque cada cambio cuesta el triple de lo que debería. Alguien responde que no hay dos semanas, porque hay que entregar. Y el resultado habitual es que no se limpia nada y la situación empeora.
La salida no es ganar esa discusión. Es cambiar el planteamiento: la deuda no se paga parando, se paga en pequeñas cuotas mientras se sigue trabajando, empezando por la que más intereses cobra.
En el primer eje de esta guía hay un artículo sobre cómo reconocer la deuda técnica invisible. Este empieza donde aquel termina: ya sabes que la tienes, y la pregunta es qué hacer con ella sin detener el producto.
Por qué la gran limpieza casi nunca funciona
La reescritura completa o la parada para refactorizar tienen un historial pobre, y conviene entender por qué antes de proponerlas.
Mientras dura la limpieza, el negocio no para: llegan errores urgentes, peticiones de clientes, cambios que no pueden esperar. Esos cambios se hacen sobre el código viejo, y la limpieza queda desactualizada antes de terminar.
Además, dos semanas nunca son dos semanas. La deuda más profunda aparece al tirar del hilo, la estimación se triplica, y el proyecto de limpieza acaba cancelado a medias, dejando el código en un estado intermedio peor que el de partida.
Y hay un problema de fondo: una limpieza general no tiene criterio para decidir qué es importante. Se limpia lo que se ve feo, que no siempre es lo que cuesta dinero.
No toda la deuda cobra intereses
La idea que ordena todo lo demás es que la deuda solo cuesta cuando se toca. Un módulo espantoso que nadie modifica desde hace dos años no está costando nada.
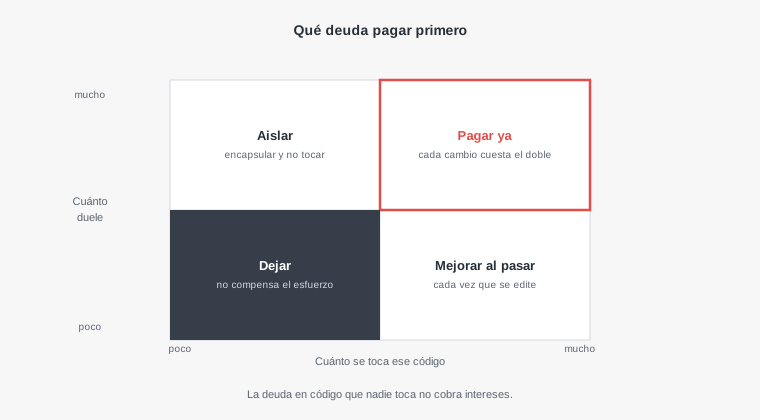
Cruzar cuánto duele un fragmento de código con cuánto se modifica da cuatro decisiones claras. Solo una de ellas, la esquina de arriba a la derecha, justifica dedicarle tiempo específico. Las otras tres se resuelven sin planificar nada: aislando, mejorando al pasar, o simplemente dejando.
Esa matriz convierte una discusión de gustos en una decisión con datos, siempre que los datos existan. Y existen: están en el historial del repositorio.
Encontrar los puntos calientes con git
El historial de versiones sabe exactamente qué archivos se modifican más, y cruzarlo con el tamaño o la complejidad señala dónde se concentra el coste real.
# Archivos más modificados en el último año
git log --since="1 year ago" --name-only --pretty=format: \
  | grep -v '^$' | sort | uniq -c | sort -rn | head -20

# Archivos que más veces aparecen en correcciones de errores
git log --since="1 year ago" -i --grep='fix\|error\|bug' --name-only --pretty=format: \
  | grep -v '^$' | sort | uniq -c | sort -rn | head -10

# Tamaño de esos archivos, para cruzar frecuencia con volumen
git log --since="1 year ago" --name-only --pretty=format: | grep -v '^$' \
  | sort | uniq -c | sort -rn | head -20 \
  | while read n f; do [ -f "$f" ] && echo "$n cambios  $(wc -l < "$f") líneas  $f"; done
El resultado casi siempre sorprende. La deuda que el equipo tenía en mente suele estar en archivos que se tocan poco, y los verdaderos puntos calientes son dos o tres archivos grandes que aparecen en casi todas las correcciones.
Esos son los que conviene atacar primero, porque cada mejora se amortiza en las siguientes semanas.
Las pruebas de caracterización, antes de tocar nada
El miedo a refactorizar código viejo tiene una causa concreta: no hay pruebas, así que no hay forma de saber si un cambio rompió algo. La solución no es escribir las pruebas que el código debería tener, sino las que describen lo que hace hoy.
Una prueba de caracterización no comprueba que el comportamiento sea correcto. Comprueba que no cambia. Se ejecuta el código con varias entradas, se guarda lo que devuelve, y la prueba falla si la salida cambia en el futuro.
// Congelar el comportamiento actual antes de refactorizar
public function test_calculo_de_envio_no_cambia(): void
{
    $casos = json_decode(file_get_contents(__DIR__.'/casos-envio.json'), true);

    foreach ($casos as $caso) {
        $this->assertSame(
            $caso['esperado'],                         // lo que devolvía antes
            calcularEnvio($caso['peso'], $caso['destino'], $caso['urgente'])
        );
    }
}
Si el código tiene un error, la prueba lo congela también, y eso es deliberado: la refactorización no debe cambiar el comportamiento. Corregir el error es un paso distinto, posterior, que se hace a propósito y con su propia prueba.
Con esa red, reorganizar el código deja de ser un salto al vacío. Si la prueba sigue en verde tras cada paso, el comportamiento se conserva.
Refactorizar en pasos pequeños
La diferencia entre una refactorización que sale bien y una que se abandona está casi siempre en el tamaño de los pasos.
Un buen paso es uno que deja el código funcionando y las pruebas en verde, que se puede subir por separado y que alguien puede revisar en cinco minutos. Extraer una función, renombrar una variable, mover un bloque a su propio archivo, eliminar una rama que nunca se ejecuta.
Un mal paso es el que empieza con la idea de reorganizar el módulo entero y acumula tres días de cambios sin poder subir nada, porque a mitad de camino nada funciona.
Cada paso pequeño es además reversible y fácil de revisar, y si hay que dejar la tarea a medias por una urgencia, lo hecho hasta ese momento ya está mejorando el código en lugar de estar abandonado en una rama que nadie volverá a abrir.
Sustituir por partes lo que no se puede arreglar
Hay código que no tiene arreglo razonable por dentro, y la tentación es reescribirlo entero. La alternativa que funciona es construir el reemplazo al lado y desviar el uso poco a poco.
Se crea la versión nueva detrás de la misma interfaz. Se redirigen primero los casos más simples o menos arriesgados. Se comprueba que se comportan igual, a menudo ejecutando ambas versiones y comparando resultados. Y cuando todo el uso está en la nueva, se borra la vieja.
// Ejecutar ambas implementaciones y registrar diferencias, sin afectar al usuario
$viejo = $this->facturacionVieja->calcular($pedido);
$nuevo = $this->facturacionNueva->calcular($pedido);

if ($viejo != $nuevo) {
    $log->warning('facturacion_discrepancia', ['pedido' => $pedido->id, 'viejo' => $viejo, 'nuevo' => $nuevo]);
}
return $viejo;   // se sigue usando la vieja hasta que no haya discrepancias
Es la misma idea de sustitución gradual que se usa con los servicios, aplicada a un módulo. Su gran ventaja es que nunca hay un día de cambio de golpe en el que todo pueda fallar a la vez.
Dejar el código mejor de lo que se encontró
La mayor parte de la deuda de la matriz, la que duele poco pero se toca a menudo, no necesita planificación. Se paga con una regla simple aplicada con constancia.
Cada vez que se modifica un archivo para una tarea, se deja un poco mejor: un nombre más claro, una función extraída, una condición simplificada, una prueba añadida. No una reorganización completa, solo una mejora pequeña relacionada con lo que se estaba tocando.
El efecto acumulado es considerable, precisamente porque se concentra en el código que más se modifica. Los puntos calientes mejoran solos con el uso, y el código que nadie toca se queda como está, que es exactamente lo que dice la matriz.
Conviene una única precaución: esas mejoras van en un cambio separado del funcional cuando son de cierto tamaño. Mezclar una corrección urgente con una reorganización hace la revisión imposible y complica volver atrás si algo sale mal.
Reservar una cuota fija
Para la deuda de la esquina que más duele, la que no se resuelve al pasar, hace falta tiempo dedicado. La forma que más resiste la presión de las entregas no es pedirlo, sino fijarlo.
Muchos equipos reservan una fracción estable de cada ciclo de trabajo, alrededor de un quince o veinte por ciento, a mejoras del código. No se negocia tarea a tarea, porque es parte del plan igual que las funcionalidades.
La ventaja de fijarlo es que elimina la discusión recurrente. La pregunta deja de ser si hay tiempo para limpiar y pasa a ser qué deuda se paga con el tiempo que ya está reservado, que es una pregunta mucho más fácil de responder con la matriz delante.
Medir si se está pagando
Sin una medida, es imposible saber si el esfuerzo sirve o si la deuda crece más rápido de lo que se paga.
Las medidas más útiles no son de calidad abstracta del código, sino de su efecto: cuánto tarda en promedio un cambio desde que se empieza hasta que llega a producción, cuántas correcciones de errores se hacen en los archivos calientes, y cuántas veces un despliegue hay que revertirlo.
# Evolución de correcciones por trimestre en un archivo caliente
for q in "6 months ago" "3 months ago" "now"; do
  echo "$q: $(git log --until="$q" --since="$q -3 months" -i --grep='fix' --oneline -- src/Facturacion.php | wc -l)"
done
Si las correcciones en un punto caliente bajan tras refactorizarlo, la inversión funcionó y ese dato vale para justificar la siguiente.
Qué se le escapa a una IA con esto
Pedir que se refactorice un módulo produce, con frecuencia, una reorganización completa en un solo paso: nombres cambiados, funciones movidas, estructura nueva, todo a la vez. El código resultante puede ser más limpio y es casi imposible de revisar, porque no hay forma de comprobar que el comportamiento se conservó.
Peor aún, es frecuente que en la misma reorganización se corrija de paso algo que parecía un error, cambiando el comportamiento sin que nadie lo decida. Si alguna otra parte dependía de ese comportamiento, se rompe sin aviso.
Las frases que cambian la respuesta son pedir primero las pruebas de caracterización que congelan el comportamiento actual, y después la refactorización en pasos pequeños, cada uno con las pruebas en verde, sin cambiar ningún comportamiento.
Y conviene decir explícitamente que no se corrija nada durante la refactorización. Si aparece un posible error, se anota, y se trata después como un cambio propio con su prueba.