Pregúntale a cualquiera si tiene copias de seguridad y la respuesta casi siempre es que sí. Pregúntale cuándo fue la última vez que restauró una, y ahí empieza el silencio.
Esa distancia entre las dos respuestas es de lo que trata este artículo. Tener copias es la parte fácil y la que todo el mundo hace. Poder recuperarse es otra cosa, y solo se sabe si funciona habiéndolo probado.
Una copia que nunca se restauró no es una copia
Suena exagerado hasta que ocurre. Las copias fallan en silencio por motivos que no se parecen entre sí y que comparten una característica: ninguno produce un error visible mientras todo va bien.
El proceso lleva meses guardando un archivo vacío porque el comando cambió de sintaxis. La copia incluye la base de datos pero no los archivos que los usuarios subieron. El archivo está cifrado y la clave vivía en el mismo servidor que se perdió. La copia se guarda en la misma máquina que falló. El volcado se hizo mientras la base escribía y quedó inconsistente.
Todos estos casos se descubren igual: el día del incidente, cuando ya no hay margen. Y ninguno se habría descubierto sin intentar una restauración de verdad.
Por eso la única pregunta que importa sobre una estrategia de respaldo no es con qué frecuencia se copia, sino cuándo fue la última restauración exitosa y cuánto tardó. Si la respuesta es nunca, lo que hay no es un sistema de respaldo: es una carpeta con archivos que se supone que sirven.
Los dos números que definen la estrategia
Antes de elegir herramientas conviene fijar dos cifras, porque todo lo demás se deriva de ellas. Se confunden a menudo y miden cosas distintas.
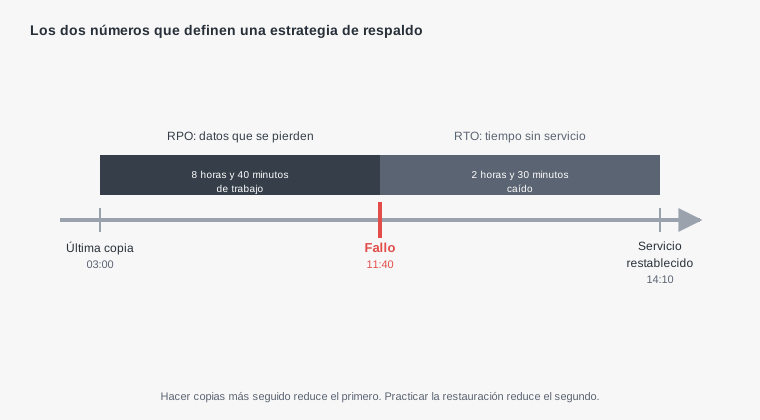
El primero es cuántos datos estás dispuesto a perder, medido en tiempo. Si copias una vez al día y el fallo llega justo antes de la siguiente copia, pierdes un día de trabajo. Bajar esa cifra significa copiar más seguido, lo que cuesta almacenamiento y algo de carga.
El segundo es cuánto tiempo puedes estar caído. Depende menos de la frecuencia y más de lo preparado que esté el procedimiento: si restaurar exige buscar documentación, pedir accesos y recordar cómo iba, el tiempo se multiplica.
Fijar las dos cifras es una decisión de negocio, no técnica. Para un proyecto personal, perder un día y estar caído una tarde puede ser perfectamente aceptable. Para una tienda en temporada alta, ninguna de las dos lo es. Lo que no funciona es no haberlo decidido, porque entonces la respuesta la impone el azar.
Qué hay que copiar, y qué se olvida siempre
La base de datos es lo primero que todos recuerdan, y suele ser lo único que se copia. El problema es que restaurar solo la base deja un sistema que arranca y no funciona.
- Los archivos que subieron los usuarios. Imágenes, documentos, adjuntos. No están en la base y son irrecuperables: nadie los puede volver a generar.
- Las variables de entorno y los secretos. Claves de API, credenciales, certificados. Sin ellos la aplicación restaurada no se conecta a nada.
- La configuración de la infraestructura. Qué servicios existen, cómo están conectados, qué reglas de red hay. Reconstruirlo de memoria es lento y propenso a errores.
- El propio código. Suele estar a salvo en el repositorio, pero conviene confirmar que el repositorio no vive únicamente en la máquina que puede perderse.
Una forma rápida de detectar huecos es plantear la pregunta al revés: si esta máquina desapareciera ahora mismo, ¿qué no podría reconstruir? Lo que aparezca en esa lista es exactamente lo que falta copiar.
La regla que resume décadas de incidentes
Hay una convención antigua en administración de sistemas que sigue vigente porque cada parte responde a un fallo real observado muchas veces.
Tres copias de los datos, contando la original.
Dos soportes o servicios distintos, para que un fallo del proveedor no se lleve todo.
Una fuera del sitio principal, en otra cuenta o en otra región.
La tercera parte es la que más se incumple y la que más importa. Una copia guardada en el mismo proveedor, con las mismas credenciales, no protege de los dos escenarios más destructivos: una cuenta comprometida y un borrado accidental con permisos amplios.
Conviene añadir una condición moderna que la regla original no contemplaba: al menos una copia debe ser inmutable o estar en una cuenta separada con permisos distintos. Si las credenciales que usa la aplicación pueden borrar las copias, un ataque o un script equivocado se lleva los datos y los respaldos en la misma operación.
Cómo se practica una restauración
El ensayo no requiere tocar producción ni asumir riesgos. Consiste en levantar el sistema desde cero en otro sitio, usando solo lo que hay guardado.
El ejercicio completo cabe en una tarde: crear un entorno limpio, restaurar la base desde la copia más reciente, recuperar los archivos, configurar las variables y comprobar que la aplicación arranca y responde. Nada de eso necesita usuarios reales ni afecta al servicio en marcha.
Lo valioso del ejercicio no es que funcione, sino lo que sale mal mientras se hace. Aparecen los pasos que faltaban en la documentación, el archivo que nadie estaba copiando, la clave que no se sabía dónde estaba. Encontrar eso un martes cualquiera cuesta una tarde; encontrarlo durante un incidente cuesta el negocio.
Y el resultado del ensayo es tan importante como el ensayo: anotar el tiempo que tomó y los pasos exactos convierte la próxima restauración en seguir una lista, no en improvisar bajo presión.
Cuánto tardó de principio a fin, en qué paso te quedaste trabado, qué credenciales hicieron falta y de dónde salieron, y qué no estaba copiado.
Ese documento vale más que cualquier configuración, porque es lo único que sirve cuando quien restaura no es quien montó el sistema.
Cuándo lo automático no alcanza
Casi todos los servicios gestionados incluyen copias automáticas, y para muchos proyectos eso es suficiente. Conviene, eso sí, saber exactamente qué cubren, porque hay tres límites que no son evidentes.
El primero es la retención: suelen guardarse pocos días. Si un problema se descubre tres semanas después, como la corrupción silenciosa de unos registros, puede que no quede ninguna copia anterior al daño.
El segundo es el alcance: cubren la base de datos del servicio, no los archivos, ni la configuración, ni lo que vive en otros proveedores.
El tercero es la dependencia: si el problema es la cuenta del proveedor, sus copias están dentro del mismo perímetro que falló.
La solución razonable para un proyecto pequeño no es montar una infraestructura paralela, sino añadir una única copia periódica que salga de ese perímetro y guardarla en otro sitio. Con eso se cubre la mayor parte del riesgo real.
El fallo que ninguna copia arregla si se descubre tarde
Hay un tipo de incidente que se comporta distinto a todos los demás, y es el que peor preparados nos encuentra: el daño que no se nota.
Un servidor que se apaga produce una señal inmediata y clara. En cambio, un error que escribe datos incorrectos en una tabla, un proceso que borra registros que no debía o una migración que trunca un campo no avisan de nada. El sistema sigue funcionando, respondiendo peticiones y aceptando usuarios, con los datos corrompiéndose por debajo.
Cuando alguien lo descubre, semanas después, la pregunta ya no es si hay copias, sino si queda alguna anterior al daño. Y con retenciones de siete o catorce días, la respuesta con frecuencia es que no: todas las copias disponibles contienen ya el problema.
Esto cambia una decisión concreta. Además de copias frecuentes y recientes, conviene guardar algunas espaciadas en el tiempo: una mensual que se conserve un año ocupa poco y es lo único que cubre este escenario. No sirve para recuperarse rápido, sirve para que exista un punto anterior al daño.
Qué hacer en los primeros minutos de un incidente
El orden de las acciones en un fallo grave importa más que la rapidez, porque varios errores comunes ocurren justo en los primeros minutos, empeorando algo que era recuperable.
- Para de escribir antes de investigar. Si hay sospecha de datos dañados, cada minuto que el sistema sigue aceptando escrituras complica la recuperación. Poner el sitio en mantenimiento es incómodo y casi siempre correcto.
- No restaures encima del original. Restaura a un sitio nuevo y compara. Escribir la copia sobre los datos actuales destruye la única evidencia de qué pasó y, si la copia resulta estar mal, no queda nada.
- Anota la hora de cada cosa. Cuándo empezó, cuándo se notó, qué se hizo. Durante el incidente parece una pérdida de tiempo, y después es lo único que permite entender qué ocurrió.
- Decide con las dos cifras delante. Saber cuántos datos se pierden restaurando desde cada copia disponible convierte una decisión angustiosa en una comparación entre opciones concretas.
Nada de esto se improvisa bien bajo presión, y esa es justamente la razón de escribirlo antes. Un documento de media página, guardado fuera del sistema que puede caerse, es suficiente.
Qué pedirle a una IA, y qué revisar tú
Generar un script de copias es una de las tareas donde un asistente rinde bien: el patrón es conocido y el resultado suele funcionar a la primera. El riesgo no está en el script, está en lo que da por hecho.
Un script típico copia la base de datos y nada más, porque solo se le habló de la base. No incluye los archivos de los usuarios, no verifica que el resultado sea válido, no borra copias antiguas y no avisa si falla. Los cuatro huecos tienen la misma consecuencia: durante meses todo parece correcto.
El que más pesa es el aviso. Un proceso de copia que falla en silencio es peor que no tenerlo, porque produce confianza sin respaldo. Pedir explícitamente que notifique tanto el éxito como el fallo cambia esa situación por completo.
Y la pregunta que conviene hacer al final no es sobre el script de copia, sino sobre el de vuelta: pide el procedimiento de restauración paso a paso, con los comandos concretos. Si esa parte no se puede escribir con claridad, la estrategia todavía no está terminada.