En los equipos donde el uso de asistentes se generalizó, el primer síntoma no fue un problema de calidad del código. Fue que los pull requests empezaron a llegar más grandes, más seguidos, y con descripciones que sonaban a resumen de lo que ya se veía en el diff.
La revisión entre compañeros se diseñó para un mundo donde escribir costaba tiempo y eso limitaba de forma natural cuánto llegaba a la cola. Ese freno ya no existe, y las reglas del equipo tienen que ajustarse a mano.
El problema no es el código, es el caudal
Conviene separar dos discusiones que suelen mezclarse. Una es si el código generado tiene más errores, que depende mucho del caso. La otra es qué le pasa a un proceso de revisión cuando entra el triple de material.
La capacidad de revisar no ha cambiado: sigue siendo la atención de una persona leyendo con cuidado, y eso tiene un límite conocido de unos cientos de líneas por sesión antes de que la calidad de la lectura caiga en picado.
Cuando la producción se multiplica y la revisión no, ocurre lo esperable: los PR se aprueban más rápido, con menos comentarios, y el sello de aprobación deja de significar lo que significaba.
Esa es la degradación real, y no se arregla revisando más rápido. Se arregla cambiando qué llega a la cola y qué se espera de cada lado.
Quién responde por el código
Hay una pregunta que conviene resolver explícitamente en el equipo, porque si no se resuelve se resuelve sola y mal.
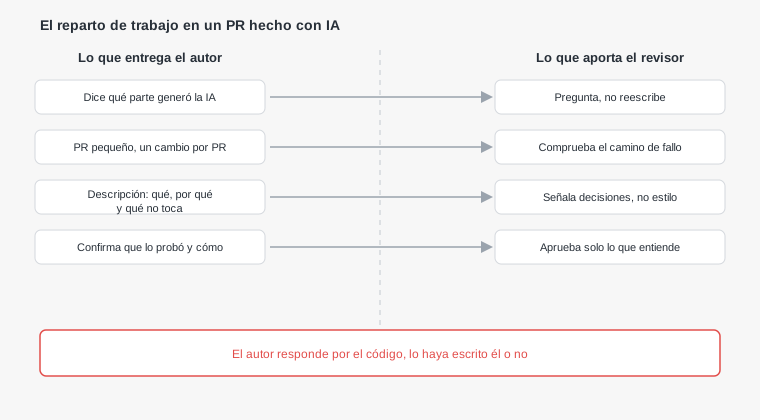
La regla que sostiene todo lo demás es que el autor del PR responde por el código, lo haya escrito él o no. Firmar un PR es afirmar que entiendes lo que hace y que lo has comprobado.
Sin esa regla aparece un reparto tóxico de responsabilidad: el autor no lo escribió del todo, el revisor no lo escribió en absoluto, y cuando falla en producción no hay nadie que pueda explicar por qué está hecho así.
La consecuencia práctica es incómoda pero necesaria: si no entiendes una parte de tu propio PR, no la mandas a revisión. La arreglas, la simplificas o la preguntas antes.
Qué debe entregar el autor
La mayor parte de la mejora en revisión no está en el revisor, está en lo que recibe. Cuatro cosas cambian el resultado más que cualquier lista de comprobación.
Un PR pequeño. Un cambio por PR. Si la funcionalidad es grande, se parte en pasos que funcionen por separado. Esto es más importante que antes, porque generar mil líneas de golpe ahora es trivial y revisarlas sigue sin serlo.
Una descripción que aporte lo que el diff no dice. El diff ya cuenta qué cambió. La descripción debe contar por qué, qué alternativas se descartaron, y qué partes del sistema no se tocan a propósito.
La indicación de qué se generó. No como confesión, sino como información útil: le dice al revisor dónde mirar con más atención, igual que decir "esta parte la copié de otro módulo" ya lo hacía.
Cómo se comprobó. Qué pruebas se ejecutaron, qué caso se probó a mano, qué no se pudo comprobar. Un PR que dice qué quedó sin verificar es mucho más útil que uno que afirma que todo funciona.
Una plantilla que cabe en la cabeza
Las plantillas de PR largas se rellenan con desgana. Una corta con cuatro campos se rellena de verdad.
## Que cambia
Una o dos frases. El diff cuenta el resto.

## Por que asi
La decision que no se deduce del codigo, y que se descarto.

## Que no toca
Comportamiento que debe seguir igual despues de este cambio.

## Como lo comprobe
Pruebas ejecutadas, caso probado a mano, y lo que quedo sin comprobar.
# Dejarla en el repositorio para que aparezca al abrir cada PR
mkdir -p .github
$EDITOR .github/pull_request_template.md
git add .github/pull_request_template.md
git commit -m "plantilla de PR con los cuatro campos minimos"El cuarto campo es el que más valor aporta y el que más cuesta adoptar, porque obliga a admitir lo que no se probó.
El tamaño del PR es la palanca principal
Si un equipo solo pudiera cambiar una cosa de su proceso, esta sería la de mayor efecto.
Un PR de cien líneas recibe comentarios concretos. Uno de mil recibe un visto bueno. No es falta de rigor, es que leer mil líneas con atención cuesta más de una hora y nadie la tiene a media tarde.
La forma de trocear que funciona con cambios grandes es separar lo mecánico de lo sustantivo. Un PR que solo mueve archivos o renombra se revisa en dos minutos; otro que cambia comportamiento en doscientas líneas se revisa de verdad. Mezclados, el cambio de comportamiento se pierde entre el ruido.
# Ver el tamano real antes de abrir el PR
git diff --stat main...HEAD | tail -1

# Separar cambios mecanicos de cambios de comportamiento
git diff --stat main...HEAD -- ':!*.lock' ':!*.snap'

# Revisar ignorando reformateos y movimientos de bloques
git diff -w -M main...HEAD
Las dos últimas opciones son las que más tiempo ahorran al revisar: ignoran los cambios de espacios y detectan código movido en lugar de mostrarlo como borrado más añadido.
Qué mira el revisor primero
El orden de lectura importa porque la atención se agota. Lo que se mira al final se mira peor.
Lo primero no es el código sino el alcance: qué archivos toca y si alguno sobra. Un PR que iba de validación de formularios y toca la configuración de la base de datos tiene algo que explicar antes de entrar en el detalle.
Después, las dependencias nuevas. Añadir una librería es una decisión con consecuencias a años vista, y suele colarse en una línea de un archivo que nadie lee.
# Que dependencias entran o cambian en este PR
git diff main...HEAD -- package.json composer.json requirements.txt pyproject.toml

# Archivos tocados, ordenados por volumen de cambio
git diff --stat main...HEAD | sort -t'|' -k2 -rn | head -20
Luego los cambios de esquema o de datos: migraciones, campos nuevos, valores por omisión. Es donde el error es más caro de revertir.
Y solo después, la lógica. Con la atención puesta en el camino de fallo, que es donde el código generado es más flojo: qué pasa cuando la llamada externa no responde, cuando el valor es nulo, cuando la operación llega dos veces.
Comentar sin reescribir
Hay una tentación específica cuando el revisor sospecha que el código es generado: reescribirlo él en el comentario. Conviene resistirla por dos razones.
La primera es que priva al autor de la oportunidad de entender su propio cambio, que es justo lo que se está intentando reforzar. Si el revisor aporta la solución, el autor la pega y sigue sin comprender por qué la anterior estaba mal.
La segunda es que un comentario en forma de pregunta descubre cosas que una corrección no. "¿Qué pasa si llega vacío?" a veces revela que el autor ya lo pensó y hay una validación más arriba, y a veces revela que no.
Los comentarios que más rinden señalan una consecuencia y dejan la solución abierta: qué ocurre con datos reales, qué pasa si dos peticiones llegan a la vez, qué se rompe si este servicio tarda diez segundos.
Y hay una categoría que conviene retirar del todo: el estilo. Comillas, orden de importaciones, saltos de línea. Eso lo decide una herramienta automática antes de la revisión, no una persona.
Lo que no aparece en el diff
Un PR se lee como una lista de cambios, y eso deja fuera una clase entera de problemas que solo se ve pensando en lo ausente.
Lo más común es el código que debería haber cambiado y no cambió: una validación nueva en un endpoint pero no en el otro que hace lo mismo, un caso contemplado en la creación pero no en la edición.
Después está lo que ya existía y ahora está duplicado. Sin el proyecto entero en contexto, un asistente escribe la función de utilidad que ya tenías en otro archivo, con otro nombre y comportamiento ligeramente distinto.
# Buscar si la funcion nueva ya existia con otro nombre
git grep -n "formatearImporte\|formatMoney\|formatearMoneda"

# Ver quien mas llama al codigo que este PR modifica
git grep -n "calcularDescuento" -- '*.php' '*.js'
Y está la documentación que quedó desfasada: el README que sigue describiendo el comportamiento anterior, el ejemplo de la API que ya no corresponde con la respuesta real.
Cuando el revisor tampoco entiende la parte difícil
Es una situación frecuente y casi nunca se admite en voz alta: el PR contiene algo que ninguno de los dos domina.
La salida mala es aprobar confiando en que el autor sabrá. La salida buena tiene dos variantes, según lo que esté en juego.
Si el cambio es reversible y acotado, se puede aprobar diciendo explícitamente qué parte no se revisó. Un comentario del tipo "no he podido valorar la parte de concurrencia" es información útil y honesta, y deja rastro de dónde mirar si algo falla.
Si el cambio es difícil de revertir, lo que toca es buscar a quien sí lo domina, aunque eso retrase el PR. La alternativa es que la decisión entre en el sistema sin que nadie la haya evaluado.
Conviene que el equipo lo diga explícitamente: no saber es un motivo legítimo para pedir otra revisión, no una señal de debilidad.
Lo que debe pasar antes de la revisión humana
Buena parte de lo que se comenta en las revisiones no debería llegar a ellas. Formato, importaciones sin usar, variables no utilizadas, secretos filtrados, tipos que no cuadran: todo eso lo detecta una herramienta.
Poner esos filtros antes libera la atención del revisor para lo que solo una persona puede juzgar: si la solución tiene sentido para este sistema y este equipo.
# Lo que deberia pasar antes de que un humano abra el PR
npm run lint && npm test          # o el equivalente del proyecto
git diff --check                  # espacios al final y conflictos sin resolver
Si el equipo tiene un solo revisor disponible y la cola crece, este es el punto donde invertir primero.
Medir si la revisión sigue funcionando
La degradación del proceso es gradual y no se nota desde dentro, así que conviene tener dos o tres señales objetivas.
La más simple es el tamaño medio de los PR. Si sube mes a mes, la revisión está empeorando aunque nadie lo perciba.
La segunda es la proporción de PR aprobados sin un solo comentario. Algunos son genuinamente triviales; si son la mayoría, el sello ya no significa nada.
# Tamano medio de los cambios en los ultimos 50 commits de integracion
git log --merges -50 --format=%H | while read h; do
  git show --stat --format= "$h" | tail -1
done
La tercera, y la más reveladora, es preguntar en la retrospectiva quién sería capaz de explicar cómo funciona la parte que se integró el mes pasado. Si nadie levanta la mano, el código entró sin revisión real aunque tenga dos aprobaciones.
Qué se le escapa a una IA con esto
Los asistentes de revisión automática de PR han mejorado mucho y siguen teniendo un punto ciego característico.
Comentan bien lo local: un bucle ineficiente, una comprobación que falta, una excepción que se traga. Eso es real y ahorra trabajo.
No comentan lo que depende del resto del sistema, que es donde están los problemas caros: que esta solución duplica algo que ya existe, que contradice una convención del equipo, que esta abstracción no va a aguantar el caso que todos saben que viene en dos meses.
Tampoco distinguen lo importante de lo accesorio. Producen veinte comentarios del mismo tono, y el que señala un problema de seguridad queda al lado del que sugiere renombrar una variable. En un PR grande, eso entrena al equipo a ignorarlos todos.
La configuración que los hace útiles es reducirlos a las categorías donde aciertan y silenciar el resto, dejando el juicio sobre diseño y encaje para la persona que conoce el sistema.