La discusión sobre desarrollo guiado por pruebas tiene algo de religión. Quienes lo practican hablan de él como de un cambio de vida, quienes no lo practican lo describen como un ritual que duplica el trabajo, y ambos grupos suelen tener razón sobre los proyectos concretos en los que se formaron su opinión.
Lo útil no es tomar partido, sino entender qué cambia exactamente al escribir la prueba antes o después, porque las consecuencias son distintas de lo que suele decirse.
Qué es exactamente TDD
El método consiste en un ciclo corto que se repite muchas veces por hora, no en escribir todas las pruebas al principio.
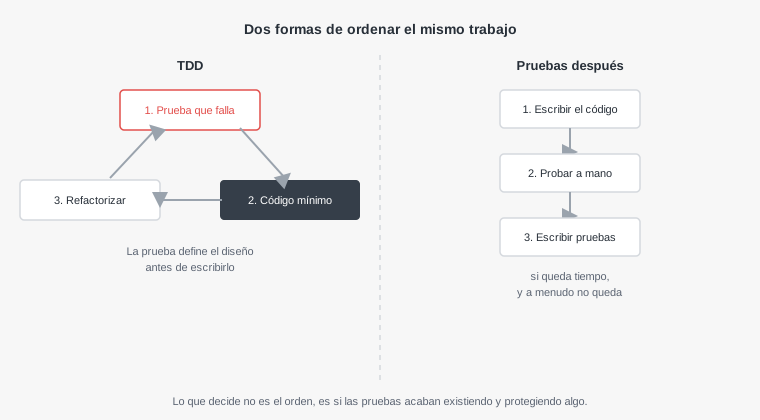
Primero se escribe una prueba pequeña para un comportamiento que todavía no existe, y se comprueba que falla. Después se escribe el código mínimo para que pase, sin adelantarse. Por último se limpia el código con la tranquilidad de que la prueba avisará si algo se rompe. Y vuelta a empezar con el siguiente comportamiento.
El paso que más se salta, y el más importante, es ver fallar la prueba. Una prueba que nunca se ha visto fallar puede estar mal escrita y pasar siempre, y no hay forma de saberlo sin ese paso.
El beneficio que no es tener pruebas
El argumento habitual a favor es que al final hay pruebas para todo. Es verdad, y no es lo más importante.
La ventaja de fondo es que la prueba obliga a pensar la interfaz antes que la implementación. Para escribir la prueba hay que decidir cómo se llama la función, qué recibe y qué devuelve, antes de pensar cómo funciona por dentro. Eso produce código más fácil de usar, porque se diseñó desde el punto de vista de quien lo usa.
La segunda ventaja es que obliga a que el código sea probable. Un código que depende de todo, que accede a la base de datos desde cualquier sitio y que mezcla cálculo con presentación es muy difícil de probar, y escribir la prueba primero hace ese problema evidente en el minuto uno en lugar de tras mil líneas.
La tercera es menos obvia: el ciclo corto hace que siempre se esté a pocos minutos de un estado que funciona. Cuando algo se tuerce, se deshace el último paso y se vuelve a intentar, en lugar de depurar una hora de cambios acumulados.
Lo que cuesta de verdad
El precio existe y conviene no minimizarlo, porque es la razón de que la mayoría de los equipos no lo practique.
Al principio es más lento, claramente. Pensar la prueba primero exige una forma de trabajar que no es natural, y durante semanas se nota la fricción.
Funciona mal cuando no sabes qué quieres construir. Si estás explorando, probando si una librería sirve o averiguando cómo se comporta una API externa, escribir pruebas para algo cuya forma cambiará cinco veces en una hora es trabajo que se tira.
Y puede producir un exceso de pruebas muy acopladas a la implementación: pruebas que comprueban cada paso interno, que se rompen con cualquier refactorización aunque el comportamiento no cambie, y que acaban siendo un freno para cambiar el código en lugar de una red para hacerlo.
Pruebas después: lo que se gana y lo que se arriesga
Escribir primero el código y después las pruebas es lo que hace la mayoría, y tiene ventajas reales que conviene reconocer.
Permite explorar libremente, llegar a una solución que funciona y entonces asegurarla. Para código cuya forma no está clara, es el orden natural.
Su riesgo no está en el orden, sino en lo que suele ocurrir después. El código funciona, se probó a mano, hay prisa por la siguiente tarea, y las pruebas quedan para luego. Luego no llega.
Hay un segundo riesgo más sutil: las pruebas escritas después tienden a comprobar lo que el código ya hace, no lo que debería hacer. Si la función tiene un error, la prueba escrita mirando la función a menudo incorpora ese mismo error como comportamiento esperado.
Las dos, comparadas donde importa
| TDD | Pruebas después | |
|---|---|---|
| Las pruebas acaban existiendo | Siempre | Si hay disciplina |
| Influye en el diseño | Mucho | Poco |
| Velocidad al principio | Más lenta | Más rápida |
| Para explorar algo nuevo | Incómodo | Natural |
| Riesgo de probar el error como correcto | Bajo | Alto |
| Riesgo de pruebas acopladas a la implementación | Alto si se abusa | Medio |
| Dónde encaja mejor | Lógica con reglas claras | Exploración y prototipos |
La fila del riesgo de probar el error es la que más consecuencias tiene y la que menos se discute. Una prueba escrita antes describe la intención; una escrita después, con frecuencia, describe el accidente.
Dónde TDD rinde claramente
Hay un tipo de código donde escribir la prueba primero es casi siempre la mejor opción, incluso para quien no lo practica en general.
- Cálculos con reglas de negocio: precios, impuestos, descuentos, comisiones. Los casos se conocen de antemano y cada uno es una prueba.
- Corrección de errores: antes de arreglar un fallo, escribir la prueba que lo reproduce. Confirma que se entendió el problema y garantiza que no vuelve.
- Validaciones y transformaciones con muchos casos límite: fechas, formatos, rangos.
- Código que otros van a usar: una librería o un módulo compartido, donde pensar la interfaz primero evita cambiarla después.
El segundo punto merece énfasis porque es la puerta de entrada más fácil: no exige cambiar la forma de trabajar en general, y cada error corregido deja una prueba que protege para siempre.
La prueba que reproduce el error
Es la práctica con mejor relación esfuerzo-beneficio de todo este tema, y conviene describirla con precisión.
Cuando alguien reporta un fallo, antes de tocar el código se escribe una prueba que lo reproduce y se comprueba que falla. Solo entonces se corrige, y se comprueba que la prueba pasa.
// Reporte: un pedido con cupón del 100% genera un total negativo
public function test_cupon_del_cien_por_cien_deja_el_total_en_cero(): void
{
    $pedido = new Pedido(subtotal: 50.00, envio: 5.00);
    $pedido->aplicarCupon(new Cupon(porcentaje: 100));

    $this->assertSame(5.00, $pedido->total());   // falla hoy: devuelve -45.00
}
# Ejecutar solo esa prueba mientras se corrige
vendor/bin/phpunit --filter test_cupon_del_cien_por_cien
npx jest -t "cupón del 100%"
pytest -k "cupon_del_cien"Hay tres ganancias en este gesto. Se confirma que el error se entendió, porque la prueba falla por el motivo correcto. Se sabe cuándo está resuelto sin probar a mano. Y el mismo error no puede volver sin que alguien se entere.
Comprobar que las pruebas protegen de verdad
Tanto si se escriben antes como después, hay una técnica que responde a la pregunta que ninguna cifra de cobertura responde: si el código se rompiera, ¿lo detectarían estas pruebas?
Se llama prueba de mutación. Una herramienta introduce pequeños cambios deliberados en el código, como invertir una condición o cambiar un número, y comprueba si alguna prueba falla. Si ninguna falla, esas pruebas no protegen esa línea, aunque la ejecuten.
# JavaScript / TypeScript
npx stryker run

# PHP
vendor/bin/infection --threads=4

# Python
mutmut run && mutmut results
Es una técnica lenta y no conviene ejecutarla en cada cambio, pero pasarla una vez sobre el módulo más importante suele revelar pruebas que parecían completas y dejaban pasar errores evidentes.
Simular con moderación
Hay un punto donde TDD y las pruebas después fallan de la misma manera, y es la principal fuente de pruebas inútiles: simular demasiado.
Para probar una pieza de forma aislada hace falta sustituir lo que toca, la base de datos, un servicio externo, el reloj, por versiones controladas. Es necesario en su justa medida. El problema aparece cuando se simula todo, incluidas las piezas propias que no tienen ningún motivo para no usarse de verdad.
Una prueba con cinco simulaciones acaba comprobando que la función llama a cinco cosas en cierto orden. No comprueba que el resultado sea correcto, y se rompe cada vez que alguien reorganiza el código aunque todo siga funcionando.
La regla que funciona es simular solo en los bordes del sistema: lo que es lento, lo que no controlas o lo que tiene efectos fuera, como enviar un correo o cobrar. Todo lo que es código propio y rápido, usarlo tal cual.
// Mal: comprueba llamadas, no resultados
expect(calculadora.aplicarDescuento).toHaveBeenCalledWith(50, 10);

// Bien: comprueba el resultado, y solo se simula el borde externo (la pasarela)
pasarela.cobrar = jest.fn().mockResolvedValue({ ok: true });
const pedido = await checkout(carrito, cupon, pasarela);
expect(pedido.total).toBe(45);
Si para escribir una prueba hacen falta muchas simulaciones, eso no es un problema de la prueba: es una señal de que el código mezcla demasiadas responsabilidades, y es justo la información que TDD pretende hacer visible pronto.
Una forma práctica de decidir
La elección no tiene por qué ser global. Lo que funciona en la mayoría de los equipos pequeños es mezclar según el tipo de trabajo.
Para explorar, escribir primero el código, sin culpa, y tirar lo que no sirva. Cuando la forma se asiente, escribir las pruebas antes de dar la tarea por terminada, no después.
Para la lógica de negocio con reglas conocidas, escribir la prueba primero, porque los casos ya están claros y el diseño sale mejor.
Y para cada error reportado, siempre la prueba que lo reproduce antes de corregirlo. Esa sola regla, aplicada con constancia, construye con el tiempo una batería de pruebas justo donde el código ha demostrado ser frágil.
Qué se le escapa a una IA con esto
El trabajo con asistentes tiene una interacción curiosa con este tema: pedir el código y las pruebas a la vez produce pruebas escritas mirando el código, que es exactamente el riesgo de las pruebas después, llevado al extremo.
Si la función tiene un error, las pruebas generadas junto a ella tienden a asumir ese error como correcto. Todas pasan, la cobertura es alta y el fallo sigue ahí.
Una forma de invertirlo que funciona bien es pedir primero solo las pruebas, a partir de una descripción del comportamiento esperado y sin mostrar ninguna implementación. Revisarlas, comprobar que fallan, y solo entonces pedir el código que las haga pasar.
Y conviene no aceptar nunca que se modifique una prueba para que pase, salvo que la prueba estuviera mal. Cuando una prueba falla tras un cambio, la pregunta útil es qué comportamiento se rompió, no cómo hacer que la prueba vuelva a verde.